
Se conosci la filosofia DevOps avrai sicuramente sentito parlare di DevSecOps. Si tratta di un approccio alla sicurezza che sta prendendo sempre più piede, in linea con la crescente consapevolezza da parte delle grandi imprese delle minacce alla security. Abbiamo recentemente parlato di come introdurre DevSecOps. In questo articolo, vedremo il concetto di Cloud DevSecOps e ci concentreremo sui vantaggi e sugli strumenti utili. Partiamo da una definizione.
Cos’è il Cloud DevSecOps?
Il Cloud DevSecOps è l’integrazione nativa delle pratiche di sicurezza all’interno del ciclo di vita dello sviluppo software in ambienti cloud. Questo approccio automatizza i controlli di security nelle pipeline CI/CD, trasformando la sicurezza da un ostacolo finale a un requisito condiviso fin dalle prime fasi di progettazione e rilascio.
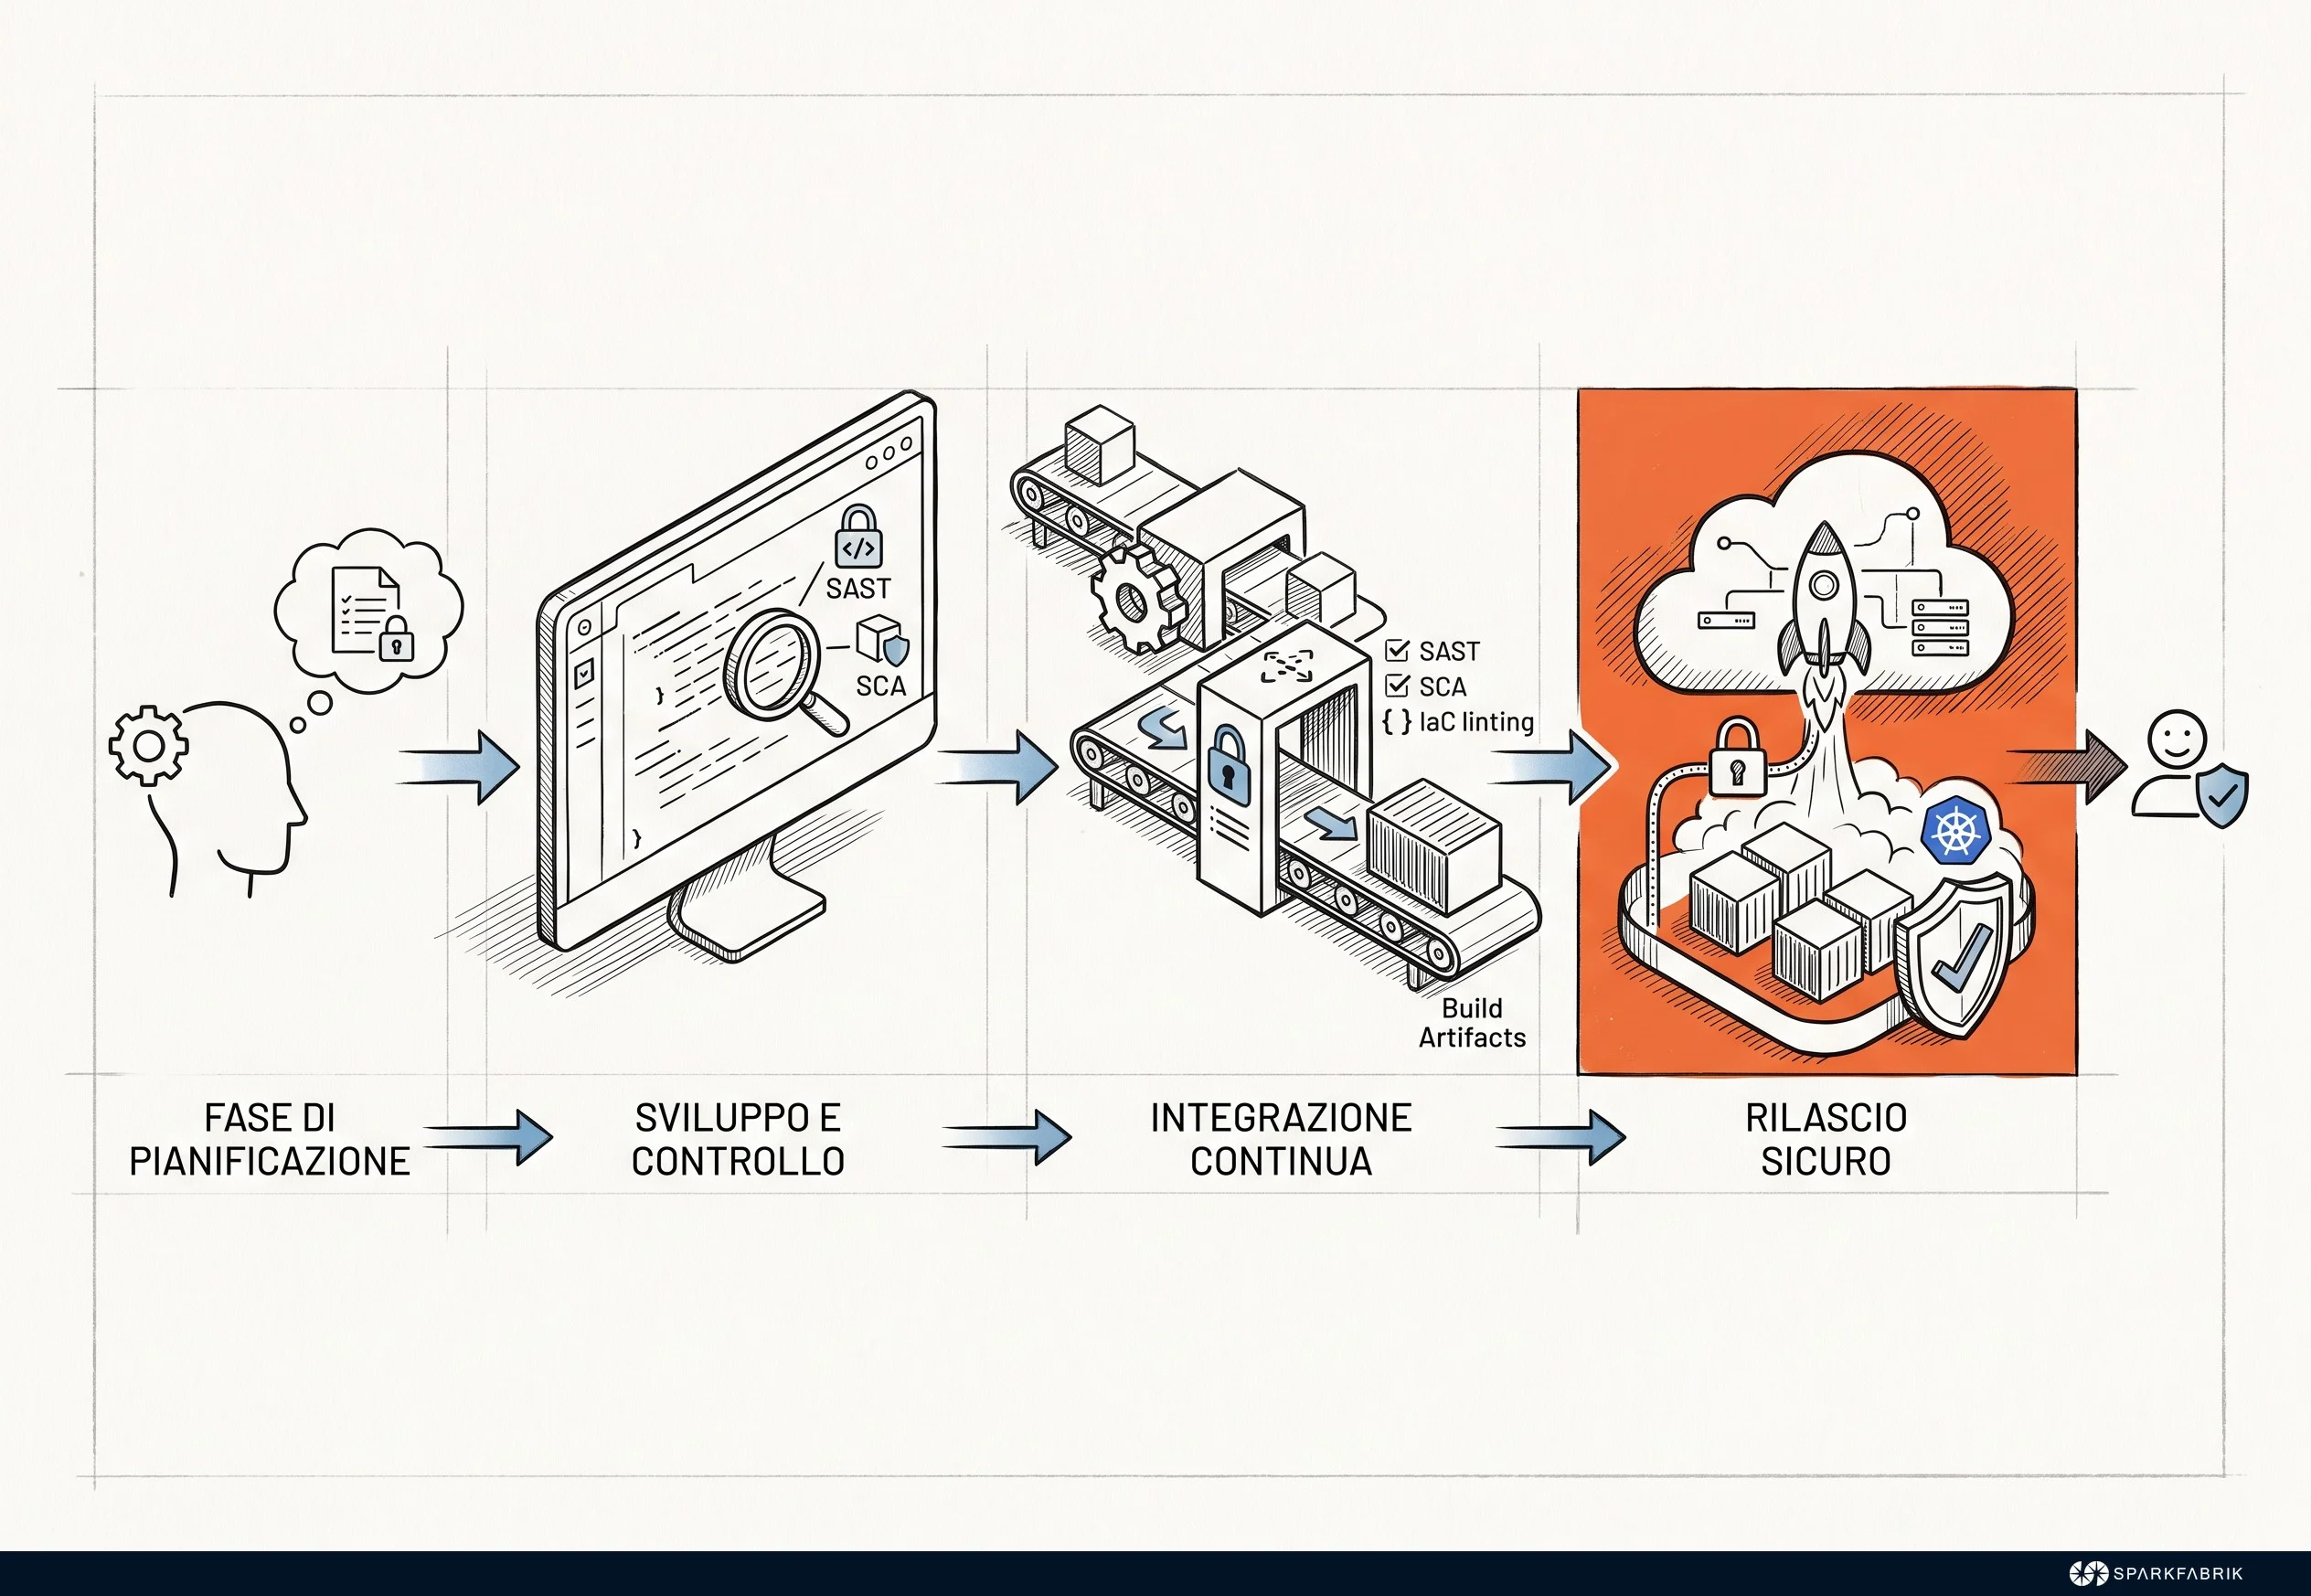
DevSecOps è il risultato dell’integrazione della sicurezza all’interno della metodologia DevOps, e calato nel contesto specifico del Cloud. Questo approccio cerca di avvicinare il più possibile le pratiche di sicurezza alla fase di delivery, invece di isolarle in una fase separata e successiva a ogni ciclo di rilascio del software.
Il beneficio principale del modello DevSecOps è che rende la security un requisito noto a tutti gli stakeholder e non solo agli specialisti di settore e a un team dedicato. Se tutti sono, in diversa misura, responsabili della sicurezza, l’affidabilità e la qualità del software prodotto non potrà che migliorare.
I vantaggi di DevSecOps
I principali vantaggi di un modello DevSecOps sono la velocità con cui è possibile iterare sul software prodotto e la velocità con cui è possibile migliorare il punteggio della sicurezza applicativa che ne deriva. (Sia che si tratti di applicazioni Cloud Native o meno.) Questi due benefici, tuttavia, non vengono innescati in una fase specifica, ma piuttosto sono la conseguenza di pratiche che portano vantaggi riscontrabili in tutto il processo di sviluppo, vediamole di seguito.
Delivery di software rapida ed efficiente in termini di costi
Quando il software viene sviluppato in un ambiente che esula dai principi DevSecOps, i problemi di sicurezza possono portare ad enormi ritardi. Anticipare alla fase di coding i feedback atti alla verifica della security posture del codice riduce l’overhead di una risoluzione tardiva.
Sicurezza migliorata e maggiore proattività
L’approccio “shift left” aumenta la proattività dei team DevOps. Vedendo immediatamente le metriche relative alla sicurezza, i team di sviluppo vengono progressivamente sensibilizzati a risolvere potenziali problemi prima di considerare il codice “pronto”.
Applicazione di patch alle vulnerabilità di sicurezza accelerata
Uno scanning continuo e proattivo permette di individuare e sistemare eventuali vulnerabilità/CVE con un ritmo nettamente più veloce rispetto ad un meccanismo di analisi pianificato.
Automazione compatibile con lo sviluppo moderno
Tutti i principali strumenti sono integrabili all’interno delle pipeline di Continuous Delivery e Continuous Integration: un job SAST che gira su ogni pull request, la scansione SCA delle dipendenze in fase di build, un linter IaC (tipo Checkov o tfsec) prima dell’apply su Terraform. Con GitHub Actions o GitLab CI questi controlli girano in parallelo agli unit test e diventano quality gate espliciti, che bloccano il merge quando emerge una CVE critica o un bucket configurato come pubblico.
Una solida consulenza DevOps e Platform Engineering permette di introdurre ed orchestrare questi controlli in modo fluido.
Un processo ripetibile e adattivo
L’estensibilità degli strumenti e il determinismo garantito dalle soluzioni di mercato permette di ottimizzare il livello di sensibilità degli strumenti rispetto alle segnalazioni più critiche secondo gli standard e le policy dell’organizzazione. In questo modo si ha la certezza che la stessa porzione di codice, analizzata in istanti differenti, venga classificata nello stesso modo.
DevSecOps vs SecDevOps: qual è la differenza?
Il valore di una strategia di application lifecycle management che include DevSecOps è ormai indubbio. Tuttavia, all’interno dell’industria IT, sta emergendo un nuovo punto di vista che mette in discussione la priorità con cui i concetti di “security” si insediano all’interno della vita di un prodotto.
Il termine SecDevOps estremizza lo shift-left, andando a definire una metodologia di delivery di applicazioni che prima di qualsiasi altra considerazione (tecnologica, di design o di metodo) si pone la domanda di quanto una determinata scelta impatti la security. La differenza, dunque, non è tanto nella qualità del software prodotto, ma più che altro nel percorso con cui si arriva a prendere una decisione.
Per semplificare possiamo dire che nel modello DevSecOps l’accento è sull’automazione, in SecDevOps, invece, l’accento è sulla pianificazione dello sviluppo.
Cloud DevSecOps best practice
Così come per le best practice DevOps, anche per DevSecOps ci sono delle linee guida che ne semplificano l’adozione e ne incrementano i benefici per tutti gli stakeholder coinvolti. Abbiamo descritto nel dettaglio sei di queste linee guida all’interno dell’articolo DevSecOps: 6 principi per introdurlo in azienda. Gli stessi principi valgono anche nel contesto più specifico di Cloud DevSecOps e sono:
- Analisi Del Codice
- Testing Automatizzato
- Change Management
- Monitoraggio Della Compliance
- Threat Investigation
- Formazione Del Personale
Ti consigliamo di approfondire nell’articolo sopra citato, in cui entriamo in maggior dettaglio su ogni voce.
Nei contesti Cloud resta centrale la Cloud Security Automation, cioè automatizzare governance e monitoraggio dei workload attivati on-Cloud. A questa si affianca oggi la Software Supply Chain Security: generare una SBOM a ogni build, verificare la firma dei container con Sigstore/cosign prima dell’admission nel cluster e analizzare in continuo le dipendenze Open Source.
Un’altra pratica importante, è il “tagging” delle risorse, ovvero l’associazione di metadati personalizzati (in maniera automatica tramite strumenti e script) alle istanze dei workload applicativi o infrastrutturali che vengono attivati. Questi “tag” possono poi essere usati come indicatori o filtri per attività di controllo in fase di audit di sicurezza.
La tabella seguente sintetizza le pratiche essenziali della Software Supply Chain Security.
| Pratica | Obiettivo | Strumenti tipici |
|---|---|---|
| Generazione SBOM ad ogni build | Tracciare tutte le componenti e dipendenze del software | Syft, CycloneDX |
| Firma e verifica dei container | Garantire l’integrità e la provenienza delle immagini prima del deploy | Sigstore, Cosign |
| Analisi continua delle dipendenze Open Source | Individuare vulnerabilità note e componenti non aggiornate | Dependabot, Trivy, Snyk |
| Policy di admission control | Bloccare il deploy di artefatti non conformi o non firmati | OPA/Gatekeeper, Kyverno |
Dai tag delle risorse alla SBOM: tracciare di cosa è fatto il software
Il tagging risponde alla domanda “quali workload sto eseguendo”. Resta aperta la domanda più scomoda: “di cosa sono fatti”. La quota maggioritaria del codice che finisce in produzione non è scritta dal team che lo rilascia, ma arriva da dipendenze open source transitive tirate dentro da un package.json, un go.mod o un requirements.txt.
Log4Shell (CVE-2021-44228) e la backdoor in xz-utils (CVE-2024-3094) hanno mostrato lo stesso punto debole: nel momento della disclosure, la maggior parte delle organizzazioni non era in grado di rispondere in poche ore alla domanda “questa libreria è dentro qualcuno dei miei artefatti?”.
La SBOM (Software Bill of Materials) serve esattamente a questo: un inventario machine-readable di componenti, versioni, licenze e relazioni di dipendenza, prodotto come artefatto della build. I due formati che contano operativamente sono SPDX (standardizzato come ISO/IEC 5962:2021) e CycloneDX (OWASP, adottato anche come ECMA-424); entrambi sono supportati dai principali generatori, da Syft a Trivy fino ai plugin nativi di Maven e npm.
La spinta normativa non è teorica: il Cyber Resilience Act1, in vigore dal dicembre 2024, richiederà ai produttori di prodotti con elementi digitali di mantenere una distinta dei componenti software e di gestire le vulnerabilità lungo il ciclo di vita, con obblighi di segnalazione a partire da settembre 2026 e piena applicazione da dicembre 2027. Abbiamo approfondito il ruolo centrale della SBOM nel Cyber Resilience Act nella nostra serie dedicata al regolamento europeo.

Sul fronte dell’integrità della pipeline, il framework di riferimento è SLSA2 (Supply-chain Levels for Software Artifacts), arrivato alla versione 1.0 con la track Build articolata su livelli progressivi:
| Livello SLSA (Build track) | Requisito chiave | Cosa impedisce concretamente |
|---|---|---|
| L0 | Nessuna garanzia | Nulla: l’artefatto non è tracciabile |
| L1 | Provenance generata e disponibile | Rilasci “misteriosi” senza origine documentata |
| L2 | Provenance firmata da un build service ospitato | Manomissione dell’artefatto dopo la build |
| L3 | Build platform irrobustita, provenance non falsificabile | Compromissione del builder e injection in fase di build |
Nella nostra esperienza, il salto di valore non sta nel generare la SBOM, che è ormai una riga di configurazione in pipeline, ma nel firmarla, conservarla come attestazione accanto all’immagine e verificarla in fase di ammissione sul cluster. Uno schema di riferimento che adottiamo nei progetti Kubernetes è questo:
CycloneDX / SPDX] B --> D[Provenance in-toto
SLSA] C --> E[Firma con cosign
keyless via OIDC] D --> E E --> F[(Registry OCI
immagine + attestazioni)] F --> G{Admission control
Kyverno / Gatekeeper} G -->|Firma e provenance valide| H[Deploy in cluster] G -->|Verifica fallita| I[Deploy bloccato] F --> J[Scansione continua
Grype / Trivy] J --> K[Triage con VEX] K --> A
Il punto meno ovvio riguarda il rumore. Una SBOM completa su un’immagine base non minimale può generare centinaia di CVE segnalate, la maggior parte delle quali non raggiungibili dal codice applicativo: pacchetti presenti nel filesystem ma mai eseguiti, oppure vulnerabilità in code path non invocati. Senza un meccanismo di eccezione documentata i team smettono semplicemente di guardare i report.
Per questo affianchiamo alla SBOM le attestazioni VEX (Vulnerability Exploitability eXchange, nella variante OpenVEX): permettono di dichiarare in modo verificabile che una vulnerabilità non è sfruttabile in quel contesto specifico, mantenendo la tracciabilità della decisione per gli audit successivi. Un altro accorgimento che riduce drasticamente la superficie da giustificare è partire da immagini distroless o Wolfi, dove l’assenza di shell e package manager taglia alla radice buona parte dei componenti inventariati.
La SBOM, infine, ha senso solo se è interrogabile. Un file JSON archiviato nel registry e mai riletto non aiuta nessuno alle tre di notte durante una zero-day: serve un indice centralizzato (Dependency-Track e Guac sono le opzioni open source più mature) che consenta di rispondere in una query a “quali servizi in produzione contengono la versione X di questa libreria”, correlando l’inventario dei componenti con i tag delle risorse descritti sopra.
DevSecOps tools
Forse conosci già alcuni dei più famosi DevOps tools, puoi dire lo stesso per l’approccio DevSecOps? Anche in questo caso esistono strumenti in grado di aiutare un’organizzazione ad adottare le pratiche DevSecOps che abbiamo appena ricordato. Per Atlassian, la classificazione di questi strumenti si orienta in base alle varie fasi del ciclo DevSecOps, nel dettaglio:
- Plan : tool di thread modelling e analisi degli impatti su determinati change
- Build : strumenti di analisi statica (SAST) e dinamica (DAST) del codice
- Test : analisi dinamica del codice (DAST)
- Deploy : strumenti di penetration testing e chaos engineering
- Operate : Log collection, Web Application Firewall e Runtime Application Self Protection (RASP)
- Monitor : security information and event management (SIEM)
Tra gli strumenti per DevSecOps troviamo Checkov3, nato in Bridgecrew e oggi mantenuto da Palo Alto Networks all’interno dell’ecosistema Prisma Cloud4, per la scansione delle configurazioni e dell’IaC.
Poi c’è Trivy5, uno degli scanner di vulnerabilità e configurazione errata più conosciuti, e KICS6, una soluzione open source per l’analisi del codice statico della IaC. Un altro DevSecOps tool è SonarQube7, che oltre alla parte di scan dei container, vulnerabilità di dipendenze e IaC è in grado di fare un’analisi anche sul codice.
Sul fronte supply chain, Snyk8 copre dipendenze e container, mentre Syft9 e Grype10 generano SBOM e le confrontano con i database di vulnerabilità; per il runtime dei cluster Kubernetes il riferimento è Falco11, progetto graduato CNCF per il rilevamento di comportamenti anomali.
| Categoria | Strumento | Funzione principale |
|---|---|---|
| SAST | SonarQube | Analisi statica del codice sorgente per bug e vulnerabilità |
| IaC security | Checkov | Scansione delle configurazioni e dell’IaC |
| IaC security | KICS | Analisi statica del codice IaC per configurazioni errate |
| IaC security | Trivy | Scanner di vulnerabilità e configurazione errata |
| Container e supply chain security | Snyk | Analisi di dipendenze e container |
| Container e supply chain security | Syft | Generazione di SBOM |
| Container e supply chain security | Grype | Confronto SBOM con database di vulnerabilità |
| Runtime security | Falco | Rilevamento di comportamenti anomali nei cluster Kubernetes |
Perché la runtime security con eBPF completa la pipeline
Un’immagine può passare tutti i gate di sicurezza in CI e diventare comunque il vettore di un incidente il giorno dopo il deploy. Le ragioni sono banali e ricorrenti: una CVE pubblicata dopo la build, un secret esfiltrato tramite una dipendenza legittima, un container che monta un volume che non dovrebbe vedere. Lo scanner ha fotografato l’artefatto in un istante; l’attaccante lavora sul comportamento del processo in esecuzione.
Qui entra in gioco eBPF. Invece di iniettare sidecar o caricare moduli kernel custom, un programma eBPF viene verificato dal kernel e agganciato ai tracepoint delle syscall, osservando ogni execve, open, connect generato dai container del nodo con un overhead che, nelle nostre installazioni su cluster GKE di medie dimensioni, resta tipicamente sotto il 3-5% di CPU per nodo con un ruleset ripulito.
Falco11 consuma quello stream di eventi e lo valuta contro un set di regole dichiarative: shell interattiva aperta dentro un container, scrittura in /etc/, connessione uscente verso un IP non previsto, montaggio di /var/run/docker.sock.
Dal 2024 è un progetto graduato in CNCF12, lo stesso livello di maturità di Kubernetes e Prometheus, e supporta tre driver: modulo kernel, probe eBPF legacy e modern eBPF probe basata su CO-RE, che richiede kernel 5.8+ con BTF abilitato e non necessita di compilazione sul nodo.
Falco non è l’unica opzione, e la scelta dipende soprattutto da una domanda: vuoi solo rilevare o anche bloccare?
| Strumento | Meccanismo | Enforcement | Requisiti kernel | Governance |
|---|---|---|---|---|
| Falco | eBPF (CO-RE) o modulo kernel | Detection; risposta con Falco Talon | 5.8+ con BTF per modern eBPF | CNCF, graduato |
| Tetragon | eBPF, parte del progetto Cilium | Sì, kill del processo in-kernel | 5.4+, funzionalità complete su 5.10+ | CNCF, con Cilium |
| Tracee | eBPF CO-RE (Aqua Security) | Detection, blocco sperimentale | 5.8+ per CO-RE | Open source Aqua |
| KubeArmor | BPF-LSM, AppArmor, SELinux | Sì, preventivo su policy | 5.8+ per BPF-LSM | CNCF sandbox |
Due lezioni dalla nostra esperienza sul campo. La prima: il ruleset di default genera rumore, e un canale Slack che riceve 400 alert al giorno viene silenziato in una settimana. Conviene partire in modalità osservativa, costruire una baseline di due o tre settimane, disabilitare le regole che intercettano comportamenti legittimi della piattaforma (i job di backup, gli init container, gli agent di monitoring) e solo dopo collegare Falcosidekick al SIEM o a un flusso di on-call.
La seconda è meno ovvia: non tutti i cluster possono ospitare un agente runtime. Su GKE Autopilot e su altri ambienti a nodi completamente gestiti non è possibile eseguire DaemonSet privilegiati che caricano probe eBPF, quindi il rilevamento deve appoggiarsi ai Kubernetes audit log e agli strumenti del cloud provider. È un vincolo architetturale che va valutato prima di scegliere il modello di cluster, non dopo: scoprirlo in fase di hardening significa rimettere in discussione la piattaforma.
Vale anche sul piano normativo. NIS213 e DORA14 non chiedono soltanto di prevenire gli incidenti, ma di rilevarli e notificarli entro finestre temporali molto strette, e i numeri sono espliciti. La direttiva (UE) 2022/2555 impone ai soggetti essenziali e importanti un early warning entro 24 ore dalla presa di conoscenza di un incidente significativo, una notifica dettagliata entro 72 ore e una relazione finale entro un mese. Il regolamento (UE) 2022/2554 chiede invece, per gli incidenti ICT gravi, una notifica iniziale entro 4 ore dalla classificazione e comunque non oltre 24 ore dal rilevamento, seguita da un report intermedio e da uno finale.
Sono tempistiche che presuppongono di sapere cosa è successo dentro un pod: senza telemetria a runtime, la maggior parte delle organizzazioni non ha nemmeno il dato di partenza per compilare quei report. Abbiamo raccolto le implicazioni architetturali nelle nostre best practice cloud native per la compliance.
Il tuo passo successivo
In conclusione, DevSecOps continua ad essere un trend in forte crescita all’interno delle organizzazioni, la sua adozione è in grado di migliorare la qualità del software prodotto e il livello di sicurezza di tutta la value chain associata allo sviluppo del software. Le best practice ne semplificano l’adozione e l’utilizzo di nuove tecnologie e strumenti specifici permettono di standardizzare l’implementazione tecnologica.
Per un’azienda che vuole rimanere competitiva nel mercato, iniziare un cammino di DevSecOps Strategy, ovvero uno studio approfondito del vantaggio competitivo che questa metodologia può portare all’organizzazione, può essere una mossa vincente. Se ti interessa in particolare il contesto del Cloud, puoi iniziare dalla nostra Guida gratuita alla Cloud Native Security.
Per una consulenza personalizzata, contattaci. I nostri esperti possono aiutarti ad identificare una strategia di sicurezza su misura, affiancando e trasmettendo le best practices al tuo team.
Note e fonti
Cyber Resilience Act. The Cyber Resilience Act is an EU regulation establishing mandatory cybersecurity requirements for hardware and software products with digital elements placed on the European market. (fonte: https://digital-strategy.ec.europa.eu/en/policies/cyber-resilience-act) ↩︎
SLSA (Supply-chain Levels for Software Artifacts). SLSA is a security framework and set of standards established by OpenSSF to prevent tampering, improve integrity, and secure software supply chains. (fonte: https://openssf.org/projects/slsa/) ↩︎
Checkov. Checkov is an open-source static code analysis tool that scans infrastructure-as-code (IaC) files for security vulnerabilities and compliance misconfigurations across frameworks like Terraform. (fonte: https://www.checkov.io/) ↩︎
BridgeCrew. Bridgecrew is a developer-first cloud security platform and Infrastructure as Code (IaC) security tool, acquired by Palo Alto Networks in 2021 and integrated into Prisma Cloud. (fonte: https://www.paloaltonetworks.com/company/press/2021/palo-alto-networks-completes-acquisition-of-bridgecrew) ↩︎
Trivy. Trivy is an open-source security scanner maintained by Aqua Security that detects vulnerabilities, misconfigurations, and exposed secrets in container images, filesystems, and repositories. (fonte: https://trivy.dev/) ↩︎
KICS. KICS is an open-source static code analysis tool by Checkmarx that scans Infrastructure as Code (IaC) files for security vulnerabilities and misconfigurations. (fonte: https://kics.io/) ↩︎
SonarQube. SonarQube is an automated code quality and security analysis platform by SonarSource. It performs static analysis to detect bugs, vulnerabilities, and code smells in source code. It also maintains a free and open source edition. (fonte: https://www.sonarsource.com/products/sonarqube/) ↩︎
Snyk.io. Snyk is a developer-first application security platform that helps teams find, prioritize, and fix vulnerabilities in code, open-source dependencies, containers, and infrastructure as code. (fonte: https://snyk.io/) ↩︎
Syft. Syft is an open-source CLI tool and Go library developed by Anchore for generating a Software Bill of Materials (SBOM) from container images and filesystems. (fonte: https://github.com/anchore/syft) ↩︎
Grype. Grype is an open-source vulnerability scanner developed by Anchore that identifies known security vulnerabilities in container images, filesystems, and Software Bill of Materials (SBOMs). (fonte: https://github.com/anchore/grype) ↩︎
Falco. Falco is an open-source, cloud-native runtime security tool that provides real-time threat detection across hosts, containers, Kubernetes, and cloud environments. (fonte: https://falco.org/docs/) ↩︎ ↩︎
CNCF. The Cloud Native Computing Foundation (CNCF) is a Linux Foundation subsidiary that fosters cloud-native technologies, serving as a vendor-neutral home for open-source projects like Kubernetes. (fonte: https://orca.security/glossary/cncf/) ↩︎
NIS2. The NIS2 Directive (Directive (EU) 2022/2555) is the EU’s updated cybersecurity framework, setting risk management and reporting rules for critical sectors. (fonte: https://eur-lex.europa.eu/EN/legal-content/summary/cybersecurity-of-network-and-information-systems.html) ↩︎
DORA. DORA (Regulation (EU) 2022/2554) is the EU’s Digital Operational Resilience Act for financial cybersecurity. It’s a European Union regulation that standardizes and strengthens the cybersecurity and IT resilience of the financial sector. It became fully applicable on January 17, 2025. (fonte: https://www.eiopa.europa.eu/digital-operational-resilience-act-dora_en) ↩︎