Come rendere le applicazioni più performanti e scalabili? La logica Cloud Native non può fare a meno dei container e della loro orchestrazione, nota anche come container orchestration: ecco come funziona e quali sono i vantaggi di Kubernetes.
Per capire il concetto di orchestrazione dei container, dobbiamo partire da una definizione di questi ultimi.
I container sono una forma di virtualizzazione a livello di sistema operativo che pacchettizza il codice e le sue dipendenze. Sono diventati una delle soluzioni di virtualizzazione più adottate e mature, in particolare negli ambienti Cloud Native.
Possiamo considerarli come macchine virtuali molto più leggere, svincolate dall’infrastruttura sottostante. Per le applicazioni all’interno del container sono disponibili tutte le risorse della macchina; il sistema operativo invece fa vedere loro solo le risorse allocate ed eventualmente gli altri applicativi eseguiti in altri container.
Con questo “inganno” è possibile creare facilmente più contenitori che eseguano uno o più programmi, ciascuno dei quali ha a disposizione un sottoinsieme delle risorse complessive del computer. Le applicazioni possono essere eseguite in maniera separata o contemporanea e interagire tra loro oppure no.
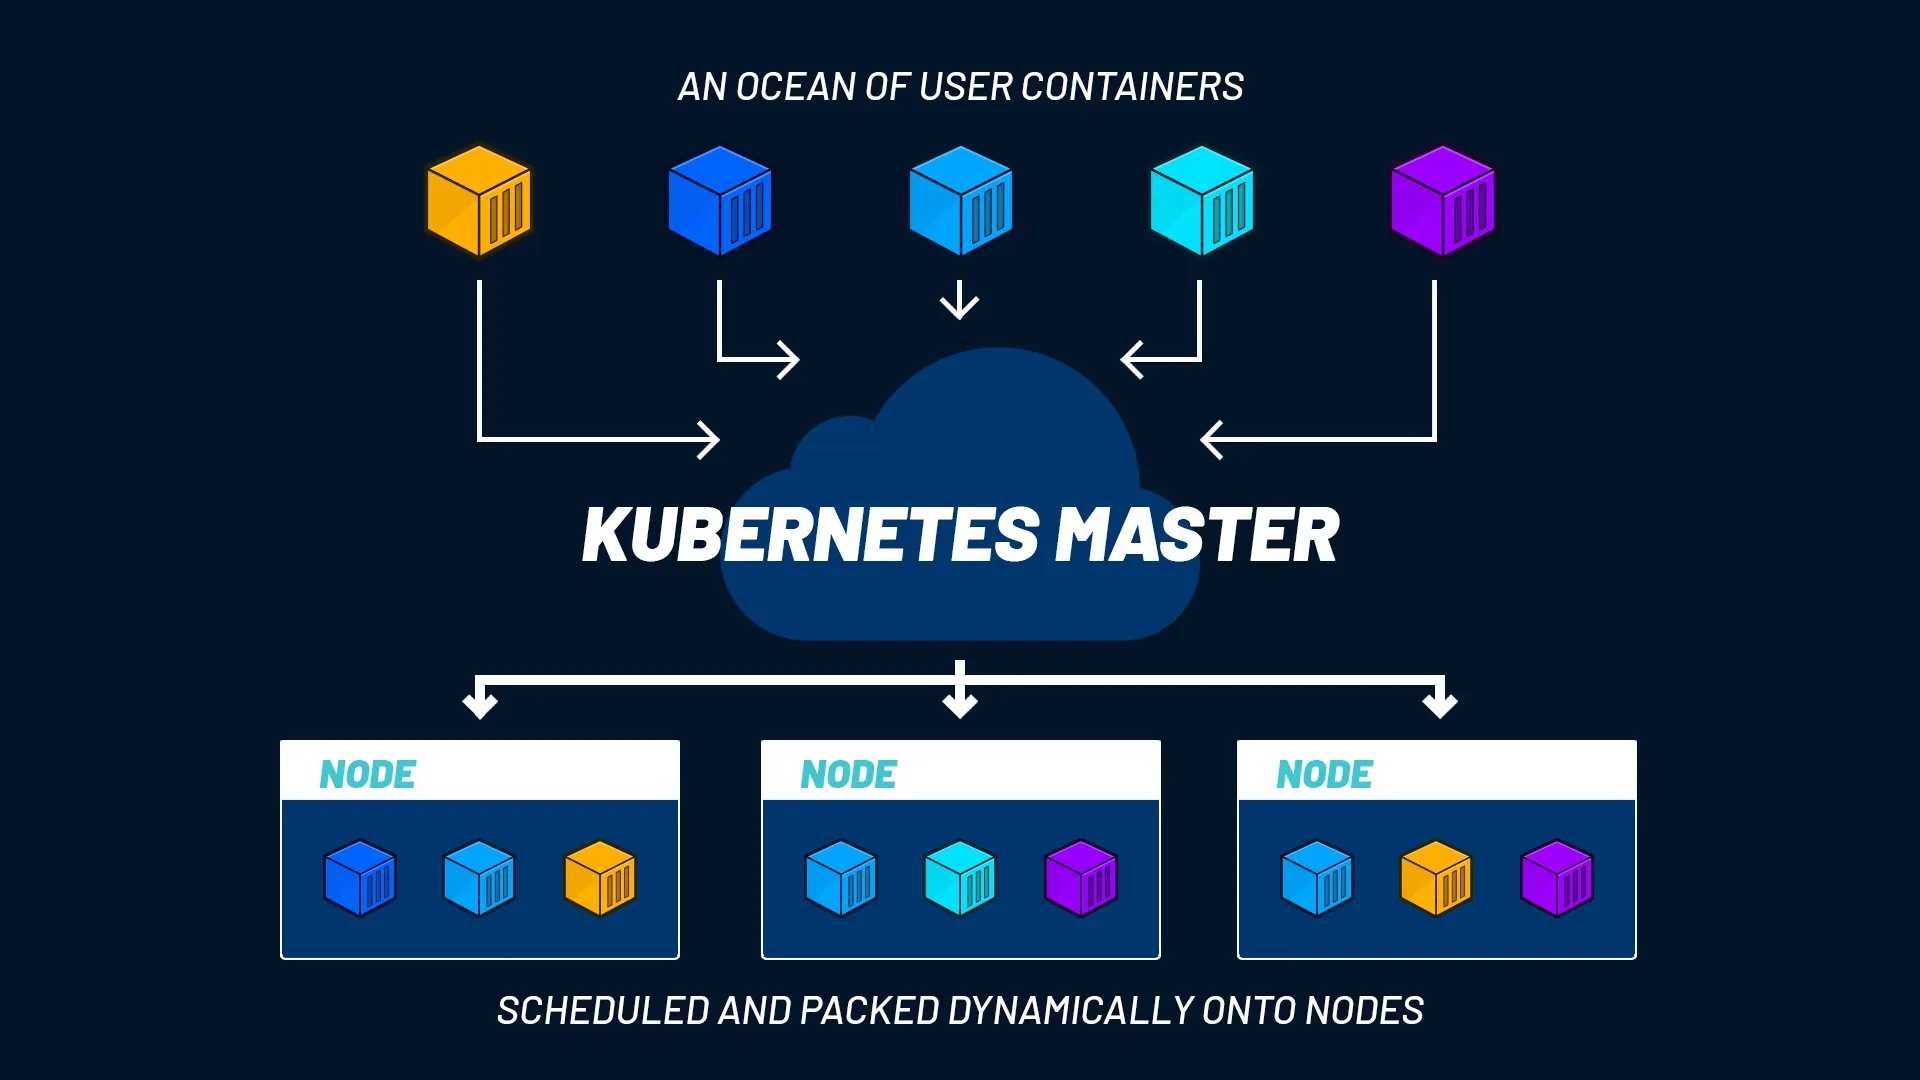
Dal momento che ogni container contiene un singolo software, o più spesso un microservizio, è facile che in breve tempo ci si trovi ad operare centinaia di container, magari anche su cloud diversi.
Questo rende impossibile gestirli manualmente e richiede forme di automazione per tutto il ciclo di vita dei container. La soluzione è un processo chiamato orchestrazione, che permette di semplificare le operazioni, aumentare la resilienza della soluzione, migliorare la sicurezza complessiva e quindi raggiungere gli obiettivi di business.
LEGGI ANCHE: Containerizzazione delle applicazioni: cosa devi sapere
Come si passa dalla virtualizzazione all’orchestrazione dei container?
Il passaggio dalla virtualizzazione all’orchestrazione dei container rappresenta un’evoluzione fondamentale per le infrastrutture IT. Mentre la virtualizzazione tradizionale divide le risorse hardware creando macchine virtuali pesanti, l’orchestrazione automatizza il ciclo di vita di container leggeri e indipendenti, garantendo scalabilità dinamica, resilienza e un utilizzo ottimizzato delle risorse in ambienti cloud.
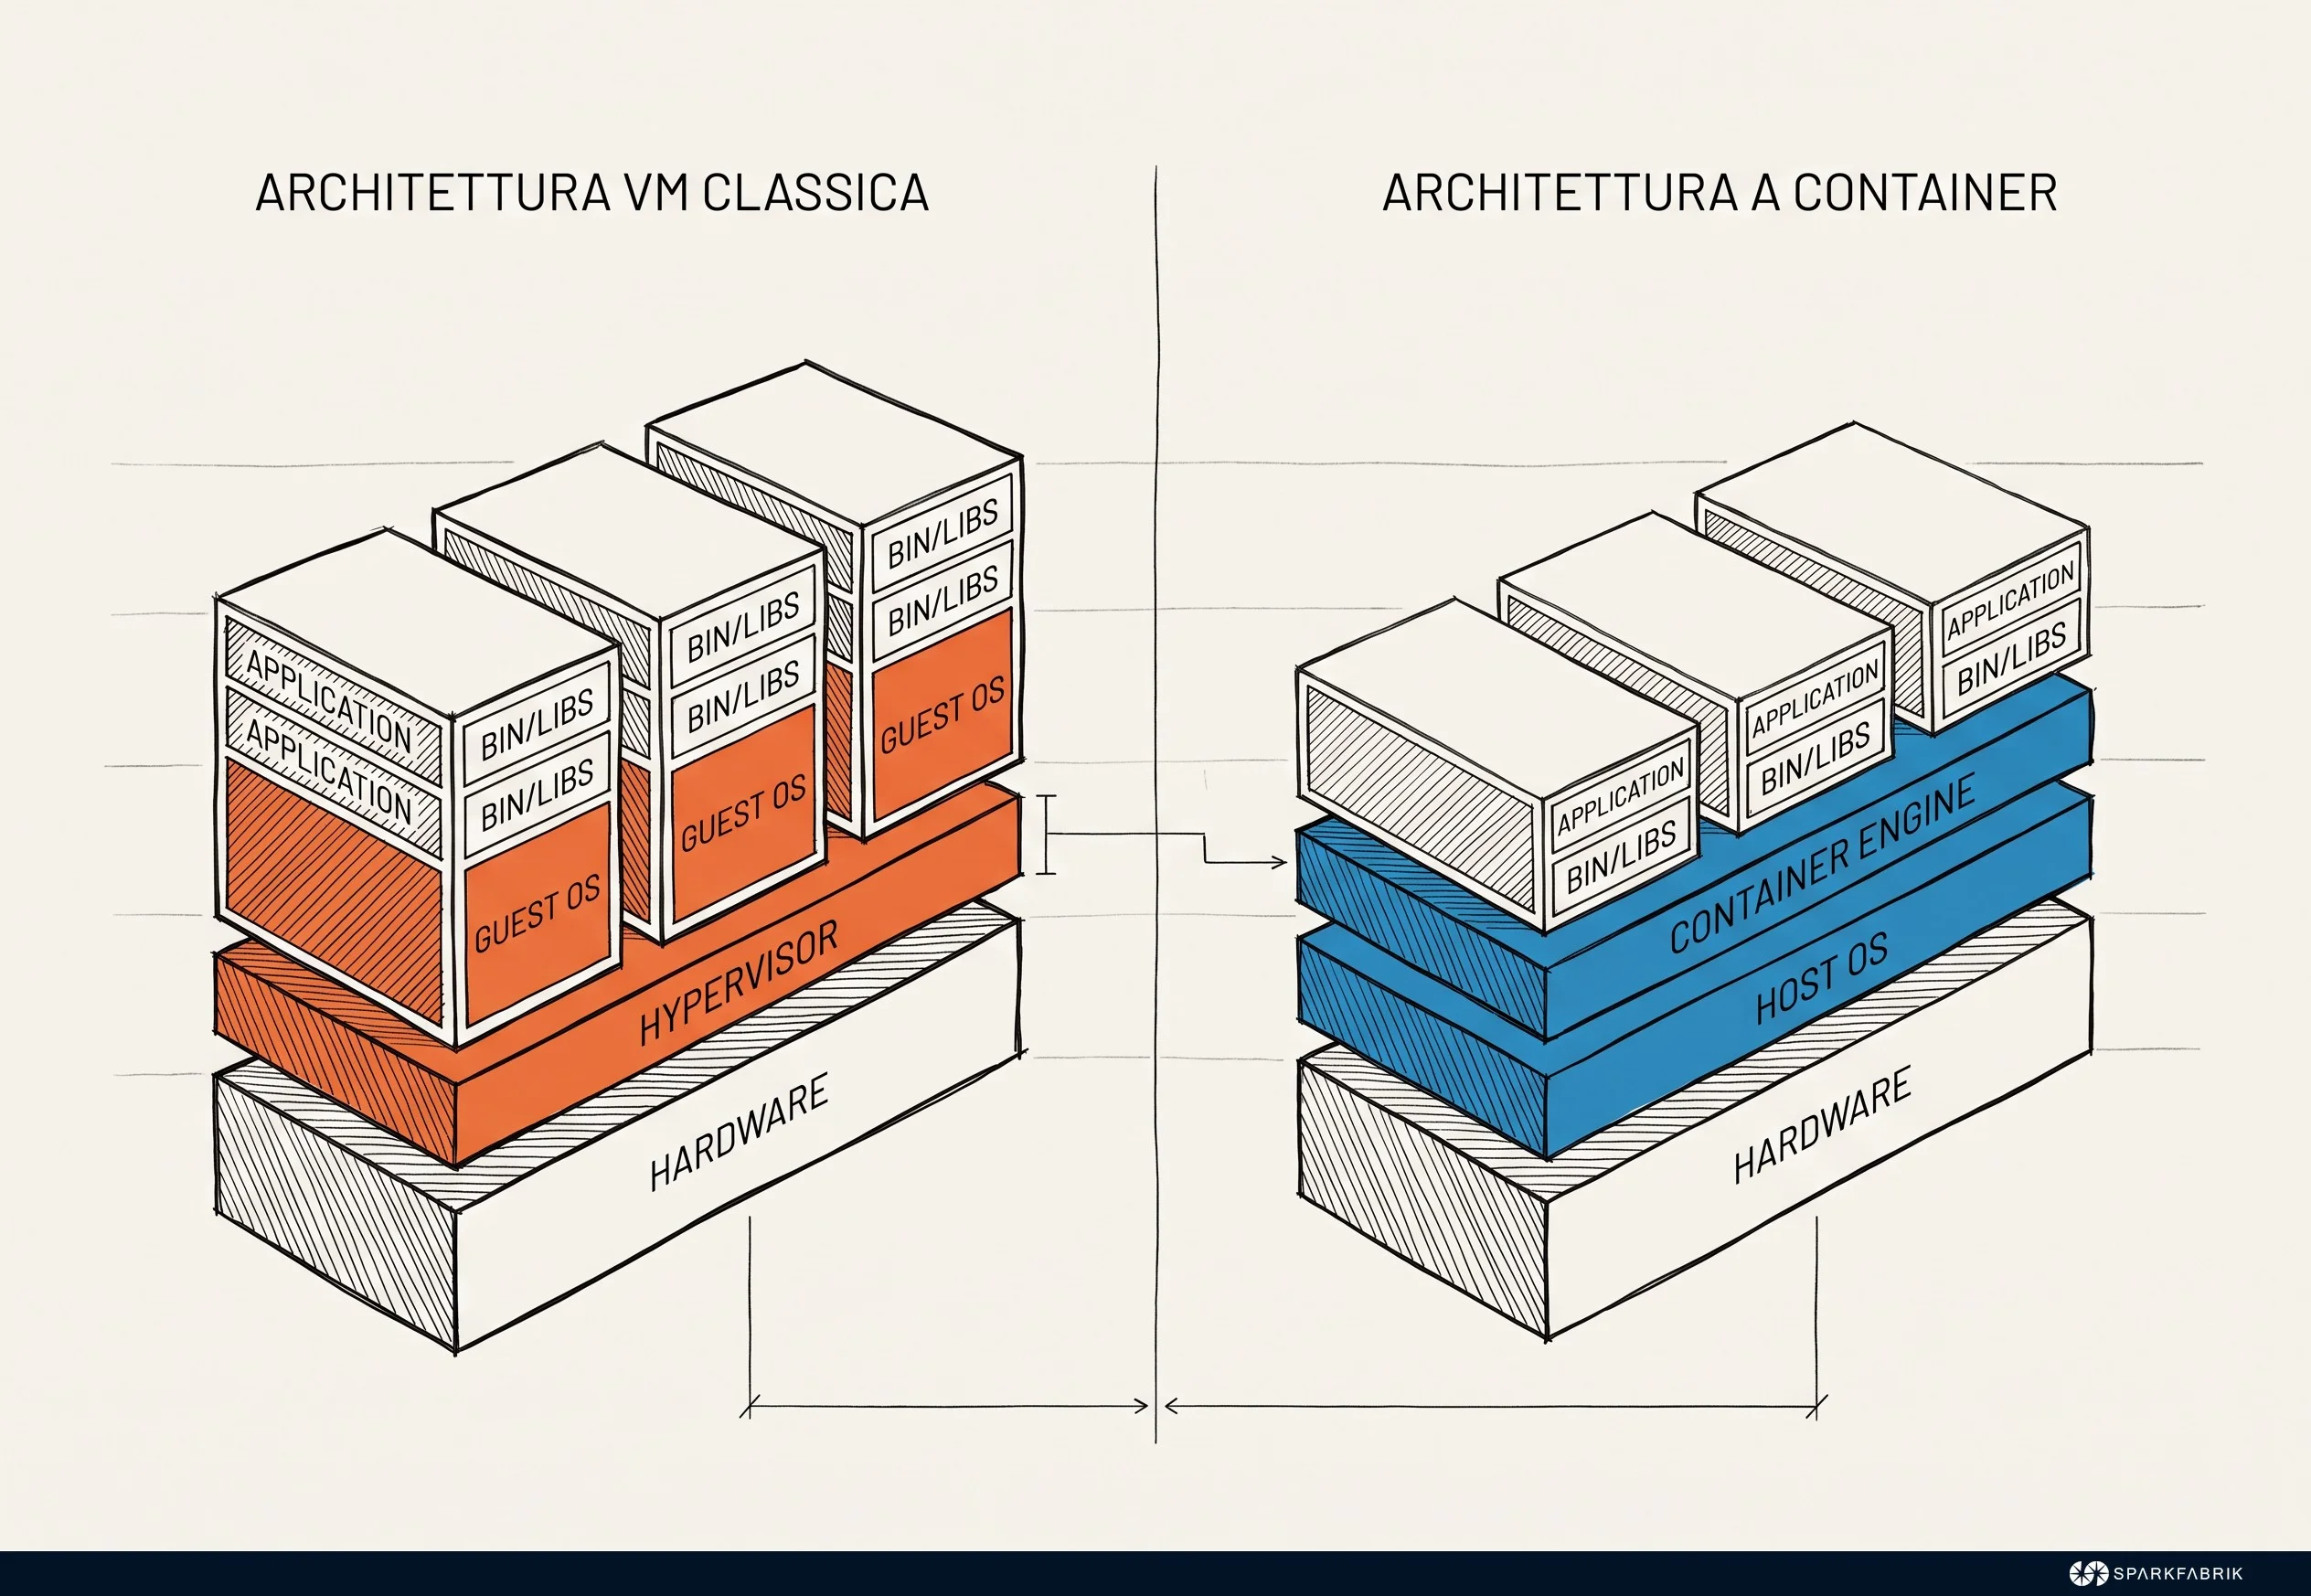
La virtualizzazione non è una conquista recente dell’informatica. Anzi, già i mainframe negli anni Sessanta utilizzavano la virtualizzazione come metodo per dividere dal punto di vista logico le risorse di sistema tra applicazioni differenti. Uno stesso mainframe molto potente poteva eseguire istanze multiple di uno o più sistemi operativi per far girare applicazioni diverse come se stessero funzionando su computer fisicamente diversi, consolidando così i costi e alcune delle complessità gestionali di più sistemi. Dentro un’unica macchina host funzionavano più pseudo-macchine guest.
Le più moderne forme di virtualizzazione software e hardware possono supportare un ambiente virtuale completo. Questo approccio è molto utile per consolidare server più piccoli in un unico hardware di classe superiore, riducendo costi e complessità.
Le macchine virtuali facilitano anche la gestione, la sicurezza e la replicabilità delle installazioni. Inoltre riducono notevolmente la difficoltà di trasferimento di un’installazione da un sito all’altro o in scenari di disaster recovery.
Tuttavia, anche le macchine virtuali hanno numerosi limiti sia di complessità sia di consumi energetici e di tipi di carico di lavoro possibili. E questi limiti vengono amplificati nel cloud, soprattutto in quello pubblico.
Per questo sono nate soluzioni che isolano ogni singolo software in un container. Il container abilita la costruzione di cluster caratterizzati da facilità di deployment, sicurezza, affidabilità, scalabilità e automazione.1
I container accelerano lo sviluppo del software perché permettono di scrivere codice in maniera coerente: dall’ambiente locale al cloud pubblico, i programmatori lavorano in maniera continua e senza differenze. Infine, essendo leggeri e facilmente spegnibili, i container permettono di ottimizzare l’utilizzo delle risorse.
È chiaro che la gestione di un ambiente di questo tipo è complessa e lo diventa sempre di più all’aumentare del numero dei container e delle applicazioni in esecuzione. C’è però anche un’altra importante distinzione da fare. A differenza di un ambiente tradizionale, nel quale la stabilità dei programmi e delle installazioni si misura nella durata complessiva del loro uptime, l’utilità maggiore dei container sta nella gestione dinamica di carichi di lavoro che cambiano rapidamente. I container sono tanto più utili quanto più velocemente (e automaticamente) possono essere istanziati e poi terminati.
A cosa serve e perché si fa l’orchestrazione dei container?
Il processo di orchestrazione si avvale di strumenti software per automatizzare e gestire la configurazione, il coordinamento e il ciclo di vita dei container. Lo scopo dell’orchestrazione è quello di poter gestire un’architettura service-oriented o a microservizi che consenta di coniugare gli obiettivi di business con la tecnologia a disposizione: applicazioni, dati e infrastruttura.
In qualsiasi ambiente vengano utilizzati i container, è sempre applicabile un metodo di orchestrazione che permetta di semplificare sia il lavoro di distribuzione dei software che la gestione di tutti gli aspetti del servizio, incluso lo storage, la rete e la sicurezza.
Se guardiamo da una prospettiva diversa, l’orchestrazione gestisce il ciclo di vita dei container. Questo ha importanti implicazioni per i team di lavoro che utilizzano un approccio DevOps e flussi di lavoro CI/CD. L’orchestrazione e i container, insomma, sono due degli elementi più importanti per la creazione delle applicazioni di tipo Cloud Native.
Quali sono gli strumenti per la container orchestration?
Gli strumenti per la container orchestration sono piattaforme progettate per automatizzare il deployment, la gestione, la scalabilità e il networking dei carichi di lavoro containerizzati. Questi sistemi monitorano costantemente lo stato delle applicazioni, bilanciano il traffico e garantiscono l’alta affidabilità, riducendo drasticamente il carico operativo sui team infrastrutturali.
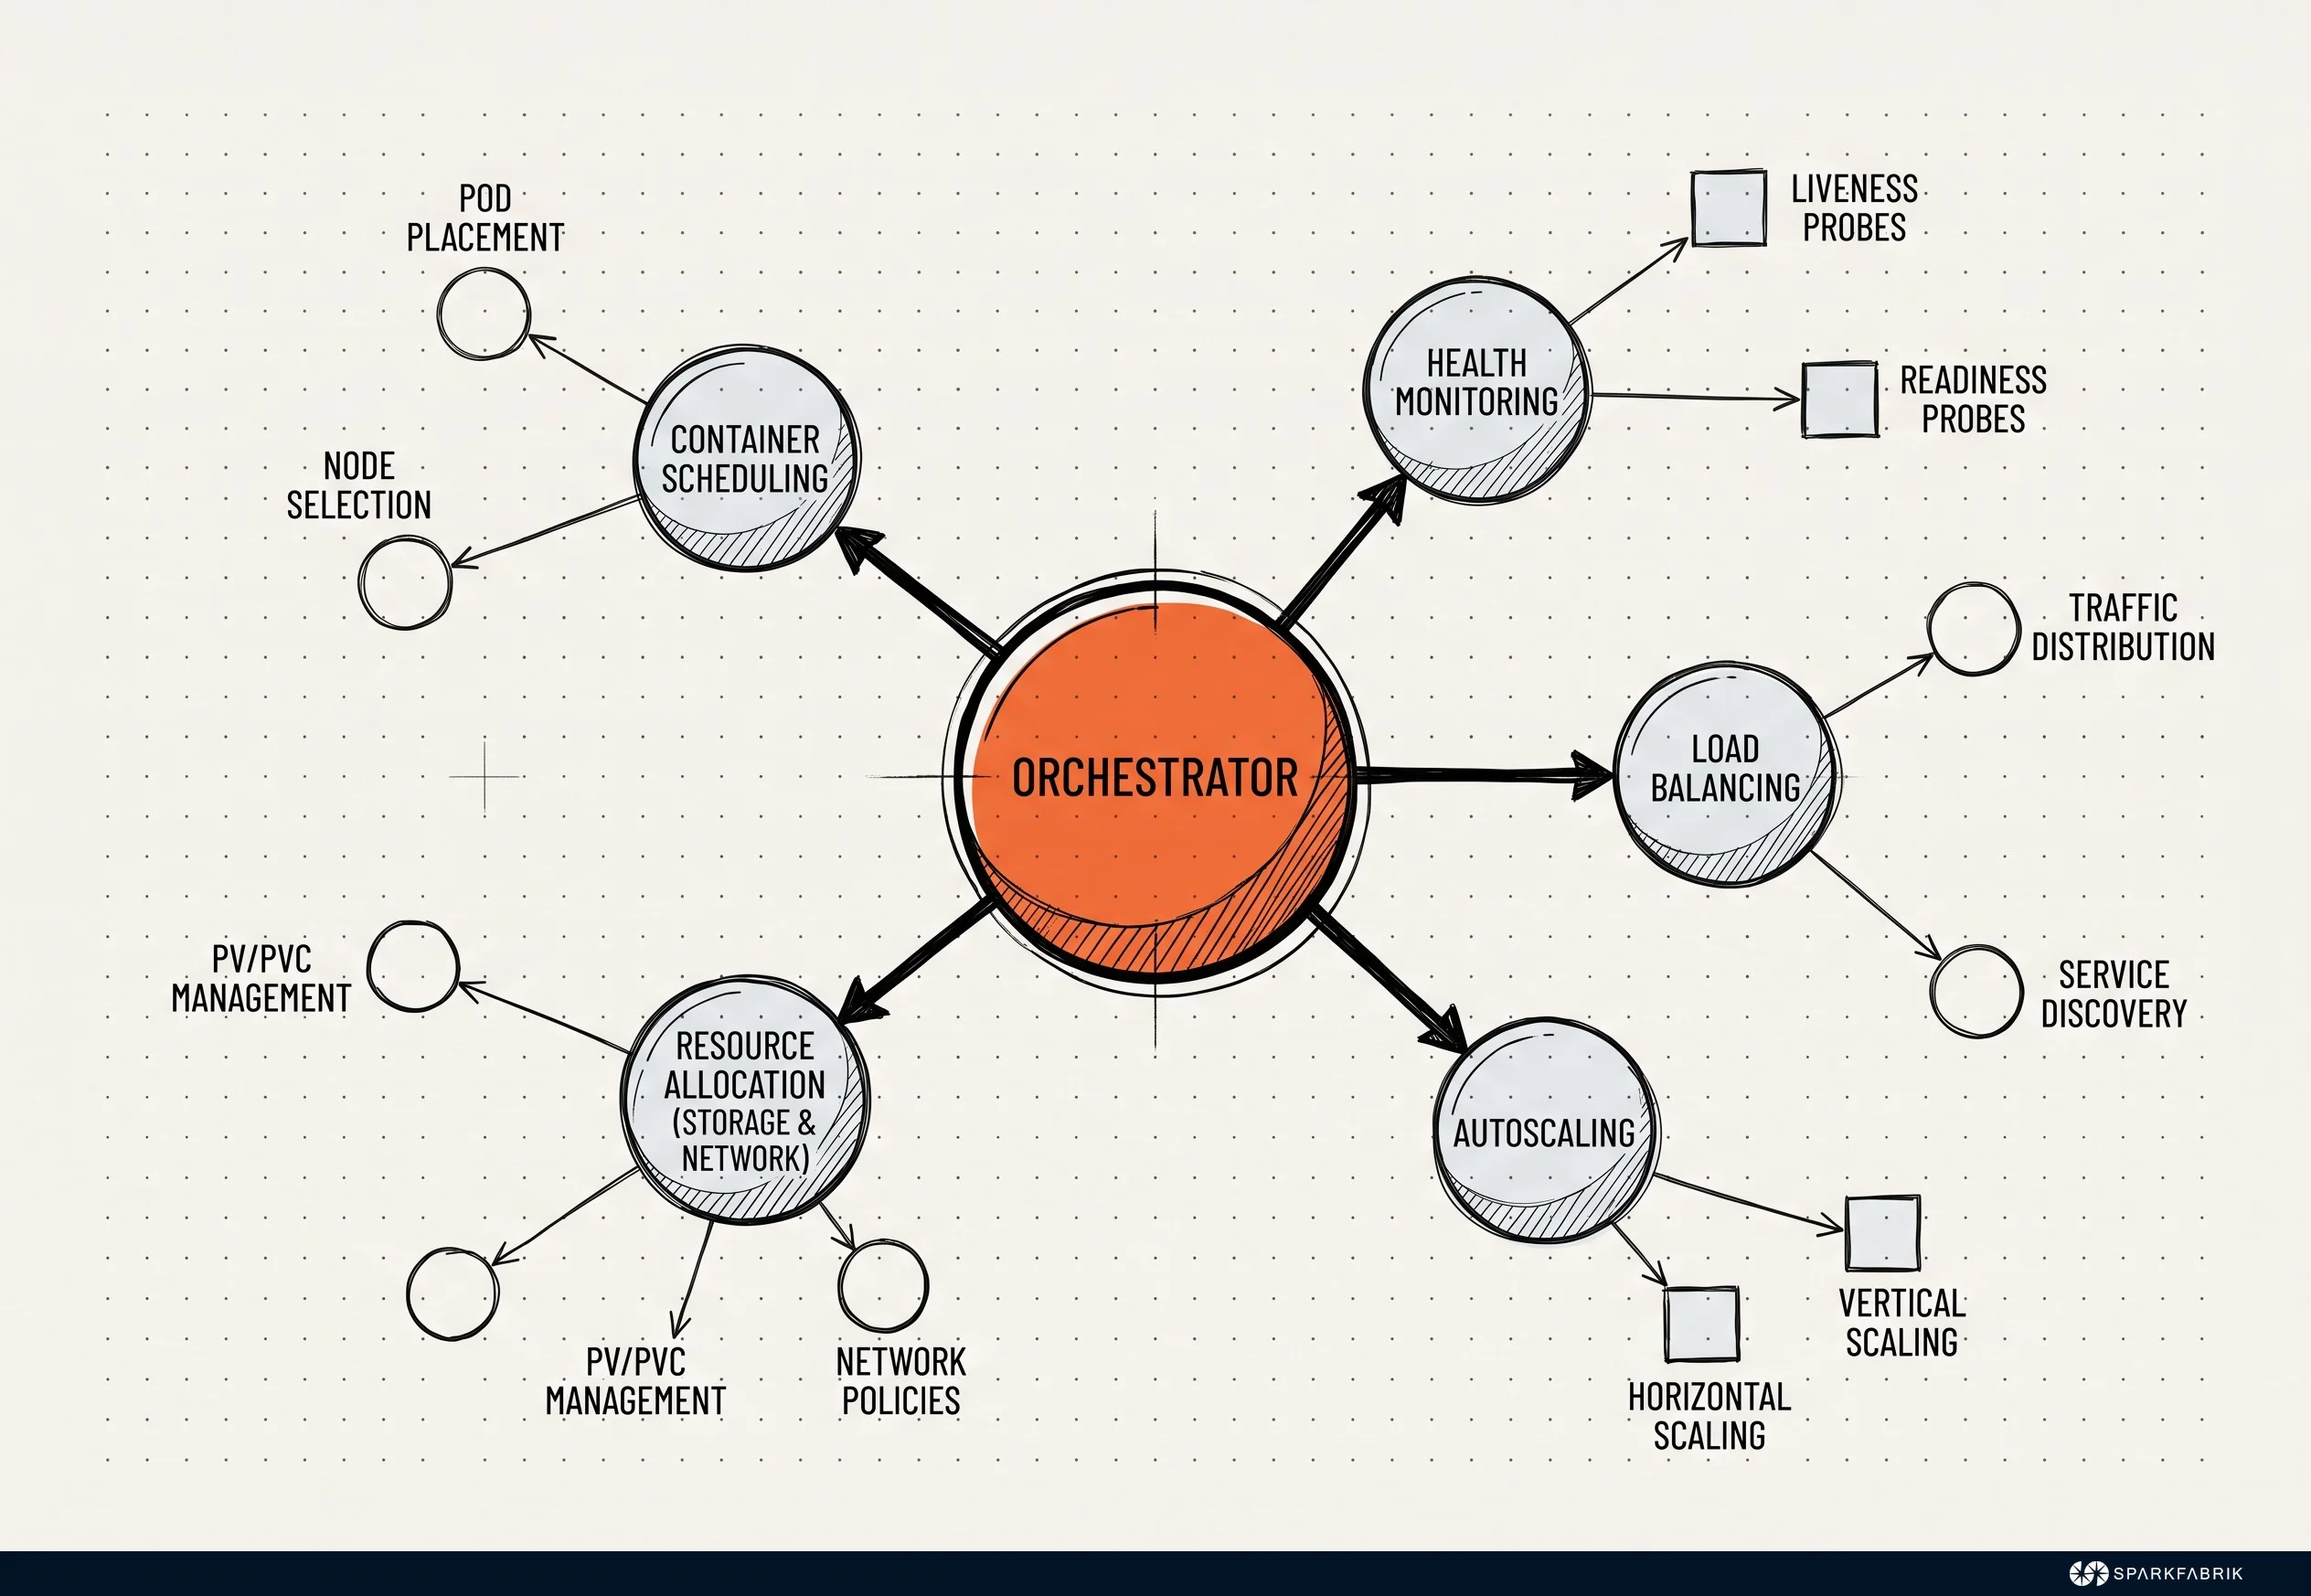
Esistono vari strumenti per eseguire l’orchestrazione. Il più famoso e standard de facto è sicuramente Kubernetes2 (o K8s), ma il quadro delle alternative è in continua evoluzione ed è cambiato notevolmente negli ultimi anni. Docker Swarm3, integrato nella piattaforma di containerizzazione Docker4, offre nativamente funzionalità di alta affidabilità tramite la ridondanza dei nodi manager, ma il suo utilizzo si è progressivamente ridotto: oggi resta una scelta pragmatica soprattutto per ambienti di sviluppo o per cluster di dimensioni contenute. Apache Mesos5, a lungo citato come contendente, è ormai un progetto legacy: la Apache Software Foundation lo ha ufficialmente ritirato nell’agosto 2025.
Le vere alternative moderne per la container orchestration in ambito enterprise sono oggi HashiCorp Nomad e i motori di orchestrazione proprietari dei cloud provider, come AWS ECS.
Questi orchestratori hanno la capacità di gestire:
la configurazione e la pianificazione dei container;
la loro disponibilità;
l’assegnazione delle risorse;
i meccanismi di provisioning e deployment;
la scalabilità (che vuol dire anche il ribilanciamento dei carichi sull’infrastruttura e l’eventuale rimozione dei container);
il loro monitoraggio.
Inoltre, possono gestire la configurazione dei software contenuti nei singoli container e la gestione (e protezione) delle interazioni tra container.
Kubernetes ha una serie di funzionalità in più che lo rendono particolarmente adatto alla gestione dell’hosting di software cloud nativo. In particolare, è molto importante la scalabilità anche orizzontale (Horizontal Pod Autoscaler6) tra cluster di host su cloud pubblico, privato o ibrido perché consente la portabilità dei carichi di lavoro e la semplificazione del loro bilanciamento.
Quali sono i vantaggi di Kubernetes per le aziende?
Creato da Google come progetto open source per l’orchestrazione dei container interna ai Googleplex, dal 2015 Kubernetes è stato ceduto alla Cloud Native Computing Foundation, nata all’interno della Linux Foundation. Questa scelta strategica colloca Kubernetes in un ambiente di sviluppo vitale e reattivo, ma soprattutto capace di indirizzare la crescita delle tecnologie Cloud Native e definire gli standard tecnologici aperti dei prossimi anni.
Kubernetes ottimizza l’uso delle risorse IT con conseguenti vantaggi dal punto di vista di tempi e costi. Sviluppo, rilascio e distribuzione diventano più semplici e rapidi grazie a questo orchestratore, mentre l’allocazione dinamica delle risorse permette di ridurre gli sprechi e i costi. Lo scale-down automatico infatti evita l’utilizzo di risorse non necessarie. Non solo: in caso di picchi di traffico l’autoscaling aumenta la disponibilità e migliora quindi il servizio.
Inoltre Kubernetes si rivela uno strumento indispensabile per trarre il massimo beneficio dalle soluzioni multi o hybrid cloud poiché garantisce il funzionamento delle applicazioni in qualsiasi ambiente pubblico e privato, senza perdite funzionali o di performance.
Da ultimo, le infrastrutture containerizzate e gestite con Kubernetes offrono anche un tasso di affidabilità molto elevato.
PER APPROFONDIRE: Tutti i vantaggi di Kubernetes
Managed Kubernetes e serverless container: quando gestire il cluster non conviene più
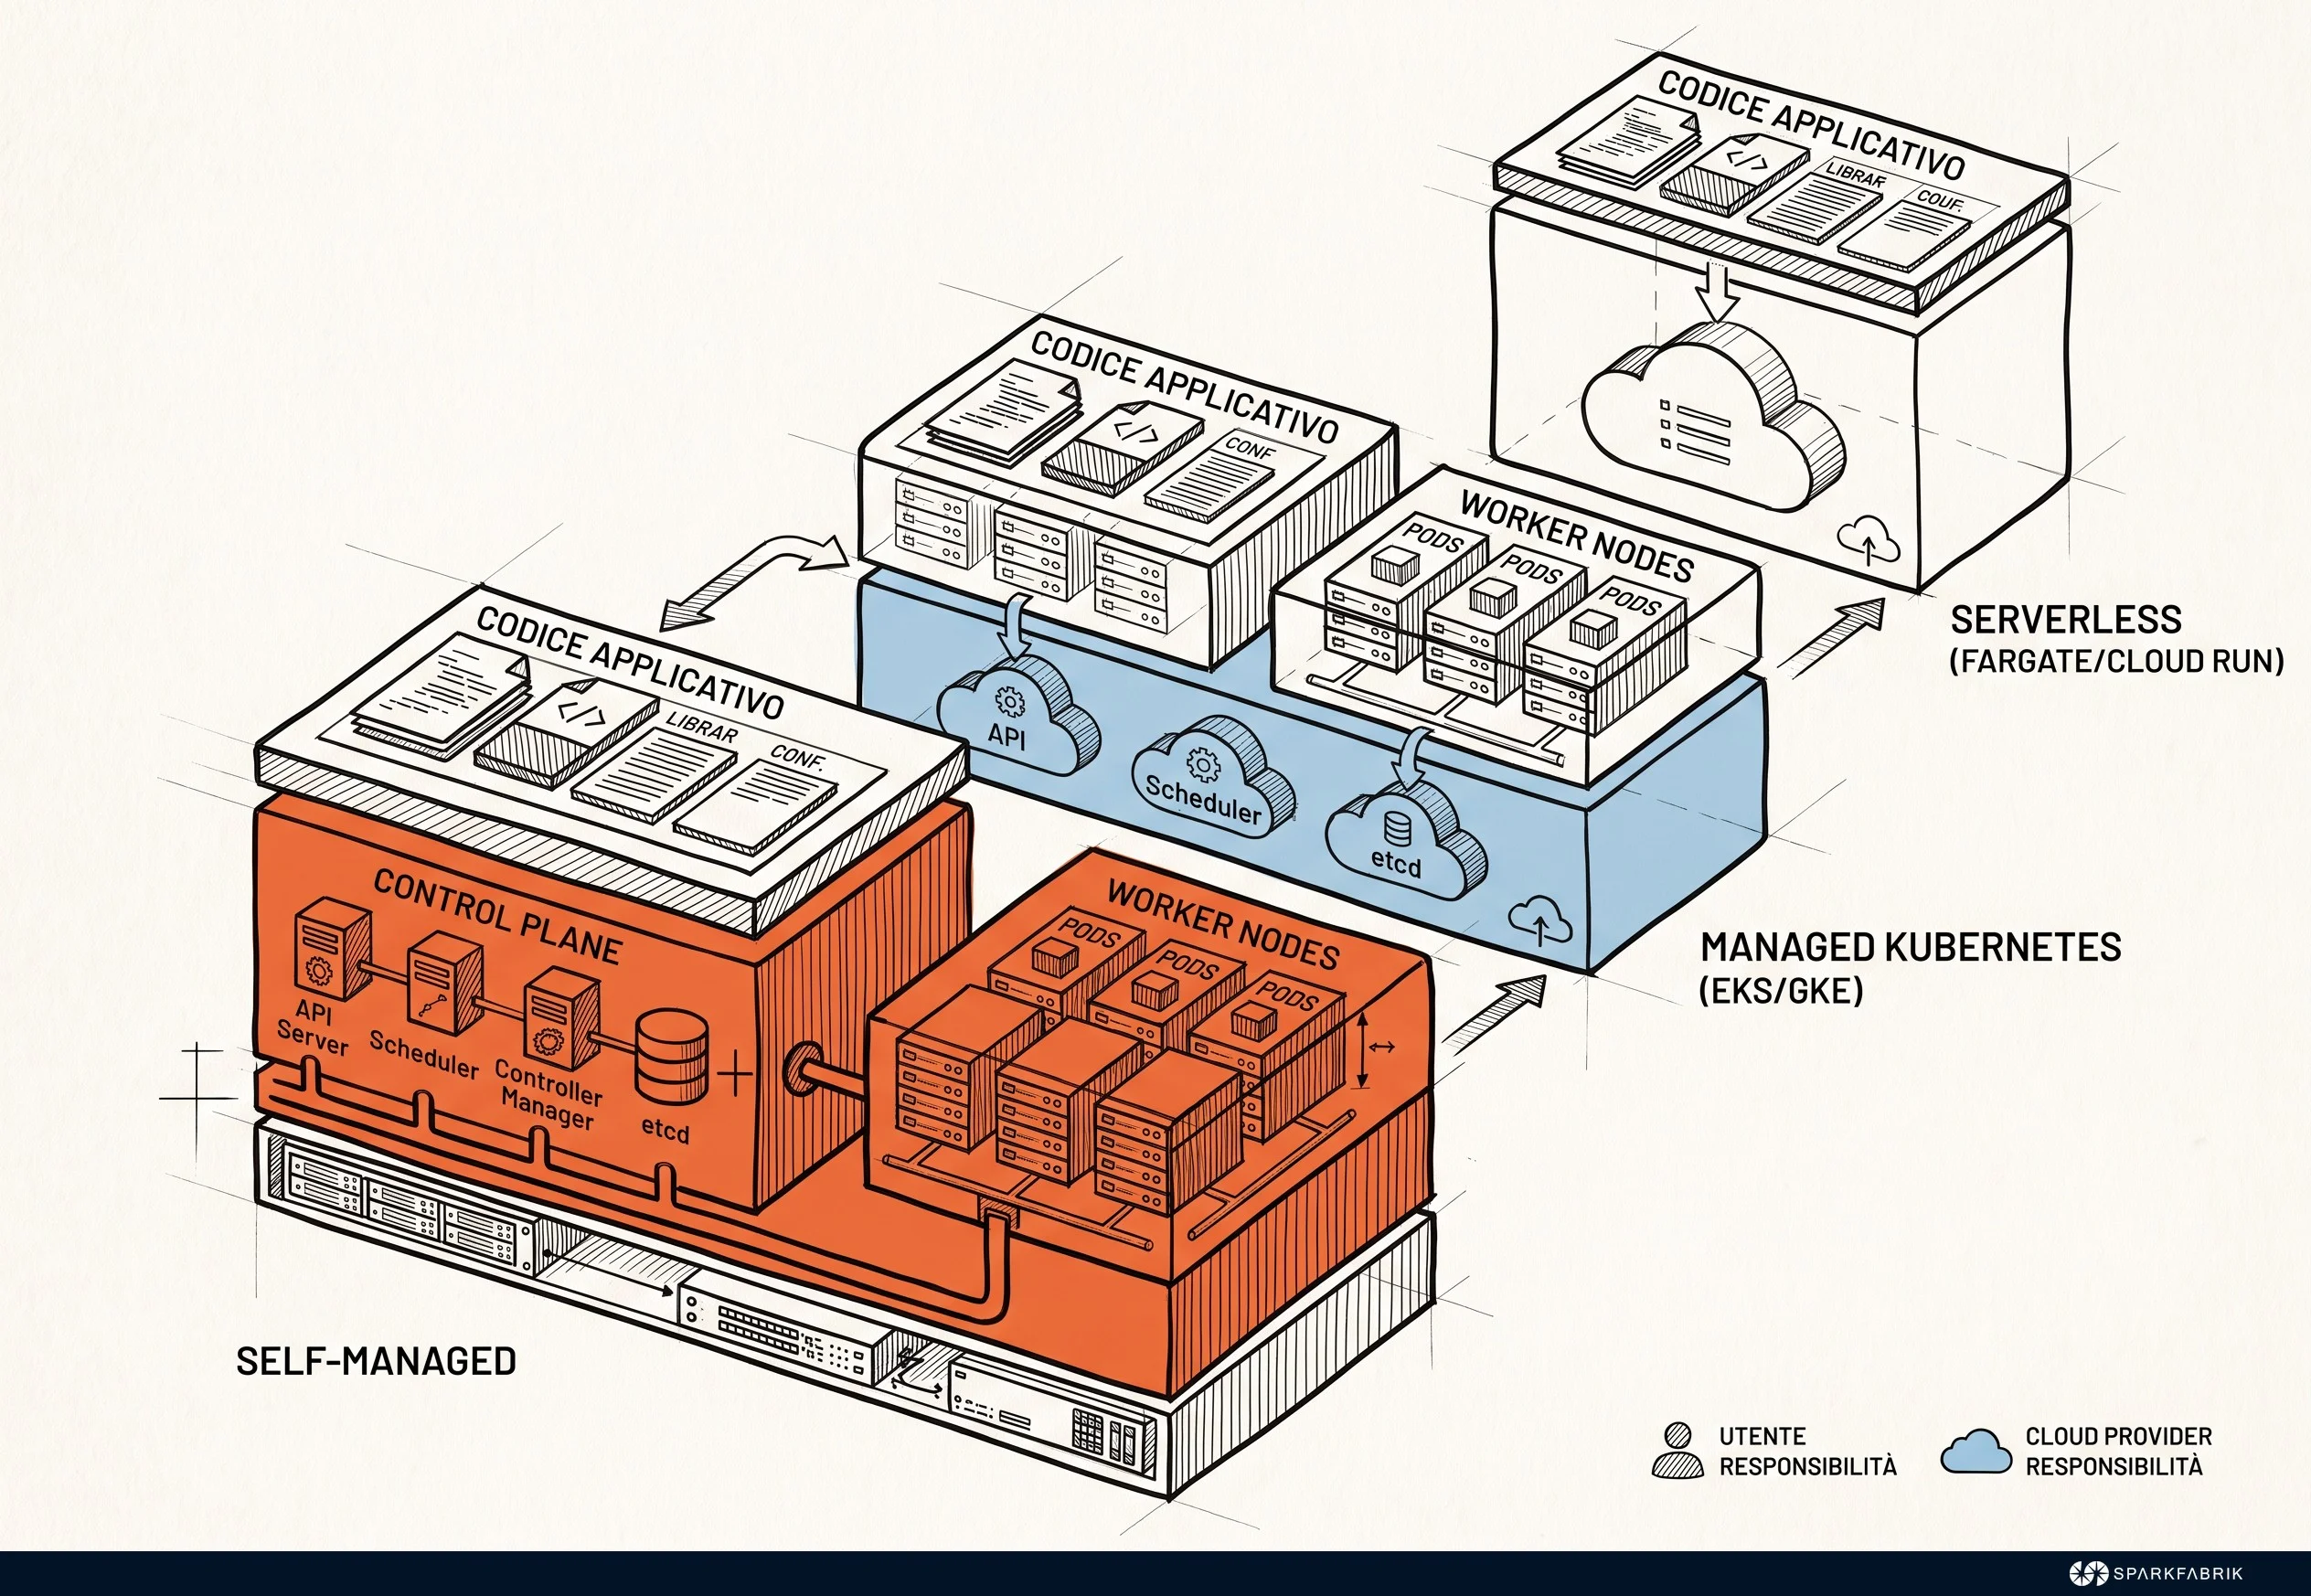
Installare e mantenere manualmente un cluster Kubernetes, gestendo in autonomia il pannello di controllo centrale (control plane), il database di configurazione (etcd) e i singoli nodi, oggi ha senso in un numero ristretto di scenari: ambienti air-gapped, requisiti di sovranità digitale che impediscono l’uso del cloud pubblico, hardware specializzato on-premise o vincoli normativi specifici. Per il resto, la norma operativa è ormai il ricorso a servizi gestiti o a soluzioni serverless container, che eliminano gran parte del carico operativo senza rinunciare al modello Kubernetes.
Un servizio di managed Kubernetes, come Amazon EKS, Google GKE o Azure AKS, trasferisce al cloud provider la responsabilità del control plane: i componenti centrali (come API server, scheduler e datastore etcd) vengono gestiti, aggiornati e resi altamente disponibili dal provider, mentre il team si concentra sui carichi di lavoro (workload) e sulle configurazioni applicative. Resta comunque una quota di gestione a carico dell’utente, in particolare per i gruppi di server (node pool), gli aggiornamenti di sicurezza delle macchine operative (patching dei worker) e le policy di rete e sicurezza. Dalla nostra esperienza sui progetti di migrazione, è proprio questa “zona grigia” a determinare il costo operativo reale: due team con lo stesso cluster gestito possono avere carichi molto diversi a seconda di come automatizzano l’upgrade dei nodi e l’autoscaling.
| Soluzione | Control plane | Nodi/compute | Caso d’uso tipico |
|---|---|---|---|
| Kubernetes self-managed | A carico del team | A carico del team | Air-gapped, sovranità dei dati, hardware dedicato |
| Amazon EKS / Google GKE / Azure AKS | Gestito dal provider | Node pool gestiti dal team (o autopilot) | Workload production con controllo su networking e sicurezza |
| GKE Autopilot / EKS Fargate profile | Gestito dal provider | Astratto e gestito dal provider | Team che vogliono Kubernetes senza gestire i nodi |
| AWS Fargate / Google Cloud Run | Non esposto | Astratto (pay-per-use) | Servizi stateless, event-driven, scaling a zero |
Le soluzioni serverless container spingono l’astrazione ancora più in là. Con AWS Fargate o Google Cloud Run non si gestiscono né control plane né nodi: si definisce l’immagine del container, i limiti di CPU e memoria e le regole di scaling, e la piattaforma alloca la capacità on demand, fino allo scale-to-zero quando non c’è traffico. Questo modello è particolarmente efficace per servizi che non conservano dati in locale (stateless), API a traffico variabile e carichi di lavoro basati su eventi (event-driven), dove pagare solo per il tempo di esecuzione effettivo riduce i costi rispetto a un cluster sempre attivo.
La scelta non è binaria. In diversi progetti, come abbiamo approfondito analizzando i casi di aziende che usano Kubernetes con successo, abbiamo adottato architetture ibride. Ad esempio, nel settore media ed e-commerce, abbiamo mantenuto il core dei microservizi su un cluster GKE o EKS per avere pieno controllo su networking, gestione avanzata delle comunicazioni (service mesh) e monitoraggio profondo (observability), spostando i carichi di lavoro periferici o a picchi imprevedibili su Cloud Run.
Nella nostra esperienza questa configurazione ha permesso di ridurre i costi infrastrutturali in modo significativo. Il criterio che applichiamo è pragmatico: il valore aggiunto di gestire un cluster deve superare il suo costo operativo. Se il team spende più tempo a mantenere l’infrastruttura Kubernetes che a produrre valore applicativo, un servizio gestito o un runtime serverless tende a essere, nella maggior parte dei casi che abbiamo incontrato, l’opzione più conveniente, anche a fronte di una minore flessibilità di configurazione. Resta comunque una valutazione da calare nel contesto specifico, perché vincoli normativi, requisiti di performance o esigenze di personalizzazione possono spostare l’equilibrio.
Vuoi valutare quale approccio architetturale sia più adatto al tuo caso d’uso? Scopri il nostro servizio di consulenza Kubernetes per progettare un’infrastruttura su misura.
Come si integra il paradigma GitOps nell’orchestrazione?
Gestire lo stato di un cluster Kubernetes tramite comandi imperativi (istruzioni eseguite manualmente, script sparsi tra le macchine dei singoli operatori) è una pratica che genera rapidamente il cosiddetto drift di configurazione, ovvero una deriva per cui lo stato reale e operativo del cluster si allontana progressivamente da quello originariamente progettato. Il paradigma GitOps risolve questo problema alla radice, promuovendo un repository Git a unica fonte di verità per la configurazione dell’infrastruttura e delle applicazioni.
Il principio è semplice ma potente: tutto lo stato desiderato del cluster è descritto in modo dichiarativo (specificando il risultato finale voluto, tramite file di configurazione come manifest YAML, chart Helm o definizioni Kustomize) e salvato in modo tracciabile su Git. Non è più un operatore a forzare le modifiche verso il cluster; è invece un agente installato nel cluster stesso a monitorare il repository e a occuparsi della riconciliazione, ovvero ad allineare continuamente lo stato reale del sistema con quello dichiarato. Ogni modifica passa quindi attraverso un processo di revisione condiviso (pull request), con tutti i vantaggi che ne derivano: controllo del codice, tracciabilità completa delle operazioni e possibilità di annullare immediatamente un errore.
In questo modello si inseriscono i due strumenti di riferimento dell’ecosistema Cloud Native, entrambi progetti CNCF:
Argo CD7: adotta un modello in cui l’agente “tira” a sé le modifiche (pull-based) e offre un’interfaccia visiva che mostra in tempo reale l’allineamento tra Git e il cluster, evidenziando graficamente eventuali disallineamenti. È particolarmente apprezzato per la gestione di più cluster contemporaneamente e per l’integrazione con rilasci graduali.
Flux8: costruito attorno ai meccanismi di controllo nativi di Kubernetes, si distingue per un approccio modulare e per il supporto eccellente ai pacchetti Helm9 e all’automazione degli aggiornamenti delle immagini dei container.
Il flusso operativo che ne risulta separa nettamente la fase di integrazione (CI), che produce e testa i componenti software (artefatti), dalla fase di distribuzione (CD), che diventa responsabilità esclusiva dell’agente GitOps. In pratica, lo sviluppatore invia il codice al repository applicativo, innescando la procedura automatizzata (pipeline CI) che compila e testa l’immagine per poi salvarla nel registro dei container (Container Registry). Successivamente, il sistema aggiorna i file descrittivi (manifest) nel repository di configurazione. A questo punto, l’agente GitOps (come Argo CD o Flux) monitora continuamente il repository e si occupa della riconciliazione automatica, applicando lo stato desiderato al cluster Kubernetes e verificando costantemente che non ci siano scostamenti.
Dalla nostra esperienza sui progetti Cloud Native, il valore concreto di GitOps non risiede solo nell’automazione, ma nel fatto che il cluster diventa auto-riparante rispetto alle modifiche non tracciate: se qualcuno altera manualmente una risorsa, l’agente rileva la divergenza e ripristina lo stato dichiarato in Git. Questo trasforma l’orchestrazione da attività operativa a pratica ingegneristica governata dallo stesso rigore che applichiamo al codice applicativo.
Se desideri implementare queste pratiche nella tua organizzazione, scopri i nostri servizi di DevOps automation per ottimizzare i flussi di rilascio.
In sintesi: perché scegliere l’orchestrazione e Kubernetes?
I container sono una forma di virtualizzazione che permette di costruire, impacchettare e fare deployment delle applicazioni. La presenza di tutto il codice dell’applicazione e di tutto quello che serve a farla funzionare all’interno del container permette di spostare i carichi di lavoro in maniera semplice tra server di tipo diverso.
La complessità derivante dalla suddivisione in container richiede processi di orchestrazione avanzati. Kubernetes si conferma lo standard di mercato, garantendo scalabilità, affidabilità e performance in logica Cloud Native. Tuttavia, governare questi ecosistemi richiede competenze specialistiche e un approccio strategico.
Se la tua azienda ha bisogno di supporto per modernizzare l’infrastruttura, ottimizzare i costi cloud o delegare la gestione operativa dei cluster, esplora i nostri Managed Services e i nostri servizi di DevOps automation e trasforma le tue sfide tecnologiche in un vantaggio competitivo.

Note e fonti
Macchine virtuali e containers, vantaggi e differenze. (fonte: https://www.sentinelone.com/it/cybersecurity-101/cloud-security/containerization-vs-virtualization/) ↩︎
Kubernetes, Kubernetes is an open-source container orchestration system for automating software deployment, scaling, and management. (fonte: https://en.wikipedia.org/wiki/Kubernetes) ↩︎
Docker Swarm, Docker Swarm is a native container orchestration feature built into Docker Engine, enabling users to deploy and manage a cluster of Docker nodes as a single virtual system. (fonte: https://docs.docker.com/engine/swarm/) ↩︎
Docker, Docker is an open-source platform that enables developers to build, deploy, run, update, and manage containerized applications. (fonte: https://www.ibm.com/think/topics/docker) ↩︎
Apache Mesos, Apache Mesos was an open-source cluster manager and distributed systems kernel that abstracted compute resources. It was retired by the Apache Software Foundation in August 2025. (fonte: https://attic.apache.org/projects/mesos.html) ↩︎
Horizontal Pod Autoscaler, A Kubernetes API resource and controller that automatically scales workload resources, such as Deployments, to match demand based on observed metrics. (fonte: https://docs.okd.io/4.16/nodes/pods/nodes-pods-autoscaling.html) ↩︎
Argo CD, Argo CD is a declarative, GitOps continuous delivery tool for Kubernetes that automates application deployment and lifecycle management. (fonte: https://argoproj.github.io/cd/) ↩︎
Flux, Flux is a CNCF graduated continuous delivery tool for Kubernetes. It implements GitOps by automatically reconciling the cluster’s actual state with the desired state defined in a Git repository. (fonte: https://www.cncf.io/projects/flux/) ↩︎
Helm, Helm is an open-source package manager for Kubernetes that simplifies application deployment by bundling Kubernetes manifests into reusable packages called Helm charts. (fonte: https://github.com/helm/helm) ↩︎