Cloud native indica un modo di costruire applicazioni come insieme di microservizi indipendenti, distribuiti in container e gestiti su piattaforme cloud. In questo modello il problema centrale non è scrivere i singoli servizi ma coordinare le loro interazioni, e le due strade sono Orchestration e Choreography. Nessuna delle due vince a priori: pesano il numero di servizi coinvolti in un flusso, chi deve possedere la logica di business e quanti fallimenti si è disposti a gestire a mano. Analizziamo funzionamento, pro e contro di Orchestrazione, Choreography e approccio Ibrido.
Prima di entrare nei dettagli conviene collocare i due approcci rispetto alle tre architetture che si incontrano nei progetti di migrazione: monolitica, cloud enabled e cloud native. Orchestrazione e coreografia diventano una scelta reale solo nell’ultima colonna; nelle prime due il coordinamento resta nascosto dentro il codice.
| Caratteristica | Monolitico | Cloud Enabled | Cloud Native |
|---|---|---|---|
| Struttura | Unico deployable, moduli accoppiati | Monolite o pochi servizi grossi spostati su VM o container in cloud | Microservizi indipendenti, ognuno con ciclo di rilascio proprio |
| Comunicazione tra componenti | Chiamate in-process | Perlopiù sincrona (REST, RPC), spesso verso un database condiviso | Sincrona o a eventi, con message broker e contratti API espliciti |
| Scalabilità | Dell’intera applicazione | Orizzontale, replicando l’intero blocco | Per singolo servizio |
| Coordinamento dei flussi | Nel codice, transazione unica | Nel codice, con qualche coda esterna | Orchestration (servizio coordinatore) o Choreography (eventi) |
| Gestione dei fallimenti | Rollback transazionale | Retry manuali, stato condiviso | Saga, compensazioni, idempotenza |
| Quando ha senso | Dominio piccolo, team unico | Migrazione lift and shift senza riscrivere | Dominio ampio, più team, rilasci frequenti |
Cloud native indica applicazioni progettate fin dall’inizio per il cloud: servizi indipendenti, eseguiti in container, distribuiti e scalati singolarmente. Un’applicazione a microservizi costruita così si distingue dall’architettura monolitica per un motivo pratico: il monolite chiama le proprie funzioni in memoria, i microservizi devono parlarsi attraverso la rete. Chi decide chi chiama chi, in quale ordine, e cosa succede quando un servizio non risponde? A questa domanda rispondono due approcci differenti: Orchestration vs Choreography.
Prima di confrontarli conviene distinguere il cloud native da ciò che spesso viene venduto come tale, perché il problema del coordinamento tra servizi nasce solo nell’ultima colonna di questa tabella.
| Approccio | Struttura dell’applicazione | Deploy e scalabilità | Comunicazione tra componenti | Orchestration o choreography? |
|---|---|---|---|---|
| Monolitico | Un unico codebase e un unico processo | Si rilascia e si scala tutto insieme, anche se il collo di bottiglia è un solo modulo | Chiamate di funzione in memoria, transazioni su un solo database | Non serve: il flusso è nel codice |
| Cloud Enabled | Monolite migrato su infrastruttura cloud, spesso in una VM o in un container di grandi dimensioni | Beneficia dell’elasticità dell’infrastruttura, ma resta un blocco unico da rilasciare | Invariata rispetto al monolite | Non serve: cambia dove gira, non come è fatto |
| Cloud Native | Microservizi indipendenti, ciascuno con il proprio ciclo di vita e i propri dati | Ogni servizio si rilascia e si scala da solo, tipicamente su Kubernetes | Chiamate di rete sincrone (REST, gRPC) o eventi asincroni (Kafka, RabbitMQ) | Indispensabile: va scelto come far cooperare i servizi |
In questo approfondimento faremo dapprima un passo indietro, per definire bene il contesto. Vedremo poi nel dettaglio come sono strutturati i due approcci: Orchestration e Choreography. Infine, cercheremo di capire in che misura è possibile usarli entrambi, in quali situazioni possono essere applicati e con quali limiti.
Orchestration vs Choreography: come coordinare i microservizi in un’architettura cloud native
Le applicazioni Cloud Native sono quasi sempre costruite come un set di microservizi eseguiti in container (Docker è il caso più diffuso), che vengono rilasciati e aggiornati tramite pipeline CI/CD (Continuous Integration/Continuous Deployment) e pratiche DevOps. Per il quadro completo di principi, strumenti e modelli architetturali rimandiamo alla nostra guida completa alle applicazioni Cloud Native.
Ci sono diverse possibilità. Uno dei modelli possibili è quello “serverless”, offerto ad esempio daAWS Lambda, che esegue blocchi di codice in risposta a determinati eventi e gestisce automaticamente le risorse di elaborazione sottostanti.
Tornando alla microservice architecture , il vantaggio consiste nel suddividere l’applicazione in una serie di servizi componibili e riusabili. Servizi piccoli, leggeri e facili da implementare determinano costi di sviluppo e modifica più bassi e permettono di scalare in maniera facile e veloce.
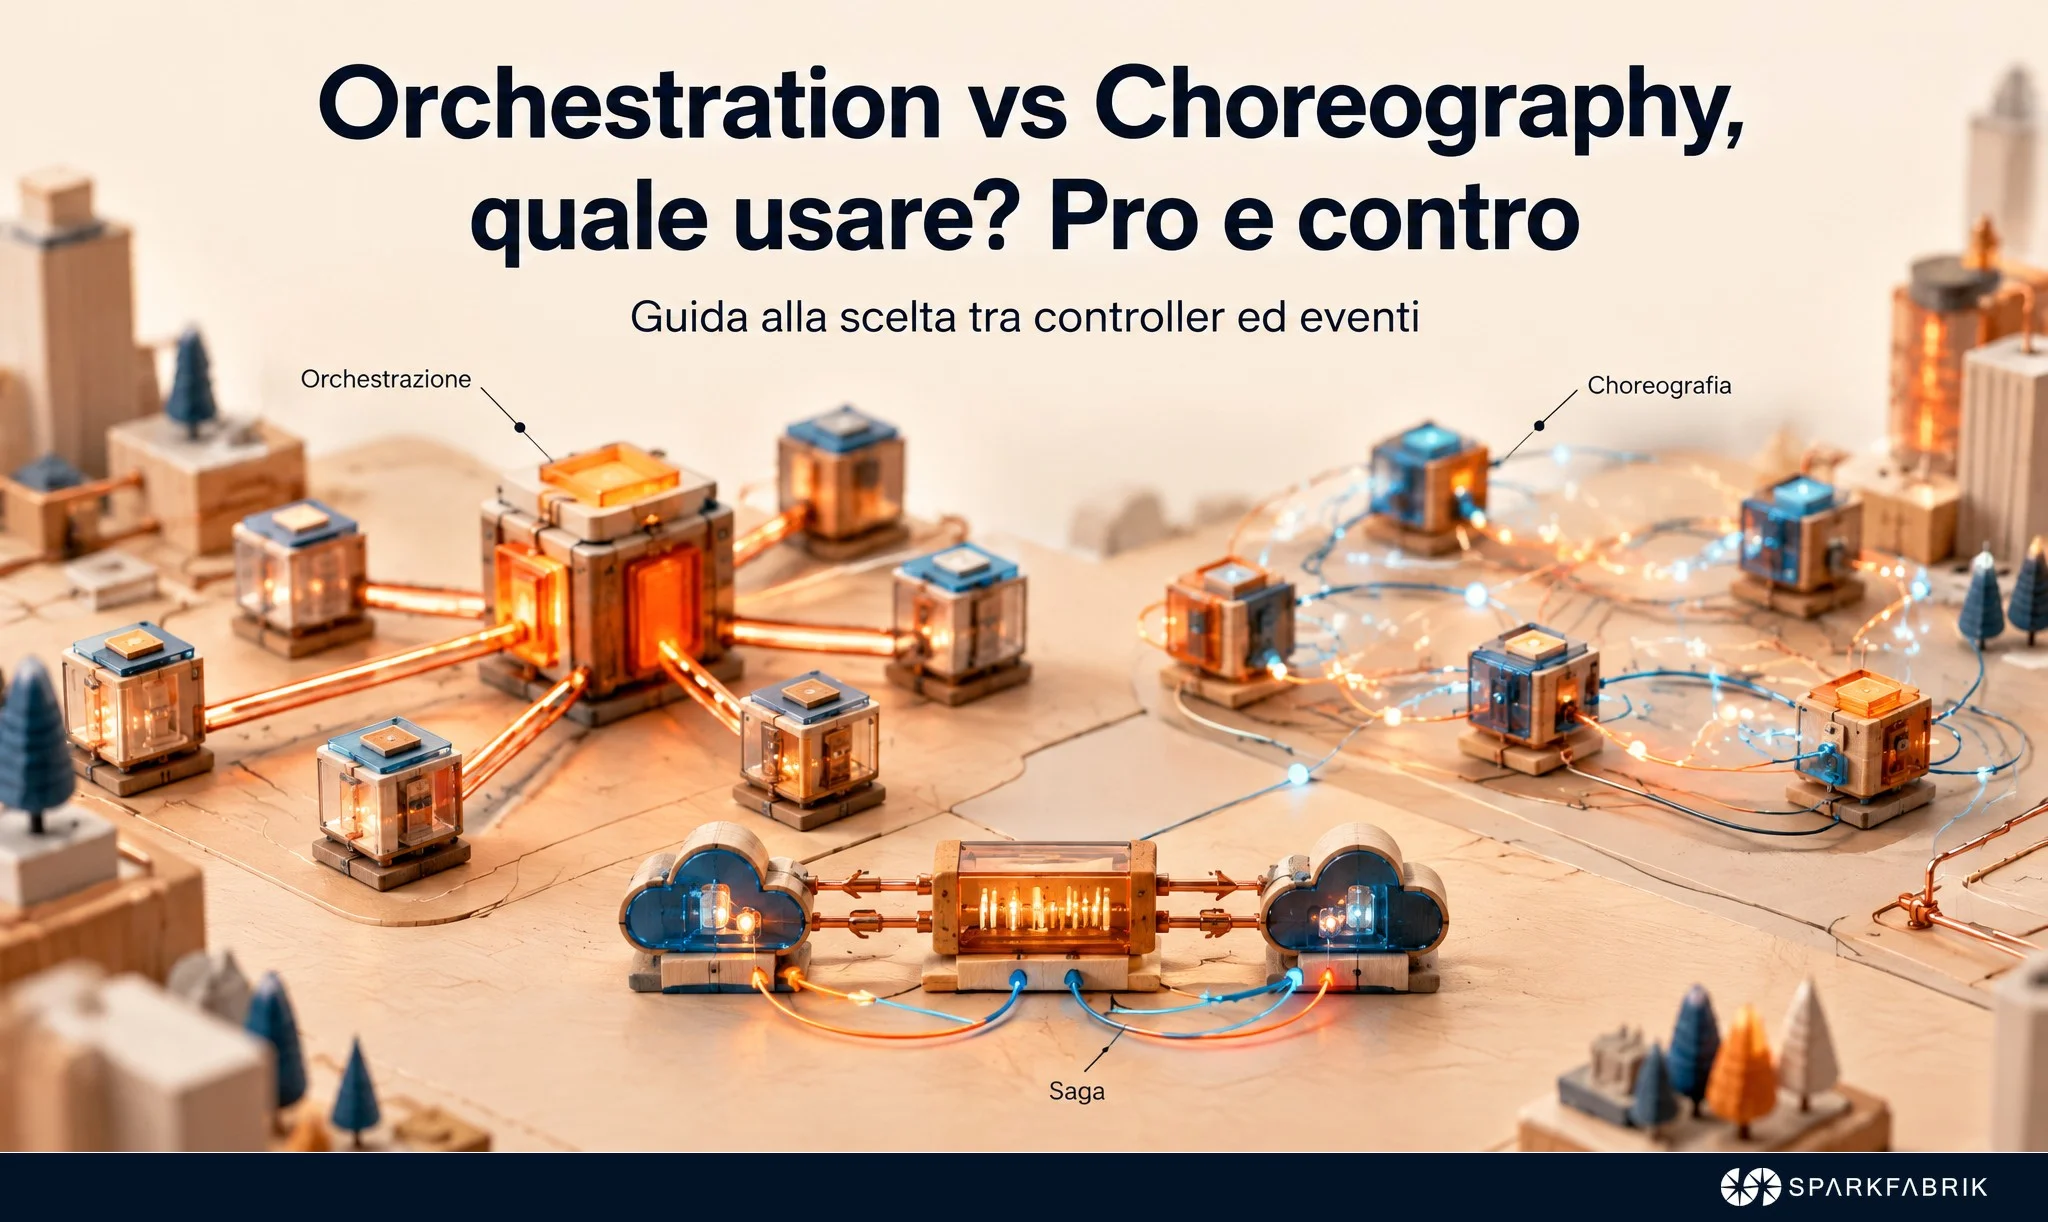
Per far funzionare questo sistema è necessario utilizzare un metodo di coordinamento che consenta ai microservizi di lavorare assieme. Esistono sostanzialmente due approcci: l’Orchestration e la Choreography , termini inglesi che non solo corrispondono perfettamente all’equivalente italiano di “orchestrazione” e “coreografia”, ma che ne rispecchiano anche il senso che ne viene dalle arti performative.
Certo, come tutte le analogie anche questa non è perfetta, ma coglie la differenza fondamentale tra i due approcci. L’orchestra ha un direttore che indica agli orchestrali cosa devono fare momento dopo momento. La coreografia, invece, viene studiata e progettata dal coreografo prima, e i ballerini durante l’esecuzione si muovono in maniera libera. Non vengono controllati, ma scelgono cosa fare di volta in volta sulla base della coreografia che hanno appreso e della musica che sta suonando.
Cos’è e come funziona l’Orchestration
Come abbiamo detto e come suggerisce il nome, l’Orchestration è basata sull’idea di un sistema centrale che controlla tutte le interazioni tra i vari elementi del sistema, cioè i microservizi.
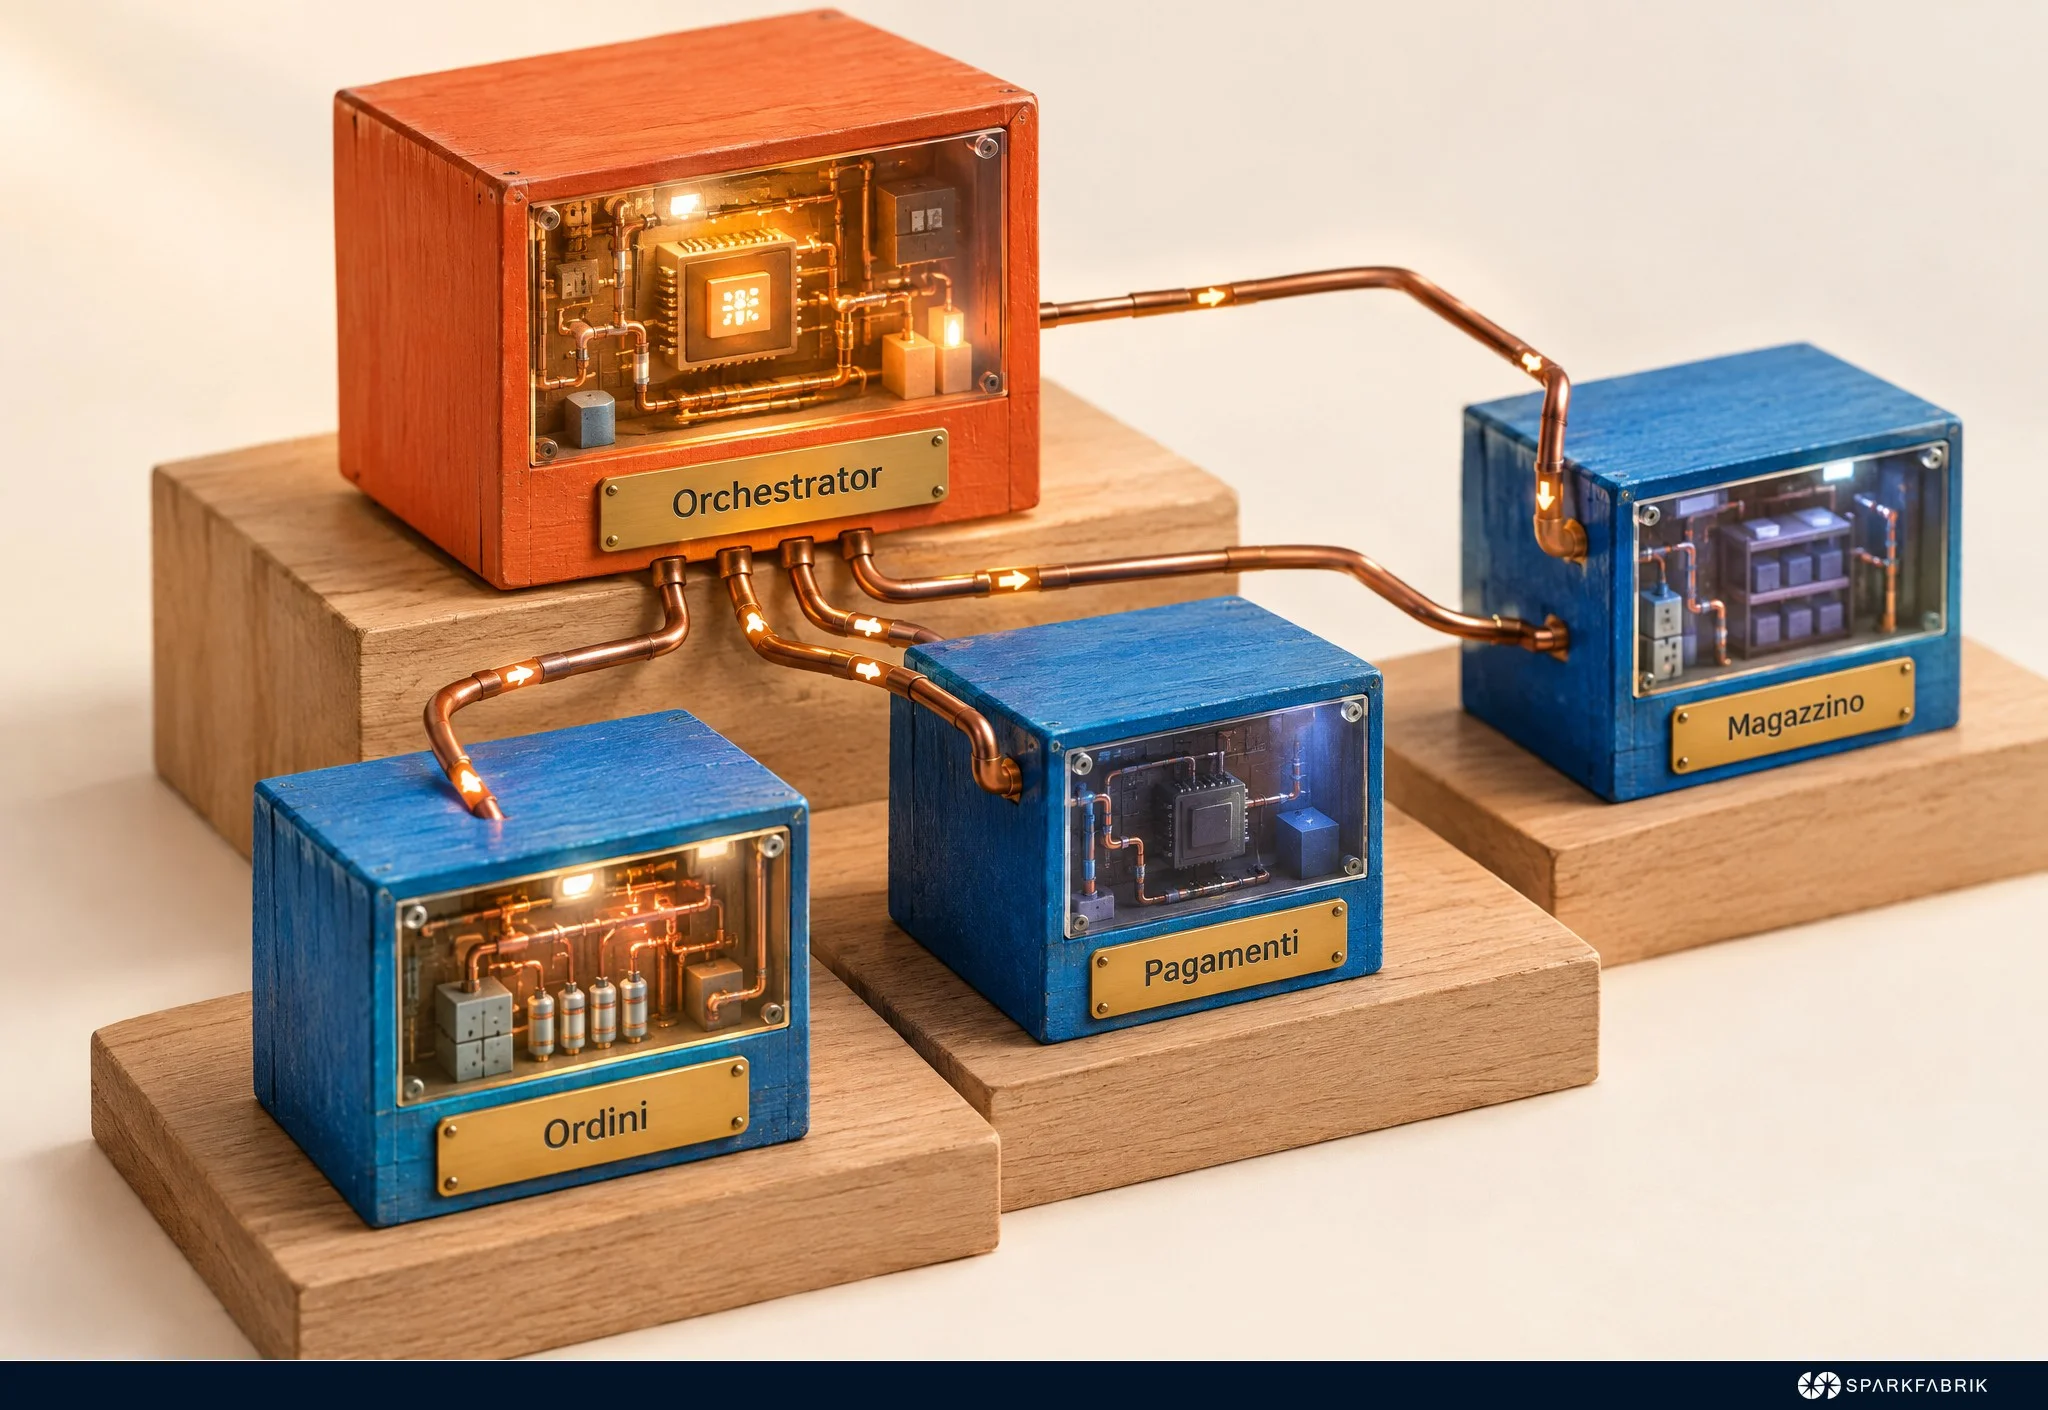
In questo approcciola parola chiave è “supervisione” : il controllo del rispetto delle singole istruzioni. Nell’Orchestration, infatti, esiste un servizio che fa da controller e che gestisce le comunicazioni tra i singoli microservizi. Così facendo garantisce che ciascun servizio esegua la parte che gli è stata assegnata.
Il controller è un vero e proprio middleware , cioè un software che fornisce alle applicazioni delle funzionalità e dei servizi comuni. In generale, possiamo pensare al middleware come al tessuto connettivo tra diversi layer applicativi. Nel caso particolare dell’Orchestration, la componente di middleware ha la funzione di supervisore che controlla le interazioni tra i vari microservizi.
L’orchestrazione copre una gamma ampia di compiti. Per esempio, Kubernetes consente di gestire in maniera dichiarativa le risorse orchestrate astraendo il livello fisico sottostante: nodi e macchine diverse vengono trattati come un unico pool di risorse computazionali.
La gestione della configurazione dichiarativa avviene tramite un loop di controllo**. Proprio come fa un termostato in una stanza: definito lo stato desiderato il termostato verifica lo stato corrente e agisce per portarlo il più vicino possibile a quello desiderato. Nel caso di Kubernetes, icontroller osservano il cluster e quando è necessario effettuano o richiedono delle modifiche allo stato corrente.
In sintesi, l’approccio “orchestrato” si basa sull’idea di creare un sistema digestione dei processi di business(Business Process Management, o BPM) centralizzato e ben organizzato che sia in grado di dare stabilità all’applicazione e renderne lo stato facilmente misurabile e modificabile.
Orchestrare i container non è orchestrare i processi
Kubernetes e un orchestratore di processi come Temporal o Camunda condividono il nome, ma lavorano su due livelli che non si toccano. Kubernetes coordina il livello computazionale: decide su quale nodo eseguire un pod, lo riavvia se muore, ne aumenta le repliche quando la CPU supera una soglia, espone un servizio agli altri. Non sa che il pod dei pagamenti deve essere chiamato dopo quello degli ordini e prima di quello dell’inventario, né cosa fare se il pagamento fallisce. Per Kubernetes esistono container sani o non sani, non ordini pagati o rimborsati.
Un orchestratore di workflow ragiona invece sul livello applicativo. Temporal, Camunda, Netflix Conductor o AWS Step Functions persistono lo stato di ogni istanza di processo, gestiscono retry, timeout e compensazioni, e sanno esattamente a che passo si trova ogni singola transazione di business. Il loro codice, per inciso, gira quasi sempre dentro pod Kubernetes: i due livelli si sovrappongono fisicamente proprio perché sono logicamente indipendenti.
| Livello | Cosa coordina | Stato che gestisce | Esempi | Guasto che risolve |
|---|---|---|---|---|
| Infrastruttura | Container, pod, nodi, rete | Repliche desiderate vs attive, salute dei processi | Kubernetes, Docker Swarm, Nomad | Un pod si blocca e viene ricreato |
| Applicazione | Passi di un processo di business | Istanze di workflow, esito di ogni step, compensazioni | Temporal, Camunda, Conductor, Step Functions | Il pagamento fallisce e l’ordine viene annullato |
La confusione tra i due ha una conseguenza pratica che incontriamo in fase di assessment: “usiamo Kubernetes, quindi la nostra architettura è orchestrata”. Falso. Lo abbiamo sentito dire da un e-commerce il cui checkout era distribuito su una decina di servizi coreografati via Kafka, senza alcun controller applicativo: quando il gateway di pagamento andava in timeout, l’ordine restava confermato a magazzino ma mai addebitato, perché nessun componente gestiva la compensazione. Il loop di controllo di Kubernetes descritto sopra è un buon esempio di orchestratore, ma lavora sui container, così come un monolite su una singola VM può contenere un motore BPMN; la scelta tra Orchestration e Choreography riguarda il livello applicativo e va presa a prescindere da come vengono schedulati i pod, come mostriamo nella nostra guida alle applicazioni cloud native.
Strumenti per l’orchestrazione
Gli strumenti di orchestrazione si dividono su due livelli. Per i container Kubernetes è lo standard di fatto e l’esempio più noto di orchestratore: schedula i pod, li riavvia, li scala. Per i processi di business lavorano invece orchestratori di workflow come Temporal, Camunda e AWS Step Functions, che persistono lo stato di ogni istanza e gestiscono retry e compensazioni.
La Cloud Native Computing Foundation (CNCF), che ospita il progetto Kubernetes, supporta anche altri orchestratori, con gradi di maturità molto diversi. Crossplane ha completato il percorso di incubazione e nel 2025 ha raggiunto lo stato di progetto graduated, lo stesso livello di maturità di Kubernetes1, diventando il riferimento per il control plane management; restano invece nelle fasi intermedie del percorso CNCF (sandbox o incubation) altri cinque orchestratori: Fluid, Karmada, Open Cluster Management, Volcano e wasmCloud.
Leggi anche: Cos’è l’orchestrazione dei container e come farla con Kubernetes**
I limiti dell’Orchestration
Vediamo ora in sintesi quali sono gli svantaggi dell’ Orchestration approach.
Latenze e problemi di disponibilità di servizio
Nell’orchestrazione il controller deve comunicare direttamente con ciascun servizio per potergli indicare cosa deve fare. Deve quindi attendere che la comunicazione sia stabilita e il servizio risponda.
Quando l’architettura è costituita da centinaia o migliaia di microservizi, si possono creareproblemi di disponibilità del servizio o latenze eccessive.
Il limite non è un numero fisso di microservizi, ma il fan-out del controller: se l’orchestratore, per completare una transazione, chiama in serie otto servizi con una latenza di rete di 30-50 ms ciascuno, il tempo di risposta nel caso peggiore è la somma delle otto chiamate, non la più lenta. Un checkout che in isolamento risponde in 80 ms si ritrova con un p95 sopra i 400 ms, e ogni servizio aggiunto alla catena sposta quel percentile di qualche decina di millisecondi. Quando il controller coordina più di una decina di dipendenze sincrone per singola operazione, e ogni modifica a una di esse richiede di aggiornare anche la sua logica, si è di fatto ricostruito un monolite dentro un ambiente distribuito: un punto unico di deploy, di failure e di latenza, con in più il costo della rete tra un passo e l’altro.
Troppa dipendenza tra i microservizi
L’orchestrazione crea una forte dipendenza tra i singoli servizi , soprattutto quando agiscono in maniera sincrona. Un servizio deve rispondere alle richieste di un altro in maniera esplicita.
Quando le relazioni prevedono un accoppiamento così serrato (tight coupling), ogni rottura di qualsiasi anello della catena può bloccare l’intero processo. In un ambiente enterprise, con migliaia di microservizi che vengono utilizzati per una singola funzione di business, l’approccio uno-a-uno non è in grado di scalare.
API RESTful e difficile scalabilità
A proposito di scalabilità, la terza criticità dell’approccio Orchestration è l’uso delle API di tipo RESTful , che sono a loro volta dei servizi strettamente connessi. Le API di tipo RESTful sono definite da un insieme di vincoli architetturali per sistemi distribuiti. Comunicano via HTTP in modalità stateless per la condivisione di risorse in maniera uniforme, usando una sintassi universale e un identificatore globale.
Dal nostro punto di vista l’uso di API di tipo RESTful ha l’effetto di serrare in maniera ancora più forte l’accoppiamento dei servizi nell’architettura , aumentando il costo e l’impatto sulle API di qualsiasi funzionalità si voglia aggiungere o togliere. Anche qui, in ultima analisi, il problema è riuscire a scalare.
L’approccio Choreography: cos’è e come funziona
La coreografia utilizza un approccio completamente diverso e fondamentalmente decentralizzato. Per sfruttare ancora la metafora del corpo di ballo, si può dire che le coreografie dei servizi non vengono eseguite, bensì vengono messe in scena.
Con questo si intende dire che la messa in scena avviene quando i partecipanti eseguono i loro ruoli in maniera autonoma. Nessun elemento esegue un ordine esplicito, bensì ciascuno conosce una serie di azioni che deve compiere in relazione agli altri elementi con cui interagisce.
L’approccio coreografico si basa sull’idea che un elemento di controllo centrale, l’orchestratore (il middleware, come Kubernetes) sia ridondante. I singoli componenti, cioè i microservizi, devono essere capaci di autogestirsi senza intervento esterno e accoppiati in maniera loose (loose coupling) e non tight (tight coupling) , cioè in modo largo e non troppo serrato.
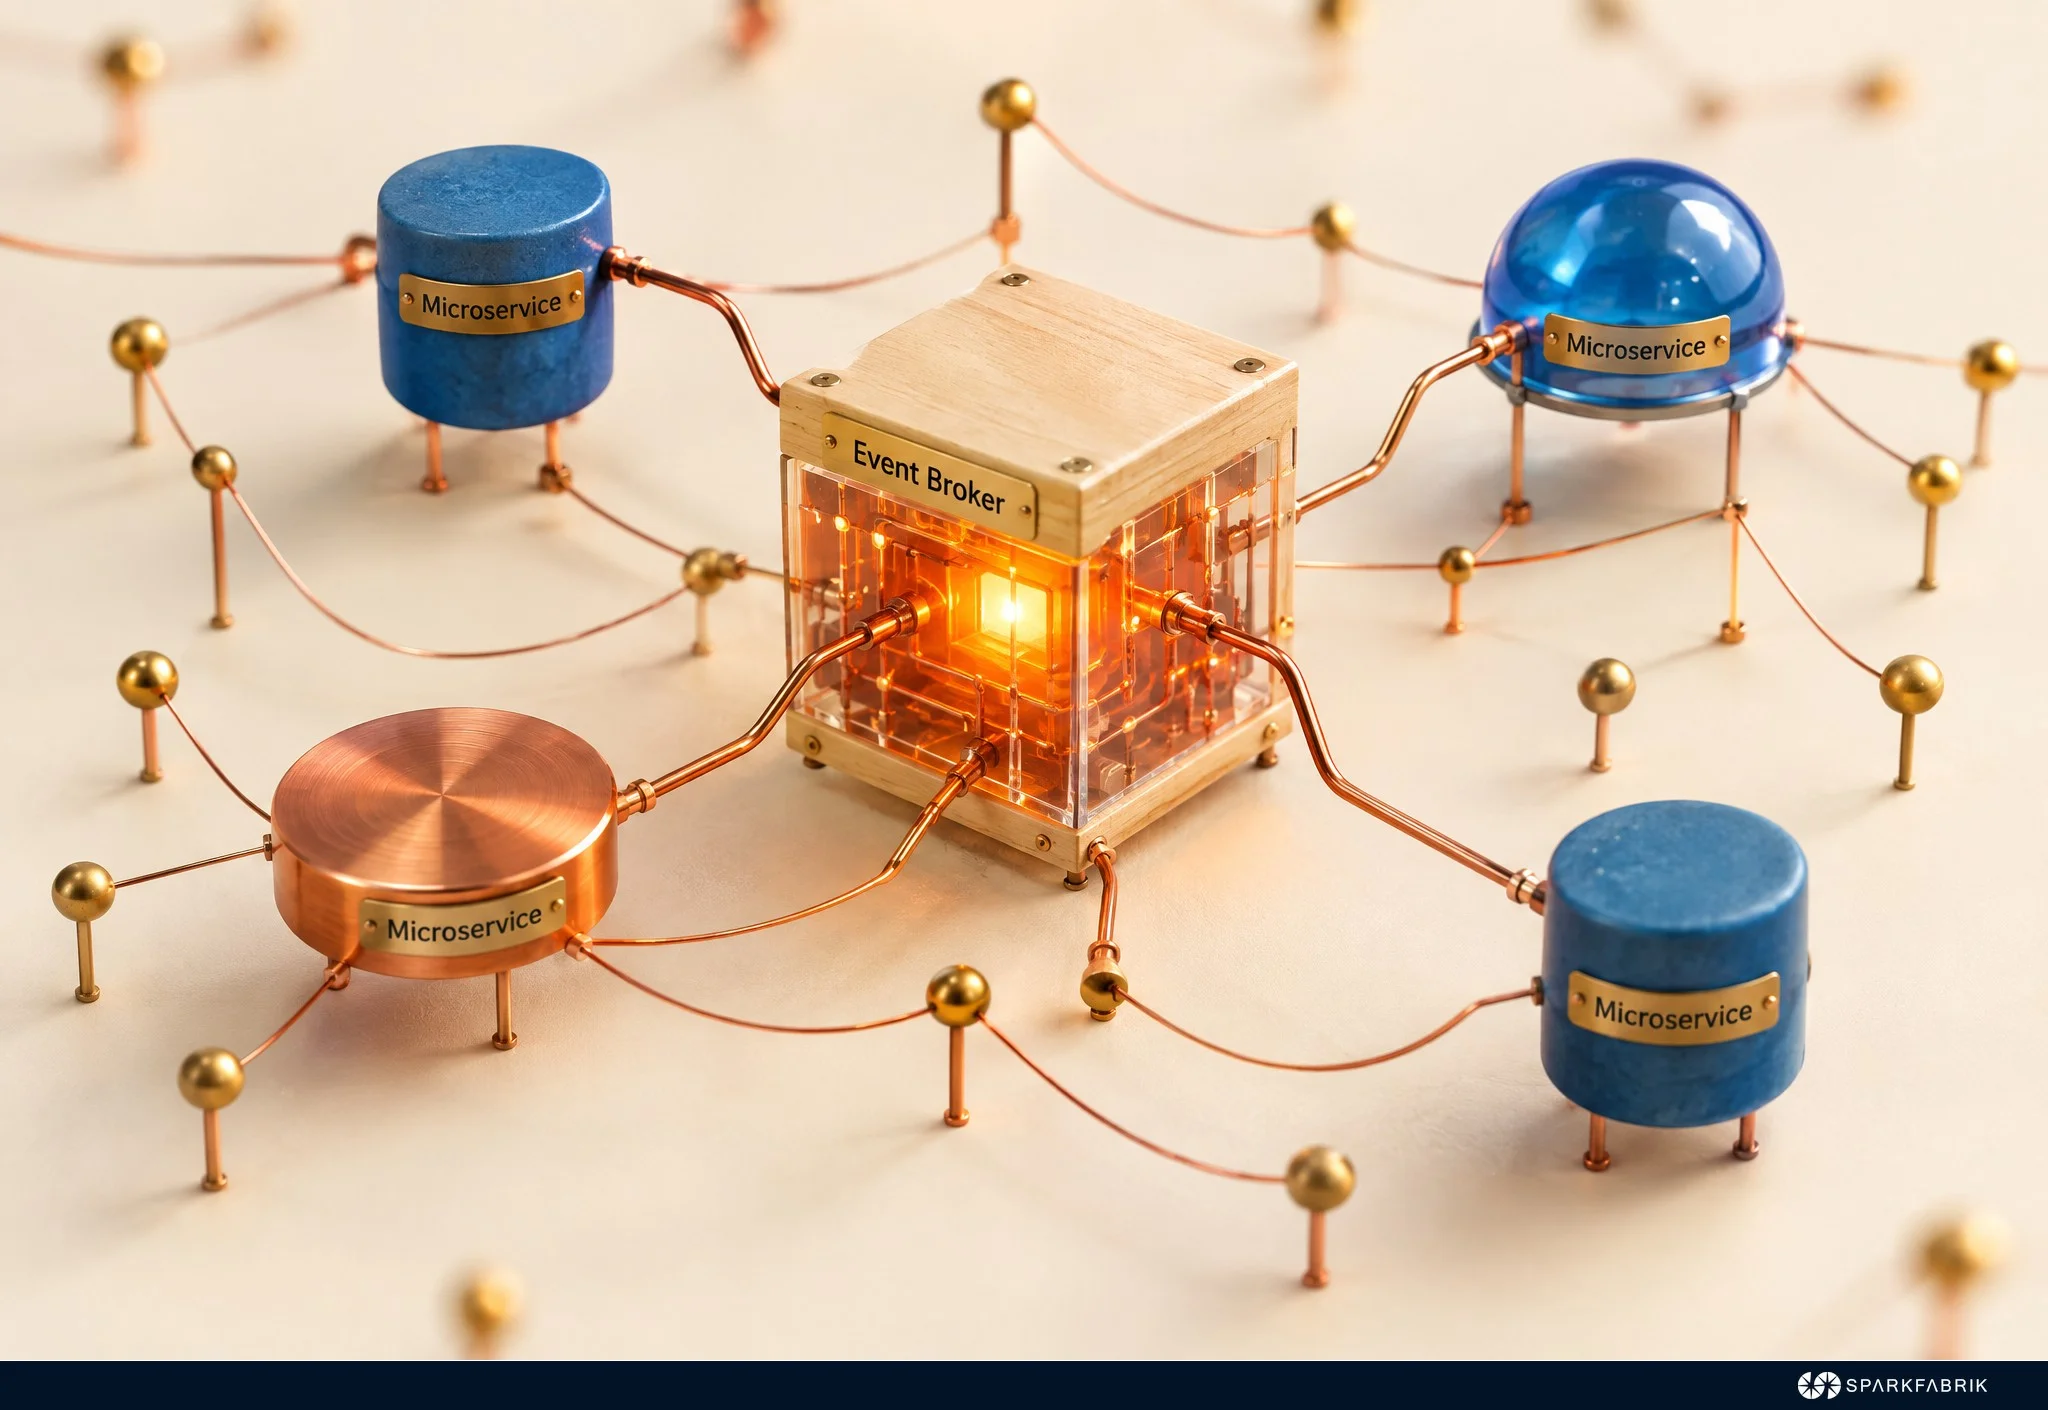
Questo vuol dire chei microservizi loosely coupleddevono essere in grado di fornire da soli il maggior valore possibile per il business , senza avere un impatto diretto sugli altri componenti. In questa maniera la complessità si riduce perché non c’è un controller da programmare e gestire. Inoltre, come intuibile, non c’è un unico nodo, cioèun elemento potenzialmente critico per tutta l’infrastruttura in caso di problemi.
Ma in che modo avvengono gli scambi di messaggi tra i microservizi in assenza di un middleware?
Per questa attività nell’approccio Choreography si utilizza una componente chiamata “event broker” (o message broker). La coreografia avviene secondo una sequenza di step. Ogni microservizio che ha svolto un’azione spedisce un messaggio su determinati canali. Gli altri microservizi, iscritti a quello specifico canale, ricevono il messaggio. A quel punto sanno da soli cosa devono fare, perché sono progettati per rispondere in automatico a determinati eventi (event driven).
In questo senso la comunicazione avviene in maniera asincrona e il coordinamento, per tornare all’analogia della danza coreografata, è quella tra ballerini (i microservizi) che ascoltano la musica (l’Event Broker) per danzare.
Utilizzare una logica di** loose service couplingpermette di cambiare i microservizi(aggiungendone o togliendone a seconda del bisogno) senza che la logica sottostante venga resa inservibile e debba essere riscritta.
Strumenti per la Choreography
Come per l’orchestrazione, anche in questo ambito sono disponibili soluzioni diverse.
Il cuore di un’architettura choreography è l’event broker che citavamo prima: è lui a garantire il disaccoppiamento reale tra i microservizi, perché chi pubblica un evento non sa e non deve sapere chi lo consumerà. Gli esempi più diffusi sono Kafka, un log distribuito che conserva gli eventi e permette di rileggerli, e RabbitMQ , un broker AMQP che li instrada tramite exchange e code; in ambito AWS il ruolo lo ricopre Amazon SQS, che AWS inquadra insieme a SNS ed EventBridge nella sua panoramica sulle architetture event-driven.
Inoltre, in un’architettura event driven si integrano bene due strumenti con ruoli distinti: un service mesh come Istio, che governa il traffico di rete tra i servizi (mTLS, retry, routing), e Dapr (Distributed Application Runtime), progetto CNCF graduated dal 2024, che opera a livello applicativo e fornisce building block pronti per pub/sub, state management e workflow, astraendo il broker di messaggi sottostante.
I limiti dell’approccio Choreography
La Choreography automatizza lo scambio di messaggi asincroni tra microservizi con una logica di controllo distribuita, basata sugli eventi e pensata per far girare processi che attraversano domini diversi. Il vantaggio è duplice: elimina i single point of failure e permette di scalare senza perdita di performance. Si possono inoltre cambiare i processi senza compromettere la logica applicativa definita dai singoli microservizi.
Tuttavia, anche l’approccio basato sulla coreografia determina alcune criticità. Vediamole di seguito.
Il cambio di mentalità è un prerequisito
La necessità di cambiare mentalità e modo di pensare al funzionamento dei microservizi rappresenta un prerequisito. In questo senso possiamo considerarlo un limite: non tutti sono in grado di applicare l’approccio Choreography.
Gestire l’intero processo è più difficile
Con la coreografiail processo di business viene letteralmente sparpagliato nei vari microservizi , ciascuno dei quali ha una maggiore autonomia perché accoppiato in maniera più loose agli altri. Questo rende più difficile mantenere la vista d’insieme , cioè il processo complessivo, e riuscire a gestirlo.
Complessità elevata
Infine, il limite maggiore dell’approccio coreografico ai microservizi è la complessità. Ogni servizio identifica la logica che lo riguarda e reagisce in maniera indipendente, sulla base dei messaggi che gli stanno arrivando dai canali che ascolta. Il rischio di non riuscire a far funzionare questa architettura è elevato.
La terza via: l’approccio ibrido
Una terza via alla gestione dei microservizi è basata su un approccio ibrido - o hybrid approach - che contiene allo stesso tempo parti sincrone e asincrone.
L’approccio ibrido prevede la parte centralizzata - basata sull’orchestrazione - per quanto riguarda i singoli servizi, e la parte coreografata per quanto riguarda il modo con il quale i servizi comunicano tra di loro.
Questo approccio permette di usare l’orchestratore per avere una migliore visibilità e controllo dei microservizi, mentre la coreografia serve per far eseguire il flusso di lavoro dei singoli microservizi in maniera separata e autonoma.
Il Saga Pattern: orchestrazione e coreografia alla prova delle transazioni distribuite
Il banco di prova più concreto per confrontare i due approcci è la coerenza dei dati. In un monolite un checkout che crea l’ordine, addebita il pagamento e scala il magazzino vive dentro una singola transazione ACID: se il pagamento fallisce, il database fa rollback di tutto. Con tre microservizi e tre database separati quella transazione non esiste più, e il Saga Pattern la sostituisce con una sequenza di transazioni locali, ciascuna accompagnata da una transazione di compensazione che annulla l’effetto della precedente (rimborso del pagamento, ripristino della giacenza, annullamento dell’ordine).
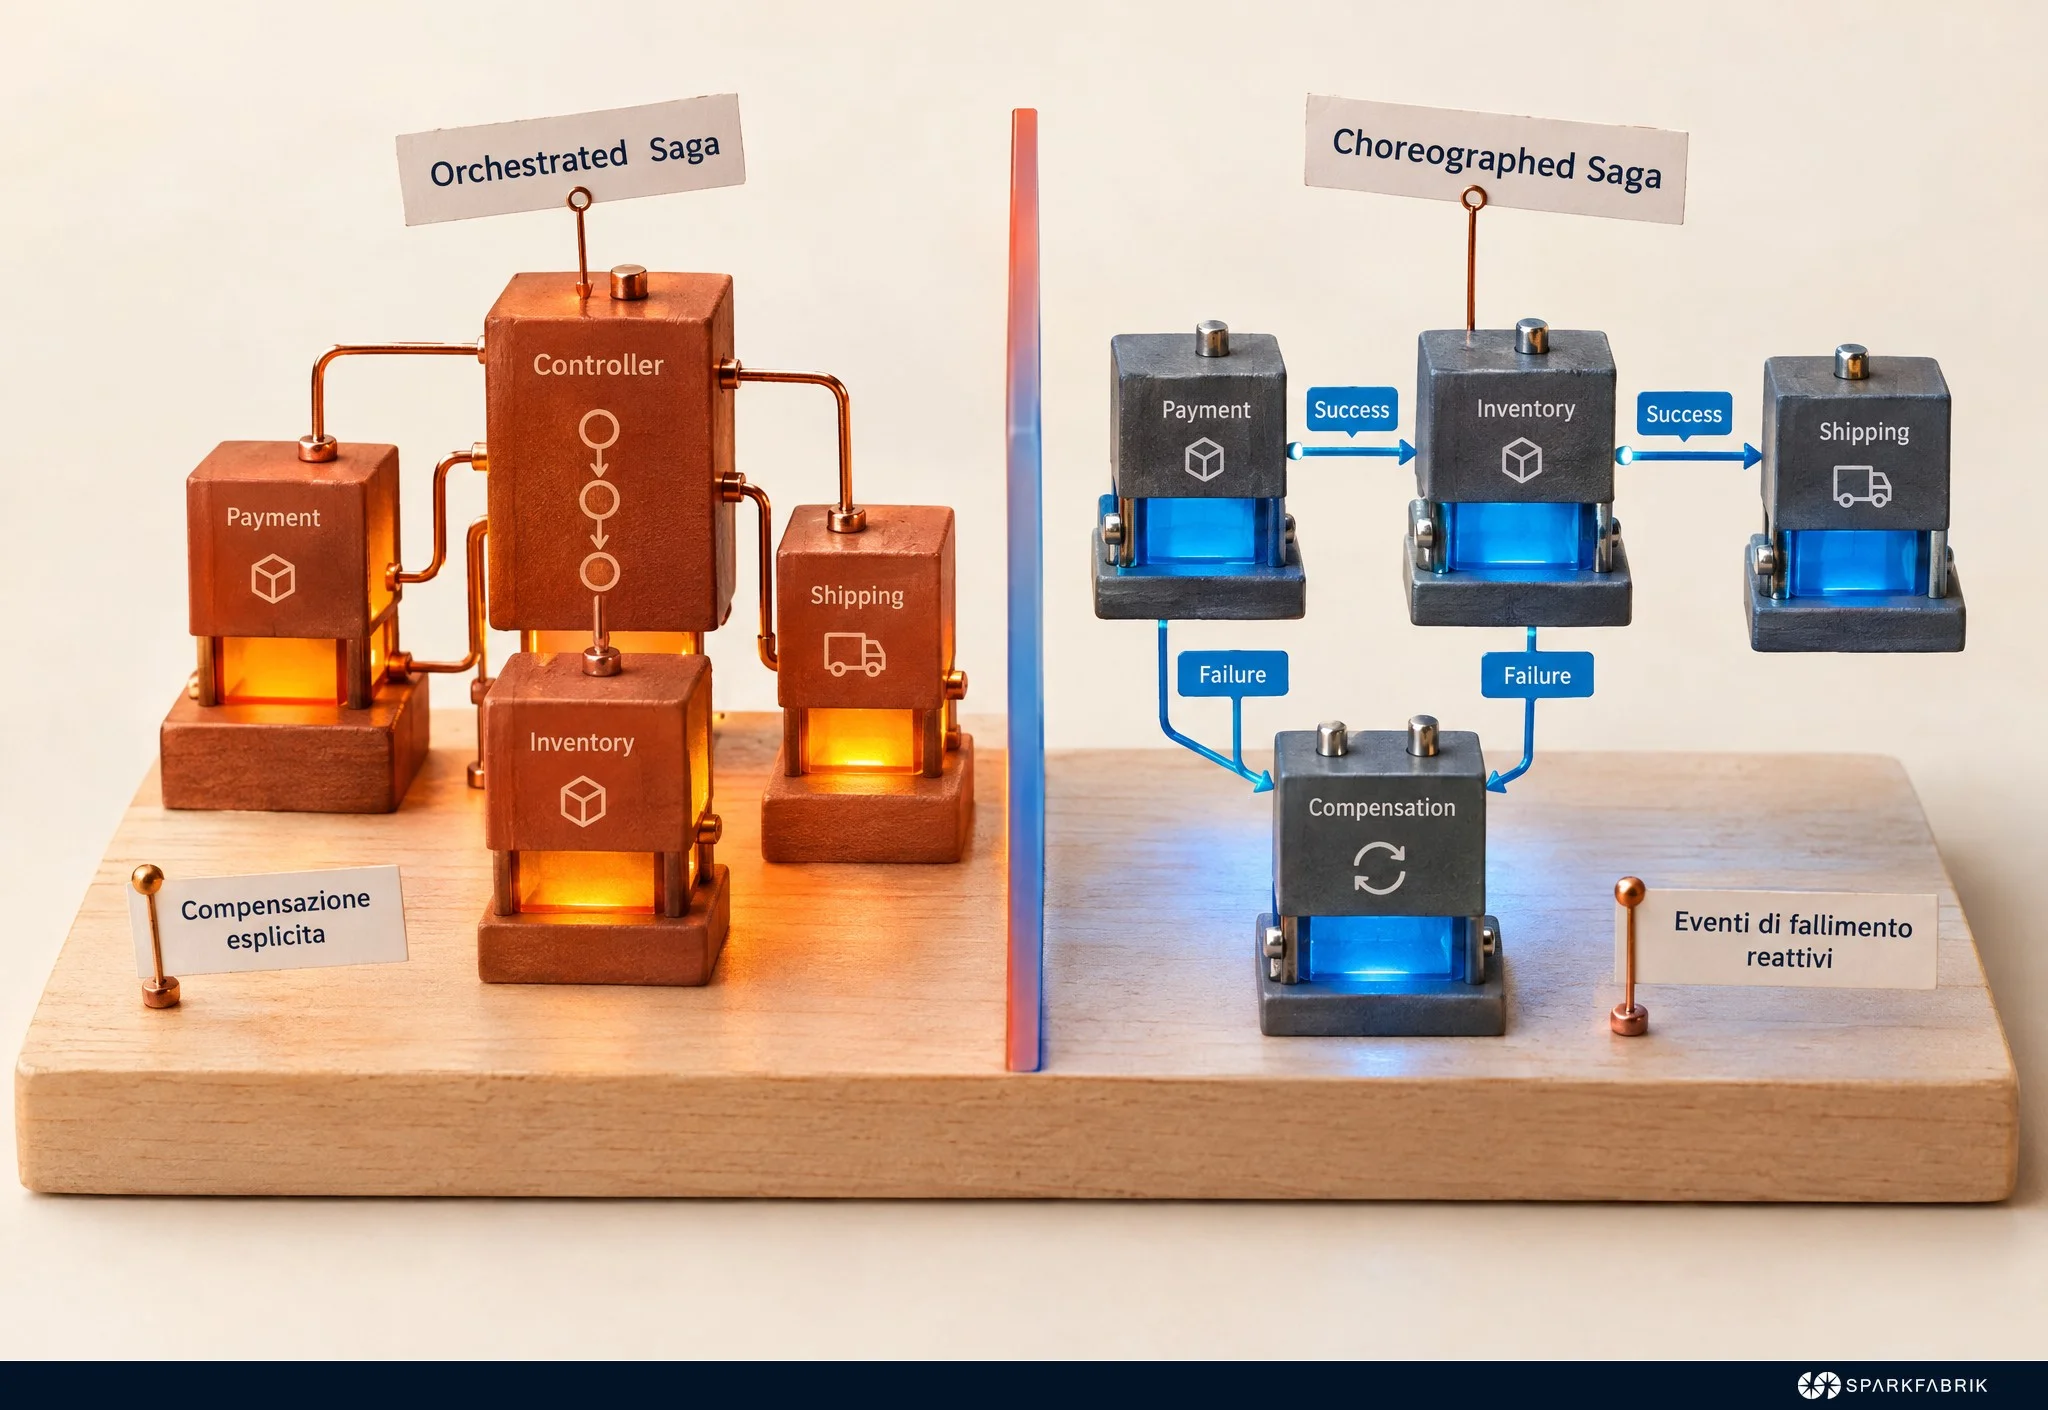
Il pattern esiste in due varianti, che ricalcano esattamente la distinzione di questo articolo.
Nella Orchestrated Saga un componente dedicato, il saga orchestrator, invia un comando a ciascun servizio, attende l’esito e, al primo fallimento, esegue le compensazioni in ordine inverso. Strumenti come Temporal, Camunda o AWS Step Functions nascono per questo: lo stato della saga è persistito in un solo posto e si può leggere a che punto è ogni singolo ordine. Il prezzo è un componente che conosce tutti i servizi e che, se cresce senza disciplina, diventa il “servizio dio” che accentra la logica di business di mezzo sistema.
Nella Choreographed Saga non c’è un coordinatore: il servizio ordini pubblica OrderCreated, il servizio pagamenti lo consuma e pubblica PaymentCompleted oppure PaymentFailed, il magazzino reagisce al primo e ordini reagisce al secondo annullando l’ordine. La compensazione non è scritta in nessun punto, emerge dalle reazioni agli eventi di fallimento. Funziona bene fino a quattro o cinque passi; oltre, il flusso diventa difficile da ricostruire e compaiono dipendenze cicliche tra servizi che si ascoltano a vicenda.
| Criterio | Orchestrated Saga | Choreographed Saga |
|---|---|---|
| Dove vive la logica del flusso | Nel saga orchestrator | Distribuita nei servizi partecipanti |
| Gestione delle compensazioni | Esplicita, in ordine inverso | Implicita, per reazione a eventi di fallimento |
| Osservabilità dello stato | Immediata, stato persistito centralmente | Richiede tracing distribuito e correlation id |
| Accoppiamento | Servizi accoppiati all’orchestratore | Servizi accoppiati al contratto degli eventi |
| Rischio principale | Orchestratore che accentra troppa logica | Dipendenze cicliche e flusso illeggibile |
| Adatta a | Flussi lunghi, con compliance e rollback complessi | Flussi corti, domini con team autonomi |
In entrambe le varianti restano due obblighi che nessun tool elimina: ogni step deve essere idempotente, perché i messaggi verranno riconsegnati, e ogni evento deve portare un identificativo di correlazione, altrimenti la compensazione non sa quale ordine annullare. La scelta ibrida descritta sopra è quella che abbiamo applicato nel progetto cloud native per un brand del luxury fashion: il flusso d’ordine, che attraversa validazione, pagamento, riserva a magazzino e spedizione, gira come saga orchestrata dentro il bounded context delle vendite, dove ogni compensazione va tracciata e auditata; la propagazione verso catalogo, CRM e logistica avviene invece tramite eventi coreografati, così un team può rilasciare o fermare il proprio servizio senza bloccare il checkout degli altri. Il criterio è replicabile: orchestrazione dove il flusso è lungo e va spiegato a chi fa audit, coreografia tra contesti dove contano autonomia dei team e tolleranza ai guasti.
I limiti dell’approccio ibrido
Come per l’orchestrazione, anche i limiti dell’approccio ibrido derivano dal fatto che l’orchestratore è fortemente legato ai microservizi.
Se il sistema di coordinamento ha un problema, l’impatto si riverbera sull’intero sistema**. Inoltre, è più laborioso fare cambiamenti di logica, modifiche, aggiunte o eliminazioni di microservizi.
Orchestration vs Choreography: quale conviene usare?
Quando si parla di architettura di sistemi, la risposta a quale approccio scegliere è sempre “dipende “. L’Orchestration presenta una serie di vantaggi e alcuni svantaggi, così come la Choreography.
Quale scegliere quindi?
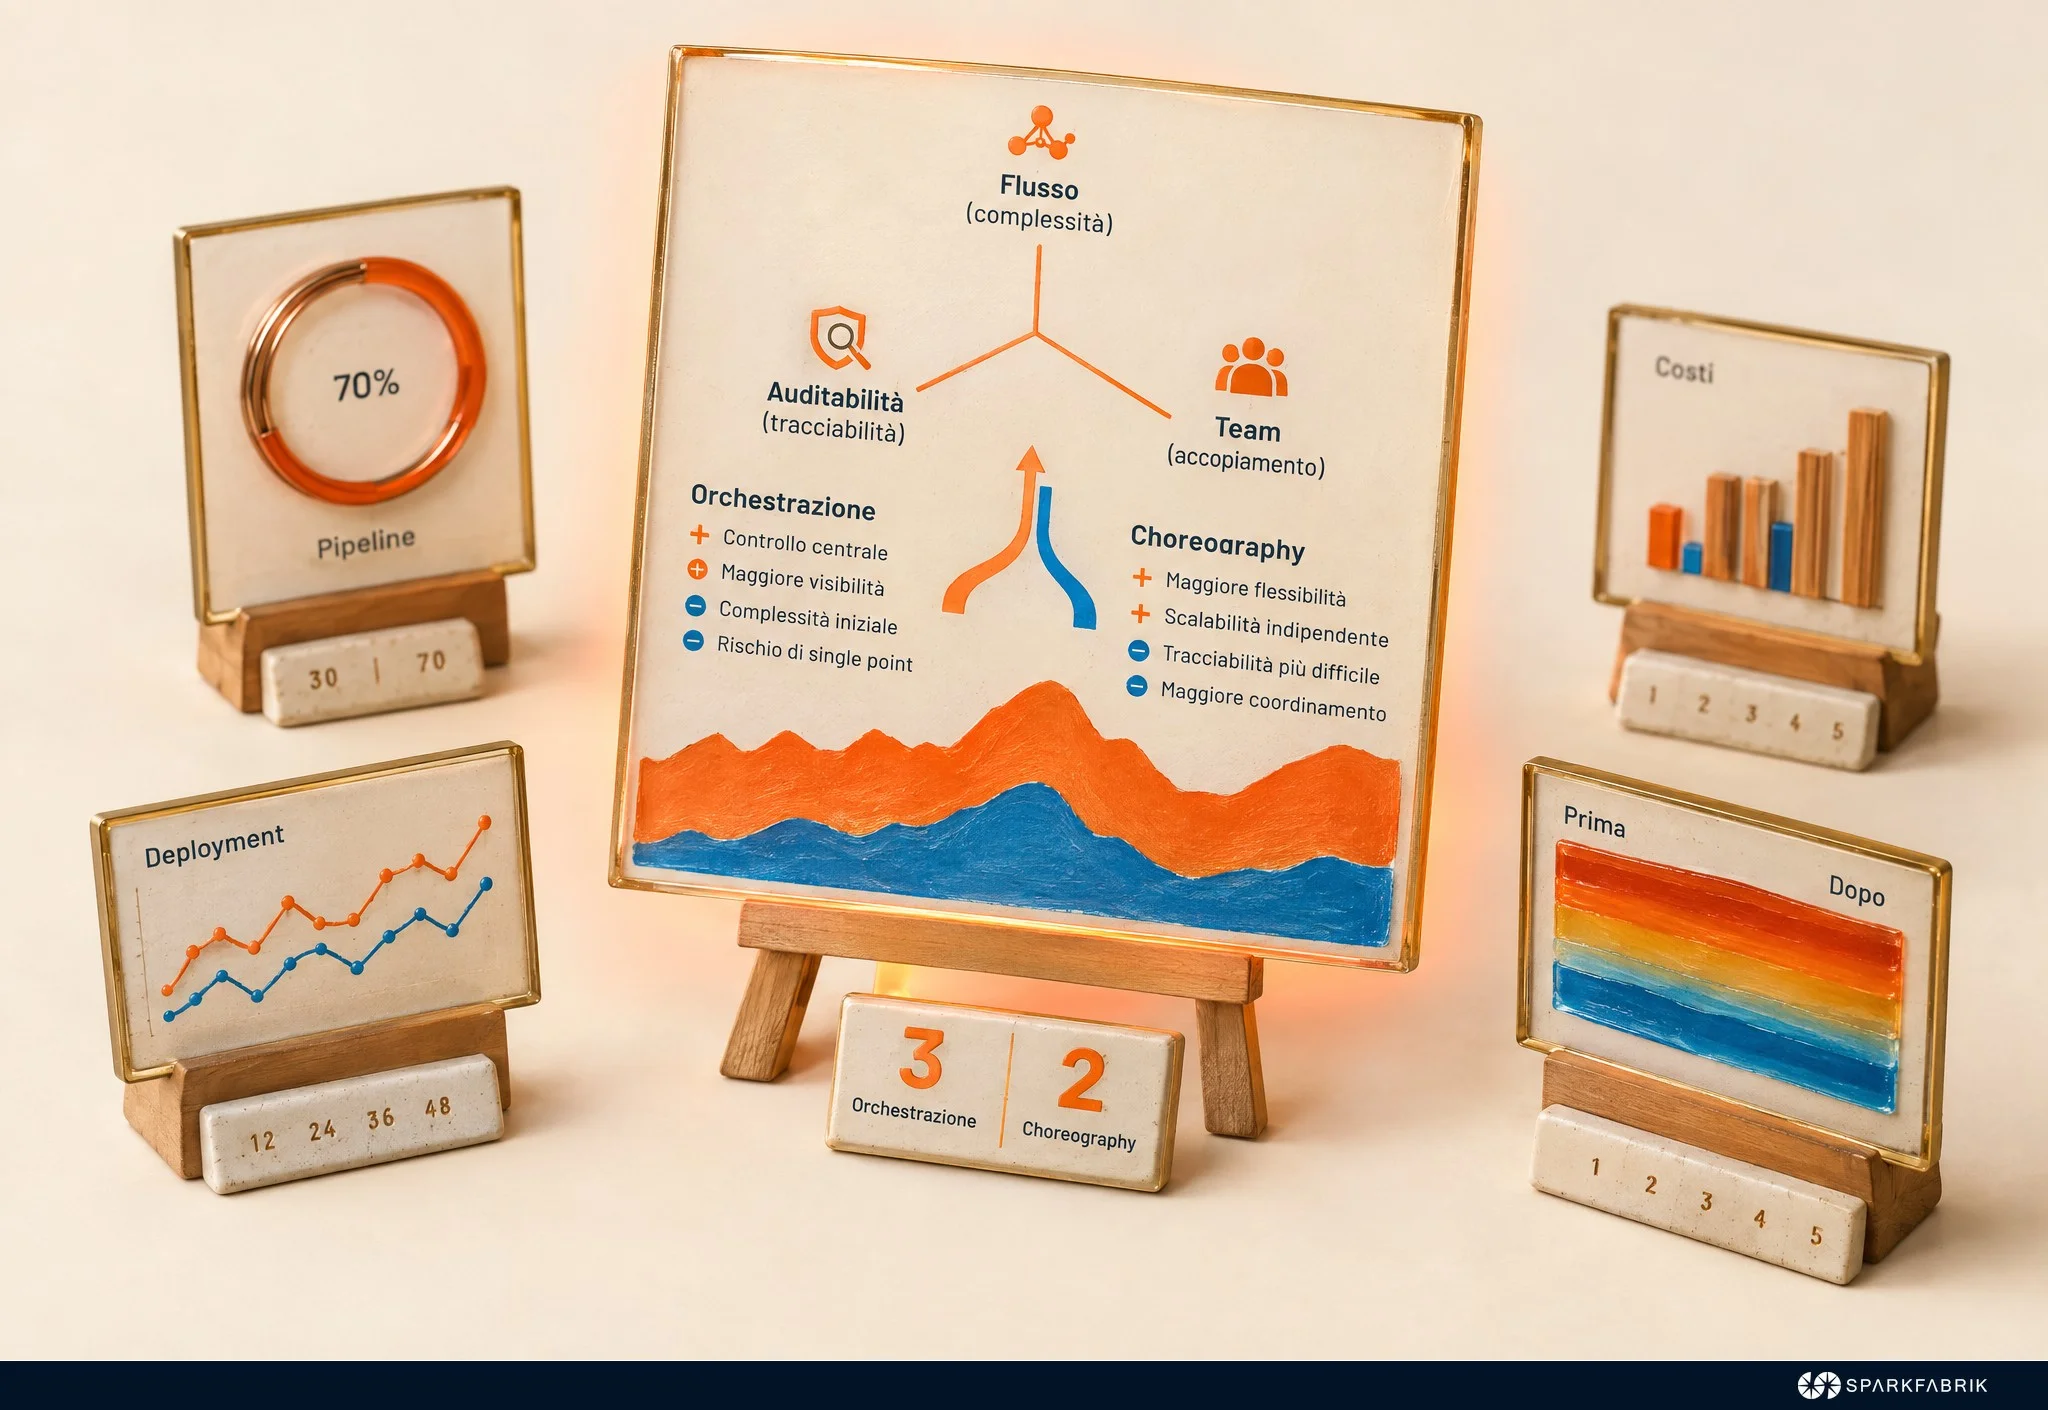
Alla luce dei benefici e delle limitazioni che abbiamo argomentato, è chiaro che la decisione deve essere presasulla base di diversi fattori. Nella decisione peseranno il tipo di progetto che si vuole realizzare, i bisogni di business, gli obiettivi da raggiungere, il team e le risorse disponibili. Tre criteri in particolare fanno pendere la bilancia da una parte o dall’altra:
- Complessità del flusso: se il processo è una sequenza lunga con stati intermedi, rollback e compensazioni (un checkout con pagamento, riserva a magazzino e spedizione), l’Orchestration tiene la logica leggibile in un unico punto; se i servizi reagiscono a pochi eventi indipendenti (aggiornamento profilo, invio notifica, reindicizzazione), la Choreography evita un controller che non avrebbe nulla da coordinare.
- Requisiti di auditabilità: quando compliance o audit impongono di ricostruire chi ha fatto cosa e in quale ordine, l’orchestratore espone lo stato del processo in un solo posto; con la Choreography la stessa ricostruzione richiede tracing distribuito e correlation id su ogni evento, un costo da mettere a budget fin dal primo sprint.
- Accoppiamento del team: un team unico che possiede l’intero flusso gestisce bene un orchestratore centrale; più team autonomi, ciascuno responsabile del proprio dominio, lavorano meglio con eventi pubblicati su un broker, perché nessuno deve attendere modifiche a un controller di proprietà altrui per rilasciare.
In linea di massima, se vogliamo favorire la scalabilità del progetto e siamo preparati a gestire una complessità elevata possiamo considerare l’approccio Choreography.
Viceversa, se la priorità è avere controllo sui flussi per stabilizzare l’applicazione e renderla misurabile e modificabile senza toccare ogni servizio, la scelta ricade sull’Orchestration o sull’approccio ibrido. Prima di decidere, un esercizio concreto che nel nostro team facciamo in fase di assessment: mappare i flussi di business su tre assi, numero di step, requisiti di audit e frequenza con cui cambiano le regole. I flussi corti che cambiano spesso vanno bene in Choreography; quelli lunghi e con obbligo di tracciabilità chiedono un orchestratore, e la mappa mostra quasi sempre che in uno stesso sistema convivono entrambi.
Se volete inquadrare questa scelta nel disegno complessivo di un’architettura a microservizi, la guida completa al Cloud Native copre i pattern di comunicazione, il ruolo dei message broker e i criteri di decomposizione dei domini. Per un confronto sul vostro caso specifico, dai primi servizi da estrarre a un monolite fino alla scelta dello strumento di orchestrazione, potete contattarci attraverso i nostri servizi Cloud Native.
La tabella riassume i criteri usati in questo articolo per decidere tra i due approcci:
| Criterio | Orchestration | Choreography |
|---|---|---|
| Accoppiamento | Ogni servizio è accoppiato al controller centrale; aggiungere un passo richiede di modificare l’orchestratore | Servizi accoppiati solo al contratto degli eventi; un nuovo consumer si iscrive al broker senza toccare chi pubblica |
| Tracciabilità | Stato del processo persistito in un punto solo; si legge a che passo è ogni singola transazione | Ricostruita a posteriori con tracing distribuito e correlation id su ogni evento, da prevedere fin dal primo sprint |
| Complessità operativa | Concentrata nel controller: un componente da progettare, versionare e proteggere dal diventare un “servizio dio” | Distribuita nei servizi e nel broker: nessun punto unico da gestire, ma il flusso complessivo non è scritto in nessun posto |
| Latenza | Chiamate sincrone in serie: il tempo di risposta è la somma dei passi, e cresce con ogni dipendenza aggiunta | Comunicazione asincrona: il publisher risponde subito, il lavoro procede in parallelo con eventual consistency |
| Gestione degli errori | Retry, timeout e compensazioni espliciti nell’orchestratore, eseguiti in ordine inverso al primo fallimento | Compensazioni implicite, per reazione a eventi di fallimento; oltre quattro o cinque passi il flusso diventa difficile da ricostruire |
| Adatta a | Flussi lunghi con rollback complessi, requisiti di audit, team unico che possiede l’intero processo | Flussi corti che cambiano spesso, più team autonomi, domini che devono tollerare l’indisponibilità di un servizio |
Note e fonti
ha completato il percorso di incubazione e nel 2025 ha raggiunto lo stato di progetto graduated: «Crossplane is now a graduated CNCF project and is available for production use today.» (fonte: https://www.cncf.io/announcements/2025/11/06/cloud-native-computing-foundation-announces-graduation-of-crossplane/) ↩︎