Spostare i contenuti di un sito con un’architettura legacy disordinata dentro una struttura Drupal moderna è una migrazione in cui le regole automatiche reggono finché la sorgente è coerente; oltre quel punto servono interpretazione e giudizio. Roberto Peruzzo, sviluppatore Drupal e PHP in SparkFabrik, ha portato questo caso sul palco di DrupalCamp Italy 20261 e di DrupalCon Rotterdam 20262, mostrando come affrontarlo con l’AI in modo strutturato, senza consegnare l’intero lavoro a un singolo prompt.
Roberto contribuisce a Drupal circa dal 2014 e lavora su diversi moduli come contributor e maintainer3. La sua è la prospettiva di chi scrive codice Drupal ogni giorno in SparkFabrik. Nel suo talk non presenta uno strumento chiavi in mano, bensì offre spunti di riflessione su come affrontare con l’AI problemi complessi come la migrazione.
Gli spunti ruotano attorno a un’impostazione che un ingegnere del software riconosce subito: i principi SOLID come criterio di progettazione, la scomposizione del lavoro in skill atomiche indipendenti e l’orchestrazione affidata ad agenti dedicati. Ognuno di questi elementi risponde a un difetto preciso dell’approccio più intuitivo, quello che chiede a un modello di leggere il vecchio sito e restituire il nuovo in una sola passata.
Tanta struttura si giustifica guardando a dove si rompe l’automazione classica. Succede quando i dati della sorgente smettono di essere regolari e cominciano a chiedere interpretazione, oppure quando emergono contenuti che l’analisi iniziale non aveva considerato. In quel punto la Migrate API, strumento solido per tutto ciò che si descrive con una regola, inizia a richiedere eccezioni che crescono con ogni nuovo caso scoperto nell’archivio.
Perché una migrazione di contenuti Drupal è un problema ostico?
La difficoltà sta nell’interpretare i dati, molto più che nel trasferirli. Finché la sorgente è coerente, la Migrate API di Drupal offre un modello chiaro: un plugin di source legge le righe dal sistema di partenza, una catena di plugin di process trasforma i valori campo per campo, un plugin di destination scrive entità, revisioni e traduzioni. Le tabelle di mappatura registrano la corrispondenza tra ID sorgente e ID destinazione, e su quel tracciamento si appoggiano rollback, aggiornamenti incrementali e riesecuzioni controllate.
In questo modello ogni trasformazione è una regola esplicita e ripetibile, dichiarata nella definizione della migrazione. Lo stesso input produce sempre lo stesso output, e una modifica alla regola si verifica rieseguendo la migrazione su un sottoinsieme di righe. L’intero ciclo di vita di una migrazione, dall’analisi della sorgente alla verifica dei contenuti importati, poggia su questa prevedibilità.
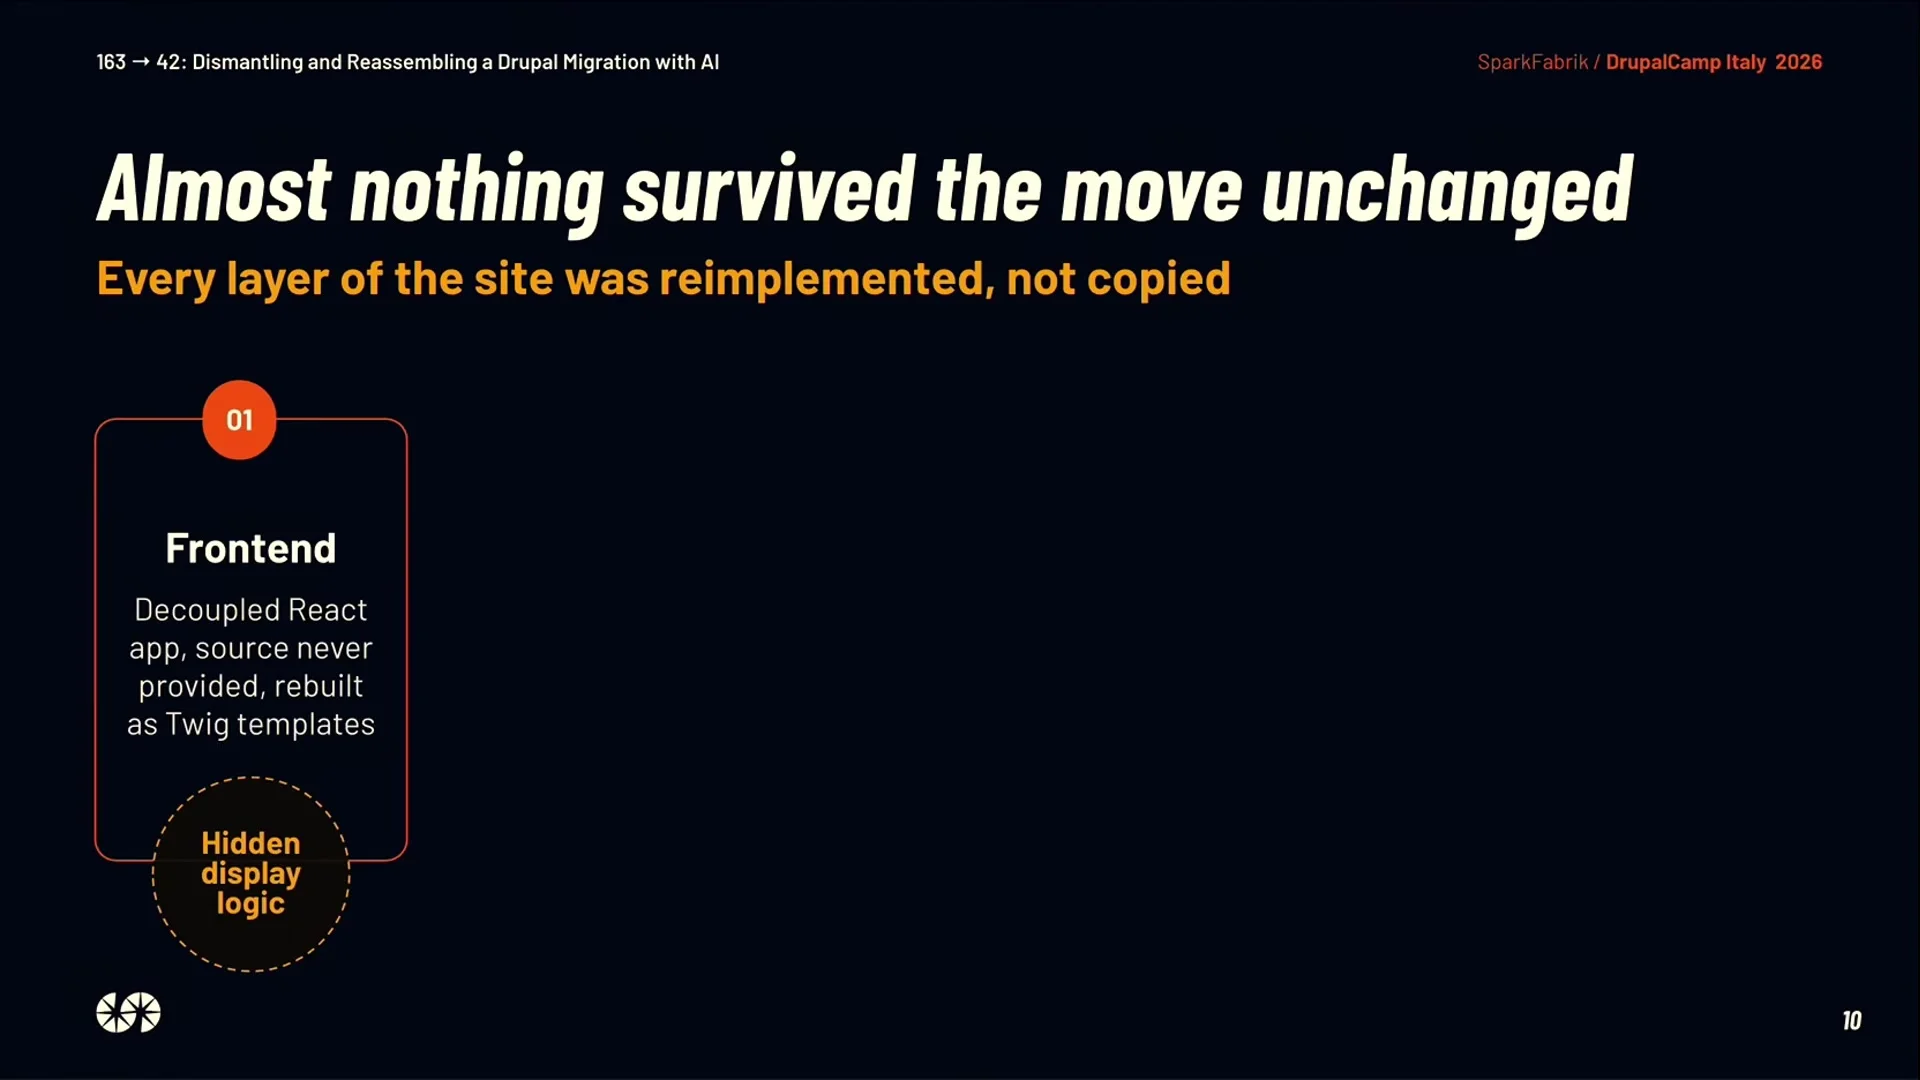
Una sorgente legacy tipica rompe la prevedibilità in molti punti. Il primo è il campo body, che spesso contiene markup e layout incorporati, come griglie, stili inline e shortcode mescolano contenuto e presentazione. Poi c’è la struttura, un content type nato per le news finisce, negli anni, per ospitare eventi, comunicati e pagine istituzionali, mentre le tassonomie degenerano in liste libere di tag scritti in modi diversi. Date, autori e riferimenti ad altri contenuti, infine, restano spesso sepolti nel testo invece che in campi dedicati. In un progetto reale di migrazione quasi nulla passa invariato: cambiano l’architettura dei contenuti, il livello dei media, la gestione del multilingua, gli URL e spesso il frontend.
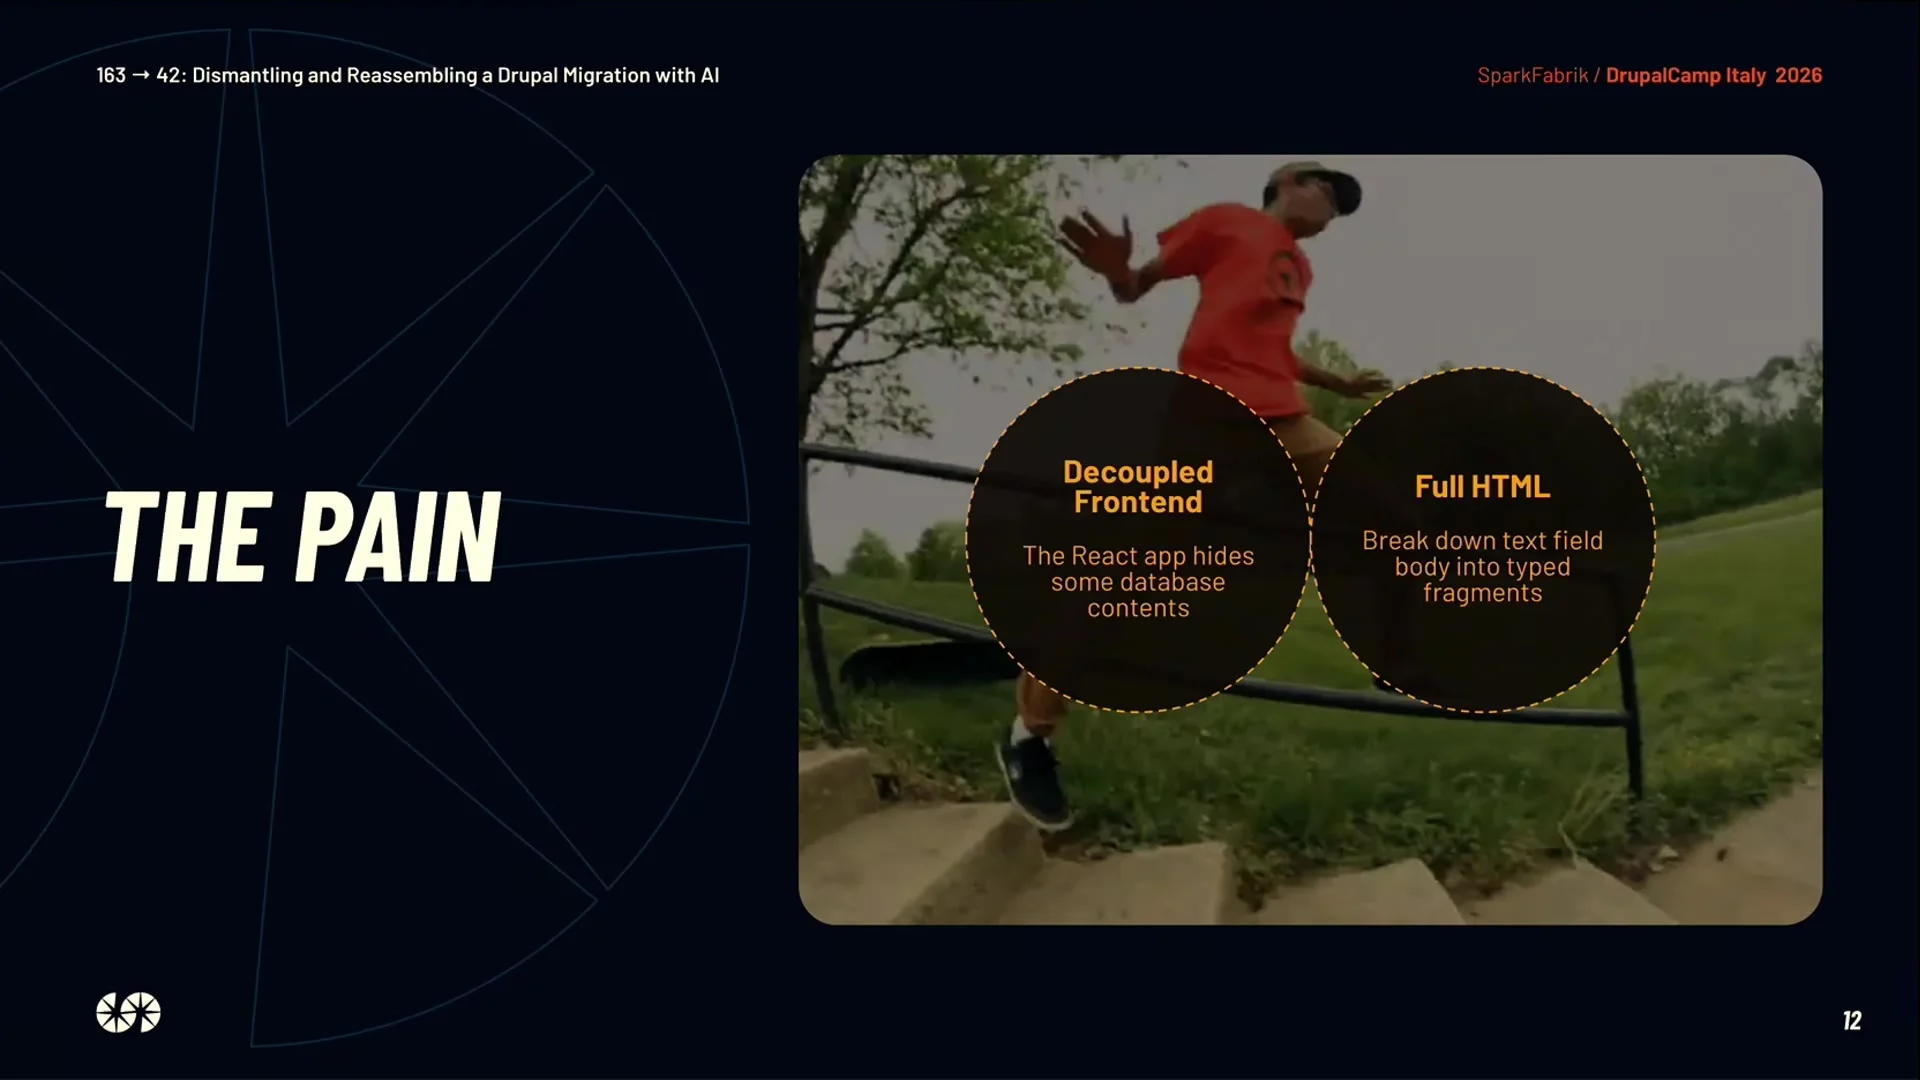
Un caso particolarmente delicato riguarda i siti con frontend disaccoppiato, dove parte del significato vive in frammenti HTML salvati nei campi e interpretati dal client, quindi non basta leggere il database per capire che cosa rappresentano. Il nuovo content model deve ricondurre quei frammenti a campi e componenti, ma nessuna regola generale ci riesce senza conoscere le convenzioni, spesso non documentate, con cui sono stati scritti.
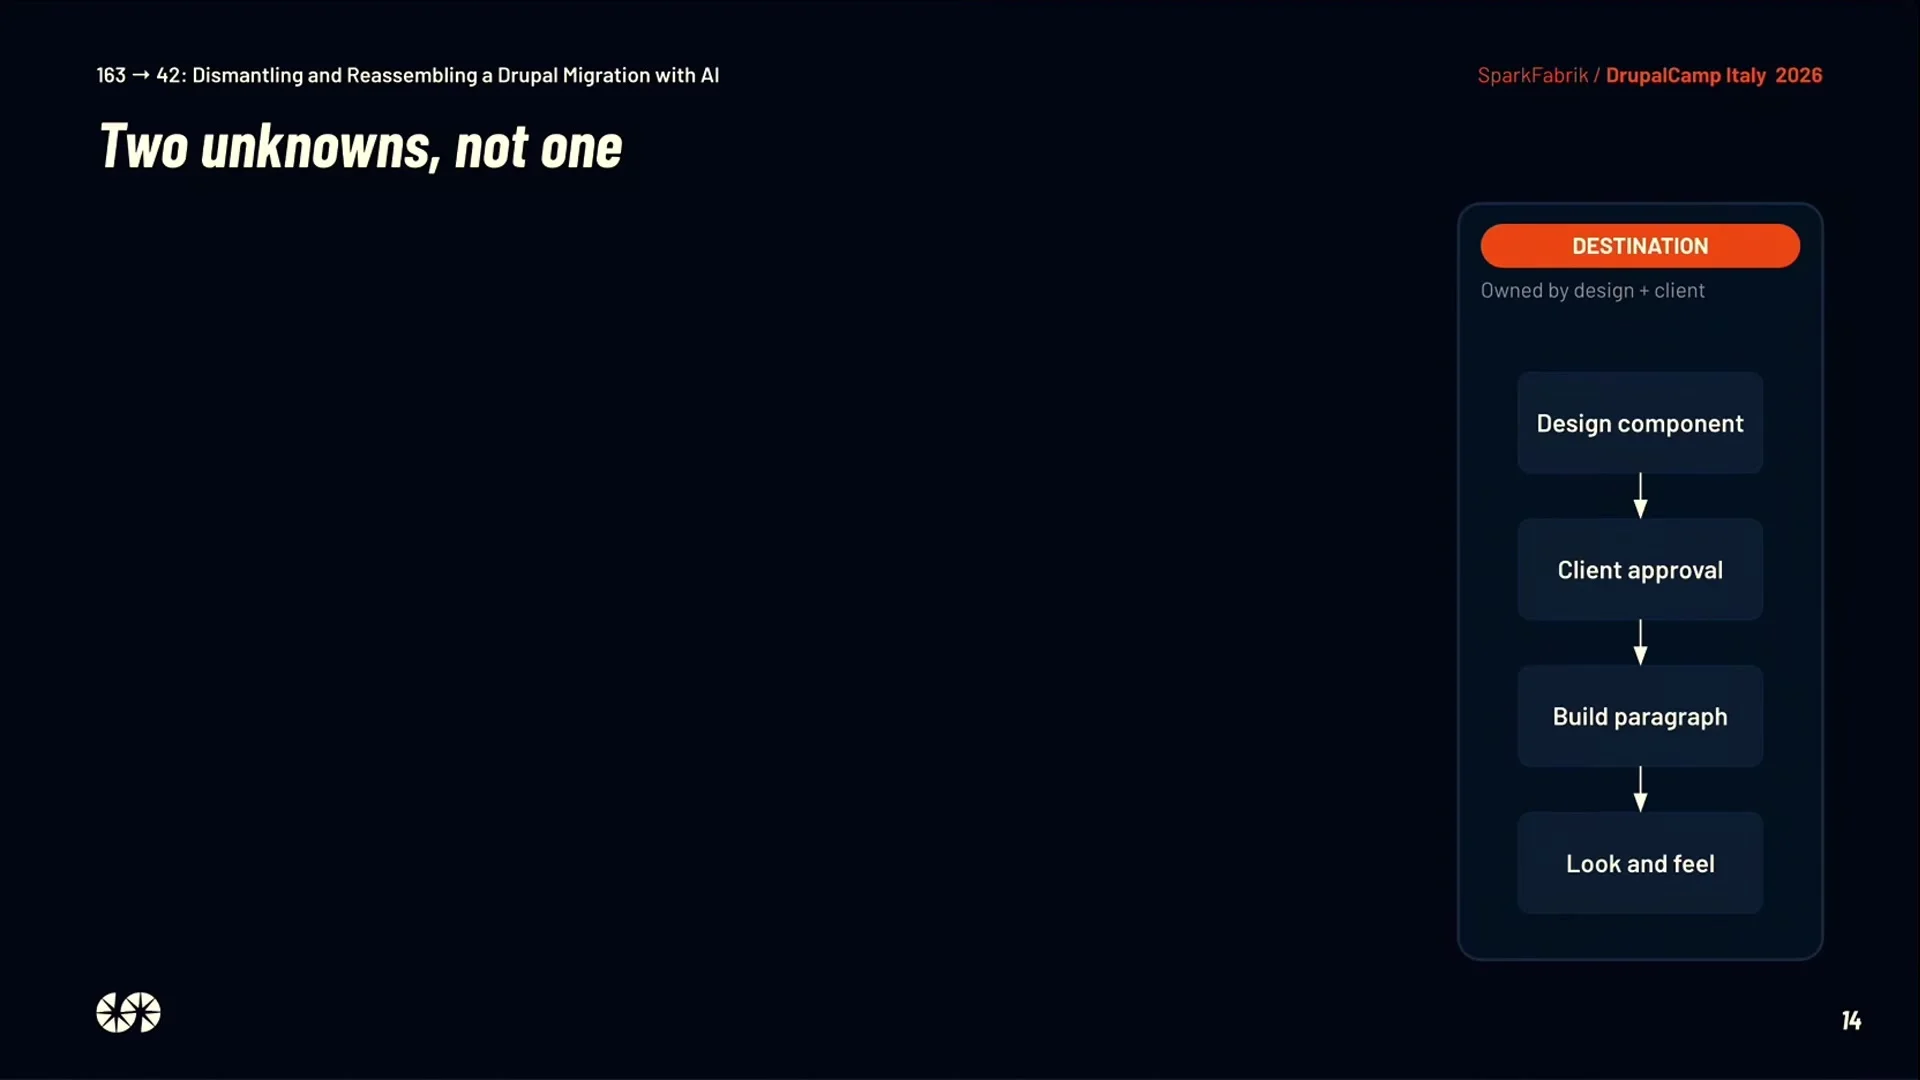
Anche la mappatura tra componenti ha più forme. Un componente della sorgente può corrispondere a uno della destinazione (1:1), più componenti possono confluire in uno solo (N:1), uno può dividersi in più componenti (1:N), alcuni spariscono senza eredi (1:0) e altri nascono senza un antecedente (0:1). Ogni forma richiede logiche di process diverse. Ogni eccezione scoperta durante il lavoro aggiunge plugin custom, condizioni annidate e casi speciali, fino a rendere le regole ingestibili. Sono criticità di mapping che ogni migrazione verso Drupal deve pianificare prima di scrivere il codice.
Qui l’AI diventa una tentazione. Un modello linguistico sa leggere contenuto non strutturato e proporne una struttura, ad esempio riconosce che un paragrafo contiene una data, che una tabella HTML descrive i membri di un team, che un link punta a un contenuto da convertire in riferimento a un’entità. La destinazione è un content model esplicito, con tipi, campi e relazioni dichiarati. La mossa più ovvia è consegnare sorgente e content model a un singolo prompt e chiedergli di produrre il risultato.
Il limite del prompt unico: instabilità e costi
Nel talk, Roberto sostiene senza mezzi termini che un approccio monolitico basato su un singolo prompt AI fallisce rapidamente, per instabilità e per costi elevati. Entrambi i sintomi hanno meccanismi precisi, riconoscibili da chiunque abbia lavorato con modelli linguistici su volumi reali.
Il primo riguarda la finestra di contesto. Un prompt unico deve contenere insieme le istruzioni per ogni trasformazione, lo schema di destinazione, gli esempi che chiariscono i casi ambigui e il contenuto del nodo. Ogni regola aggiunta per un’eccezione occupa spazio e compete con le altre per l’attenzione del modello: le istruzioni sepolte a metà del prompt finiscono per pesare meno, e il comportamento su casi che prima funzionavano cambia senza che nessuno le abbia toccate.
Il secondo è il non determinismo. A parità di input, l’output di un LLM può variare tra un’esecuzione e l’altra, anche con parametri di campionamento conservativi. Su un singolo nodo è un fastidio; su un intero archivio significa che lo stesso pattern di sorgente viene trasformato in modi diversi, e l’incoerenza emerge solo a valle, quando un editor nota che due articoli strutturalmente identici hanno campi popolati in modo diverso. Si aggiungono le allucinazioni, come valori plausibili ma assenti nella sorgente, campi inventati e riferimenti a entità inesistenti, tutti formalmente validi e quindi difficili da intercettare senza un controllo esplicito.
Il terzo meccanismo combina costo in token e opacità dell’errore. Le istruzioni si ripagano a ogni chiamata, per cui un prompt che cresce per gestire le eccezioni rende più cara ogni trasformazione, anche quella dei nodi più semplici. Se un solo aspetto dell’output è sbagliato si riesegue l’intera chiamata, senza poter isolare quale istruzione ha prodotto la deviazione. Correggere il prompt per un caso può rompere un caso già funzionante, il classico effetto regressione di un sistema senza test, con l’aggravante che il comportamento non si legge in nessun sorgente.
Un fattore esterno amplifica tutti e tre i problemi: i requisiti cambiano mentre la migrazione è in corso. Capita spesso che la razionalizzazione dei componenti della destinazione, nata per ridurre un insieme sovrabbondante di bundle a un catalogo gestibile, si riapra quando emergono casi che l’analisi iniziale non aveva visto, e che il catalogo torni a crescere. Il perimetro si allarga, il content model si aggiorna e ogni aggiornamento invalida una parte del lavoro già fatto.
Un approccio che concentra l’analisi in una sola fase e la trasformazione in una sola chiamata presuppone requisiti stabili. Quando il content model cambia, il prompt va riscritto e l’archivio rielaborato da capo, in un ciclo che riparte sempre dallo stesso punto senza convergere.
Messi in fila, i sintomi descrivono un componente con troppe responsabilità concentrate in un punto, modifiche che ne rompono altre e nessuna possibilità di verifica in isolamento. Un ingegnere li conosce sotto il nome di god class, e conosce anche i principi nati per smontarla.
Come si leggono i principi SOLID in un sistema di skill e agenti
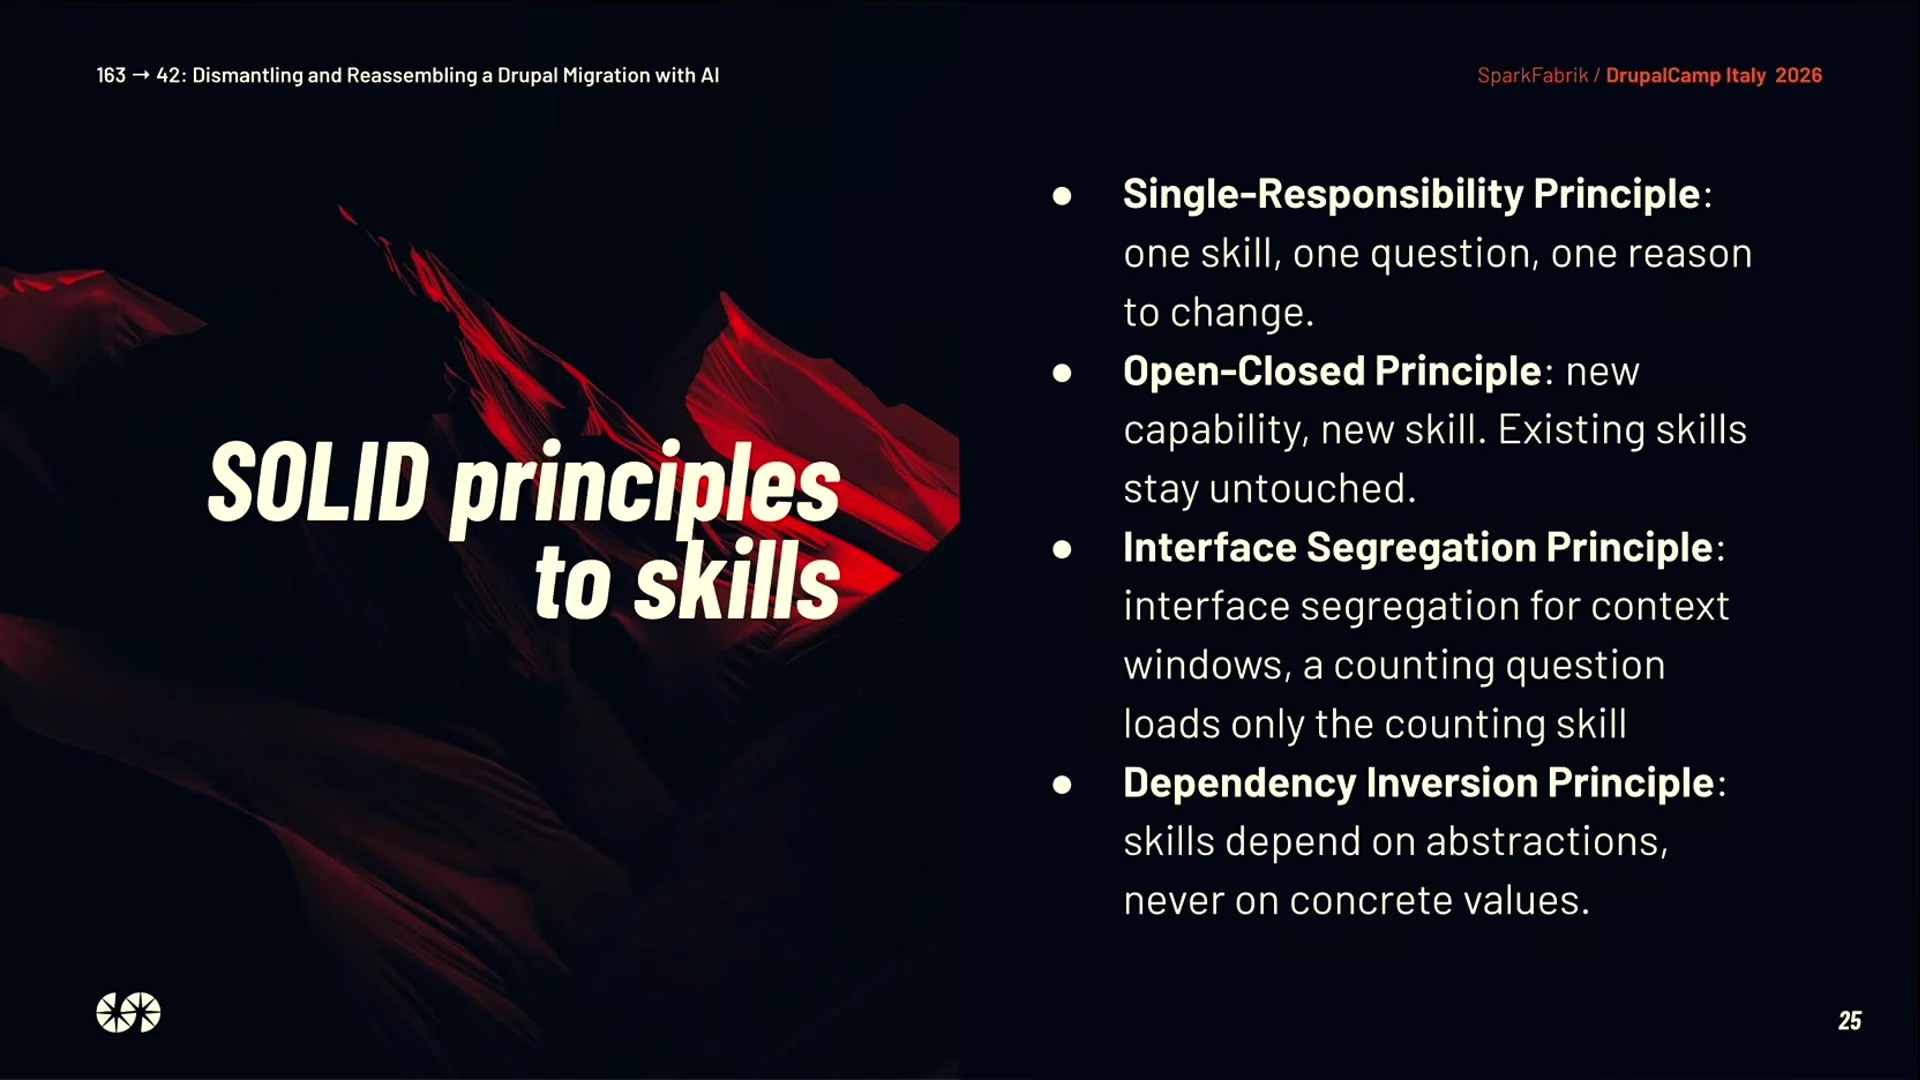
Un prompt monolitico che migra un intero archivio somiglia a una classe che valida, trasforma, persiste e logga tutto da sola: funziona finché i casi sono pochi, poi ogni modifica diventa un rischio. Da qui parte la proposta di Peruzzo, un framework ingegnerizzato per la migrazione basato su principi SOLID, frammentazione atomica in skill indipendenti e orchestrazione tramite agenti dedicati.
Quando le unità di progettazione sono skill e agenti AI, i principi SOLID si leggono così:
- Single responsibility: una skill esegue una sola trasformazione, per esempio normalizzare il formato di una data o estrarre il riferimento a un altro contenuto da un campo testo, e cambia per una sola ragione.
- Open/closed: un nuovo caso emerso nella sorgente si gestisce aggiungendo una skill, senza riscrivere quelle esistenti né rimettere in discussione le trasformazioni già validate.
- Liskov substitution: è il principio che si applica meno, e Roberto lo dichiara sul palco. Le skill non sono intercambiabili tra loro, perché ognuna risponde a una domanda diversa. La sostituzione avviene dentro la singola skill, che interroga una sorgente Drupal 7 o Drupal 8+ rispettando lo stesso contratto. L’agente che la invoca non sa quale variante è stata eseguita.
- Interface segregation: ogni agente riceve solo le skill e il contesto che gli servono; un agente che classifica i contenuti non ha bisogno delle istruzioni per riscrivere il markup, e il contesto per chiamata si riduce.
- Dependency inversion: l’orchestrazione dipende dal contratto della skill e non dal modello specifico, che resta sostituibile quando ne esce uno più adatto o più economico.
La stessa intuizione circola anche fuori dal talk. Alla DrupalCon Europe 2026 Len Swaneveld ha descritto codice e architettura puliti come una forma di context engineering e come salvaguardia contro gli LLM che vanno fuori strada, perché un modello ragiona solo su ciò che vede e indovina il resto4. Un sistema scomposto secondo SOLID riduce ciò che il modello deve indovinare, dato che ogni chiamata vede un compito circoscritto e un contratto esplicito.
SOLID ha anche un limite che conviene dichiarare. Separare le responsabilità non rende deterministica una singola skill basata su LLM: la skill che estrae una data da testo libero può ancora sbagliare, e in modo non riproducibile. Cambia però il perimetro dell’errore, che si restringe a una trasformazione e a un contratto e diventa quindi verificabile con un test, ripetibile su un campione e correggibile senza toccare il resto. Resta da definire l’unità concreta a cui applicare questi criteri, e quanto piccola debba essere per restare utile.
Skill atomiche: progettare l’unità minima della migrazione
Una skill atomica è la più piccola unità di competenza che abbia senso eseguire da sola. Compie una trasformazione, dichiara cosa riceve e cosa restituisce, e rende localizzabile l’errore che nel prompt unico resta opaco. Cinque proprietà la distinguono da un frammento di prompt. Ha input e output dichiarati, con uno schema che l’orchestratore valida prima e dopo l’esecuzione, ed esegue una sola trasformazione. È indipendente dalle altre skill, perché non presuppone un ordine di esecuzione o lo stato lasciato da un’altra. È testabile in isolamento su campioni reali della sorgente, scelti per coprire i pattern noti e i casi limite. Infine si riesegue in modo mirato: quando fallisce si rilancia solo lei, sugli elementi coinvolti, senza ripagare il costo del resto.
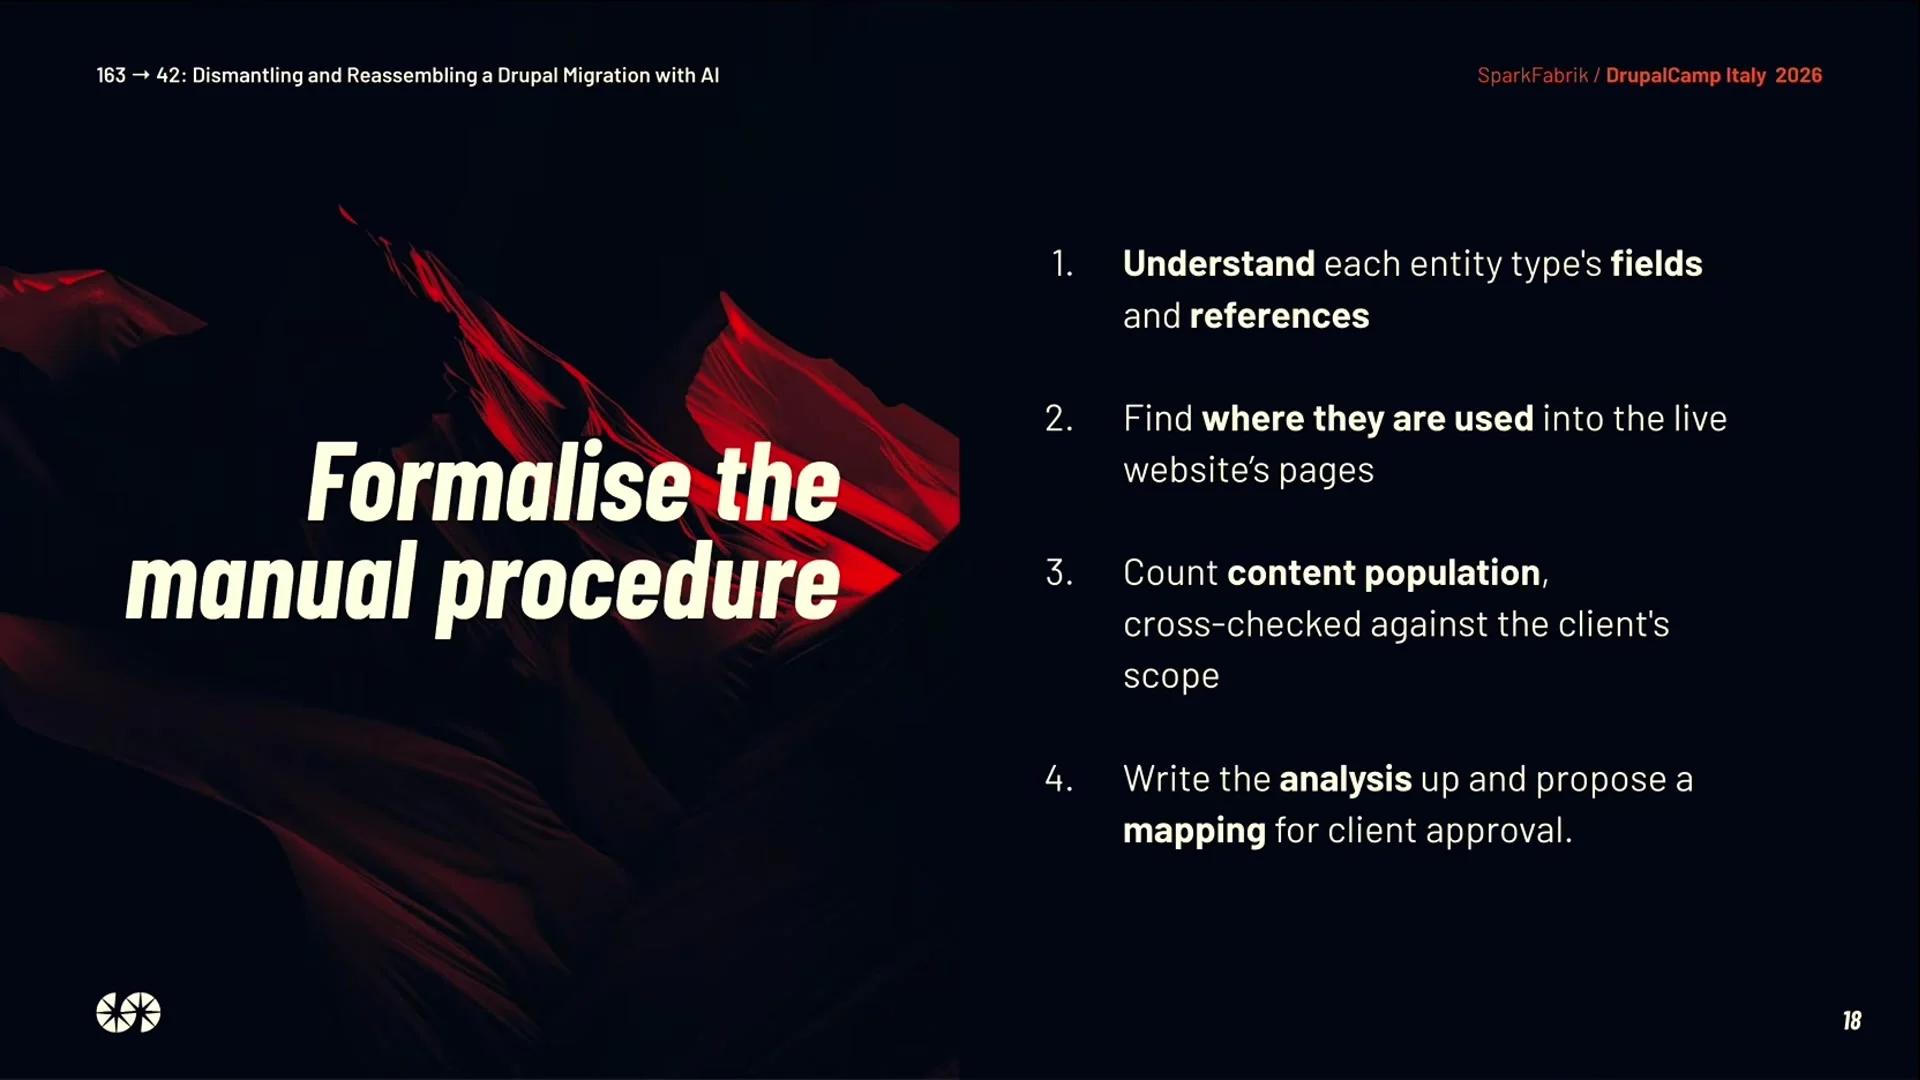
Individuare le skill giuste richiede un passaggio che precede qualunque automazione, cioè formalizzare la procedura manuale. Descrivere i passi con cui una persona esperta esamina un contenuto della sorgente, lo classifica, ne decide la destinazione e verifica il risultato produce l’inventario delle trasformazioni che il progetto richiede davvero. Ogni passo che si lascia descrivere come regola diventa codice; ogni passo che richiede giudizio su testo libero diventa candidato a una skill basata su LLM.
Da qui discende una scelta progettuale che separa due momenti. Nell’analisi della sorgente lavora l’AI: l’agente sceglie quale skill invocare e interpreta i risultati, mentre ogni skill esegue query SQL che, a parità di database, restituiscono sempre lo stesso dato. La migrazione dei contenuti resta invece codice deterministico, nella tradizione dei process plugin della Migrate API, che sono già per costruzione funzioni con input, output e comportamento ripetibile.
Anche i frammenti HTML seguono questa regola. Il codice li scompone attraversando il DOM e assegna a ogni frammento un UUID deterministico, così una riesecuzione non duplica i contenuti. La sostituibilità di Liskov (uno dei principi SOLID) compare in un punto più circoscritto, dentro le skill di analisi. La stessa skill risponde con lo stesso contratto su una sorgente Drupal 7 o Drupal 8+ (ed ora anche Wordpress), senza che il resto del sistema se ne accorga.
La destinazione conta quanto la sorgente. Come abbiamo argomentato analizzando ciò che in Drupal sembrava eccessivo e oggi serve agli agenti AI, tre scelte architetturali che nel 2015 apparivano sovradimensionate permettono oggi a un agente AI di operare sul sito in modo governato: structured content, API-first e configuration management rigoroso.
Tutte e tre rendono contenuti e configurazione leggibili in modo esplicito. Nella migrazione, l’output di ogni skill si confronta con un content model dichiarato nella configurazione Drupal, non con un’aspettativa implicita nel prompt. Tipi di contenuto, campi, cardinalità e vincoli sono esportati come file versionati. Questa garanzia discende dal modello a contenuti strutturati di Drupal e trasforma la validazione un confronto con uno schema anziché un giudizio soggettivo.
Sul piano qualitativo, le due impostazioni si confrontano così.
| Dimensione | Prompt monolitico | Skill atomiche orchestrate |
|---|---|---|
| Contesto per chiamata | Contiene regole, schema, esempi e contenuto insieme | Contiene solo contratto e contesto della singola trasformazione |
| Riproducibilità del risultato | Varia tra esecuzioni e tra nodi con lo stesso pattern | Garantita per le skill deterministiche, circoscritta e testabile per quelle basate su LLM |
| Isolamento dell’errore | Non si identifica l’istruzione che ha prodotto la deviazione | L’errore è legato a una skill e al suo contratto |
| Costo della riesecuzione | Si rilancia l’intera chiamata su ogni nodo coinvolto | Si rilancia solo la skill fallita sugli elementi interessati |
| Evoluzione con un nuovo caso | Si modifica il prompt, con rischio di regressione | Si aggiunge una skill, quelle validate restano invariate |
Una skill ben progettata sa fare una cosa sola e la fa in modo verificabile. Serve però un componente che decida quale skill chiamare, in che ordine e cosa fare quando una fallisce, e quel ruolo spetta agli agenti dedicati.
Agenti dedicati e orchestrazione: architettura e trade-off
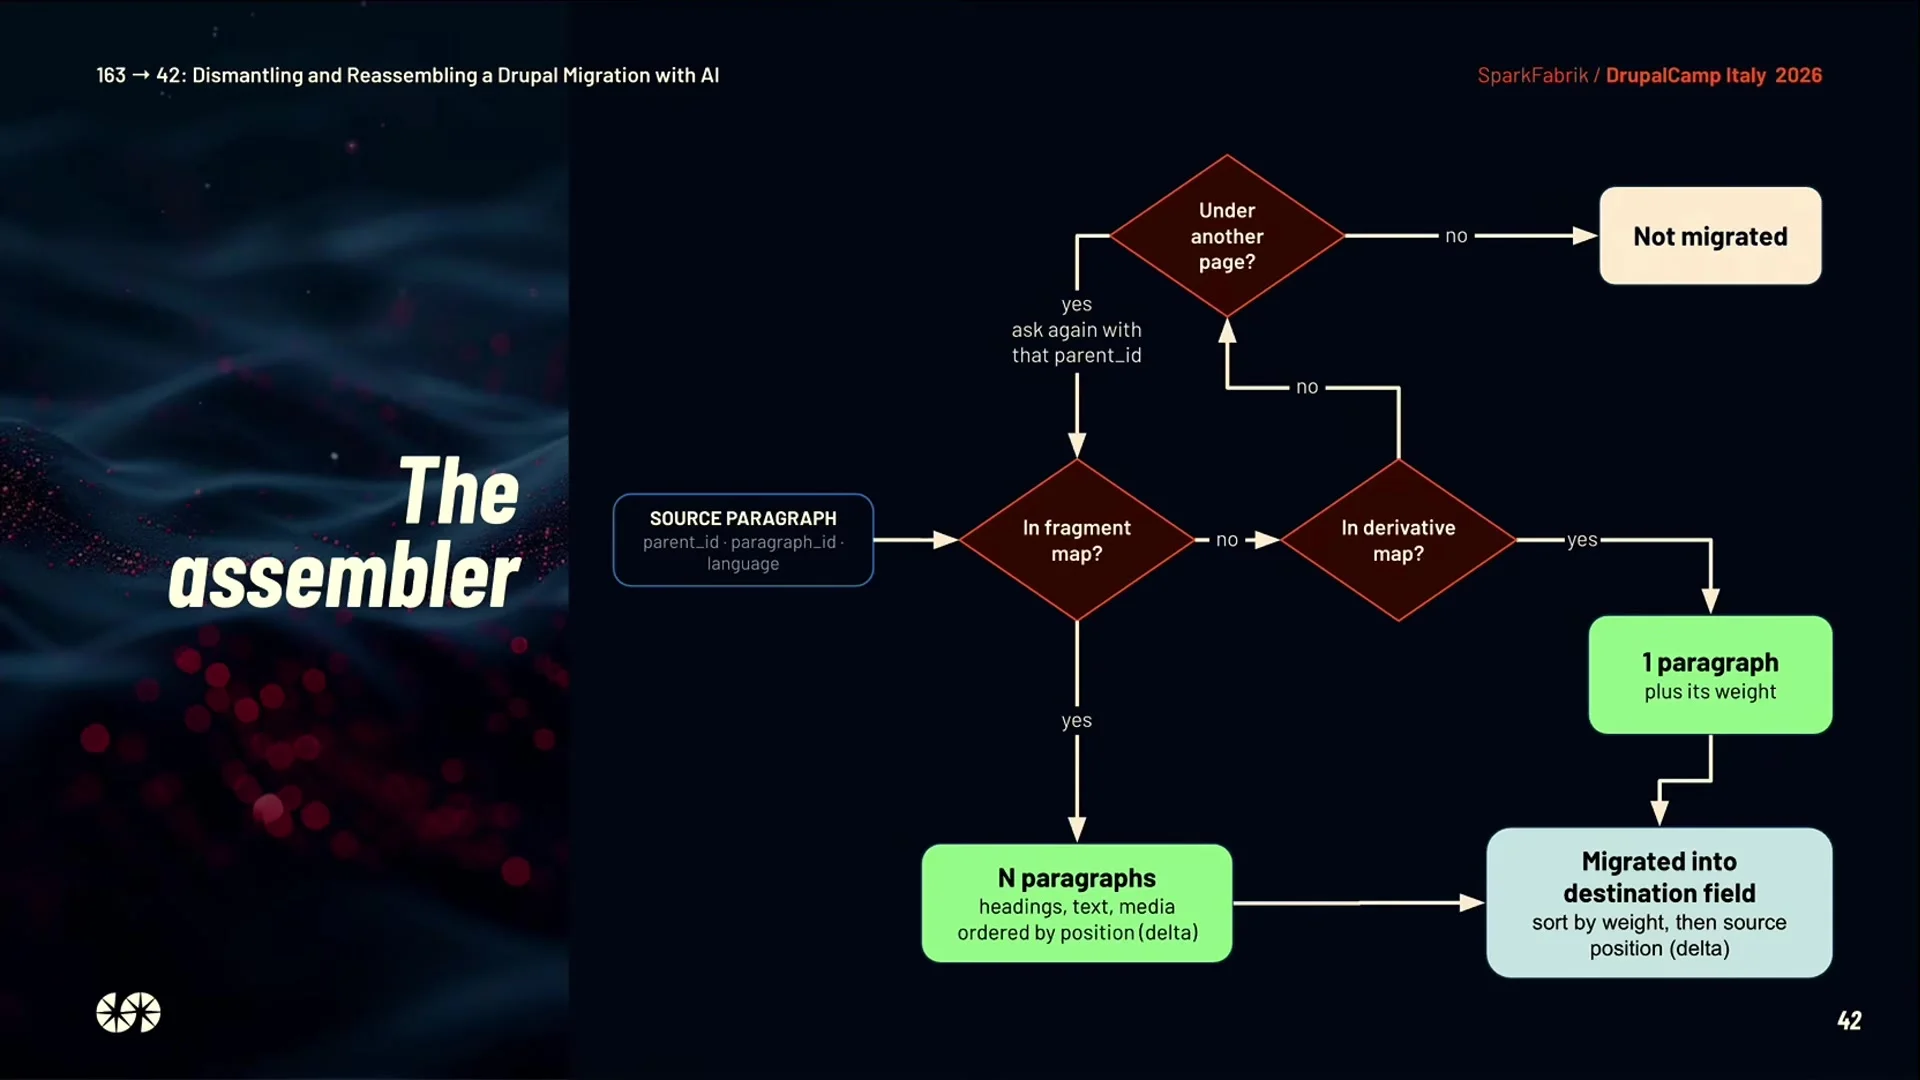
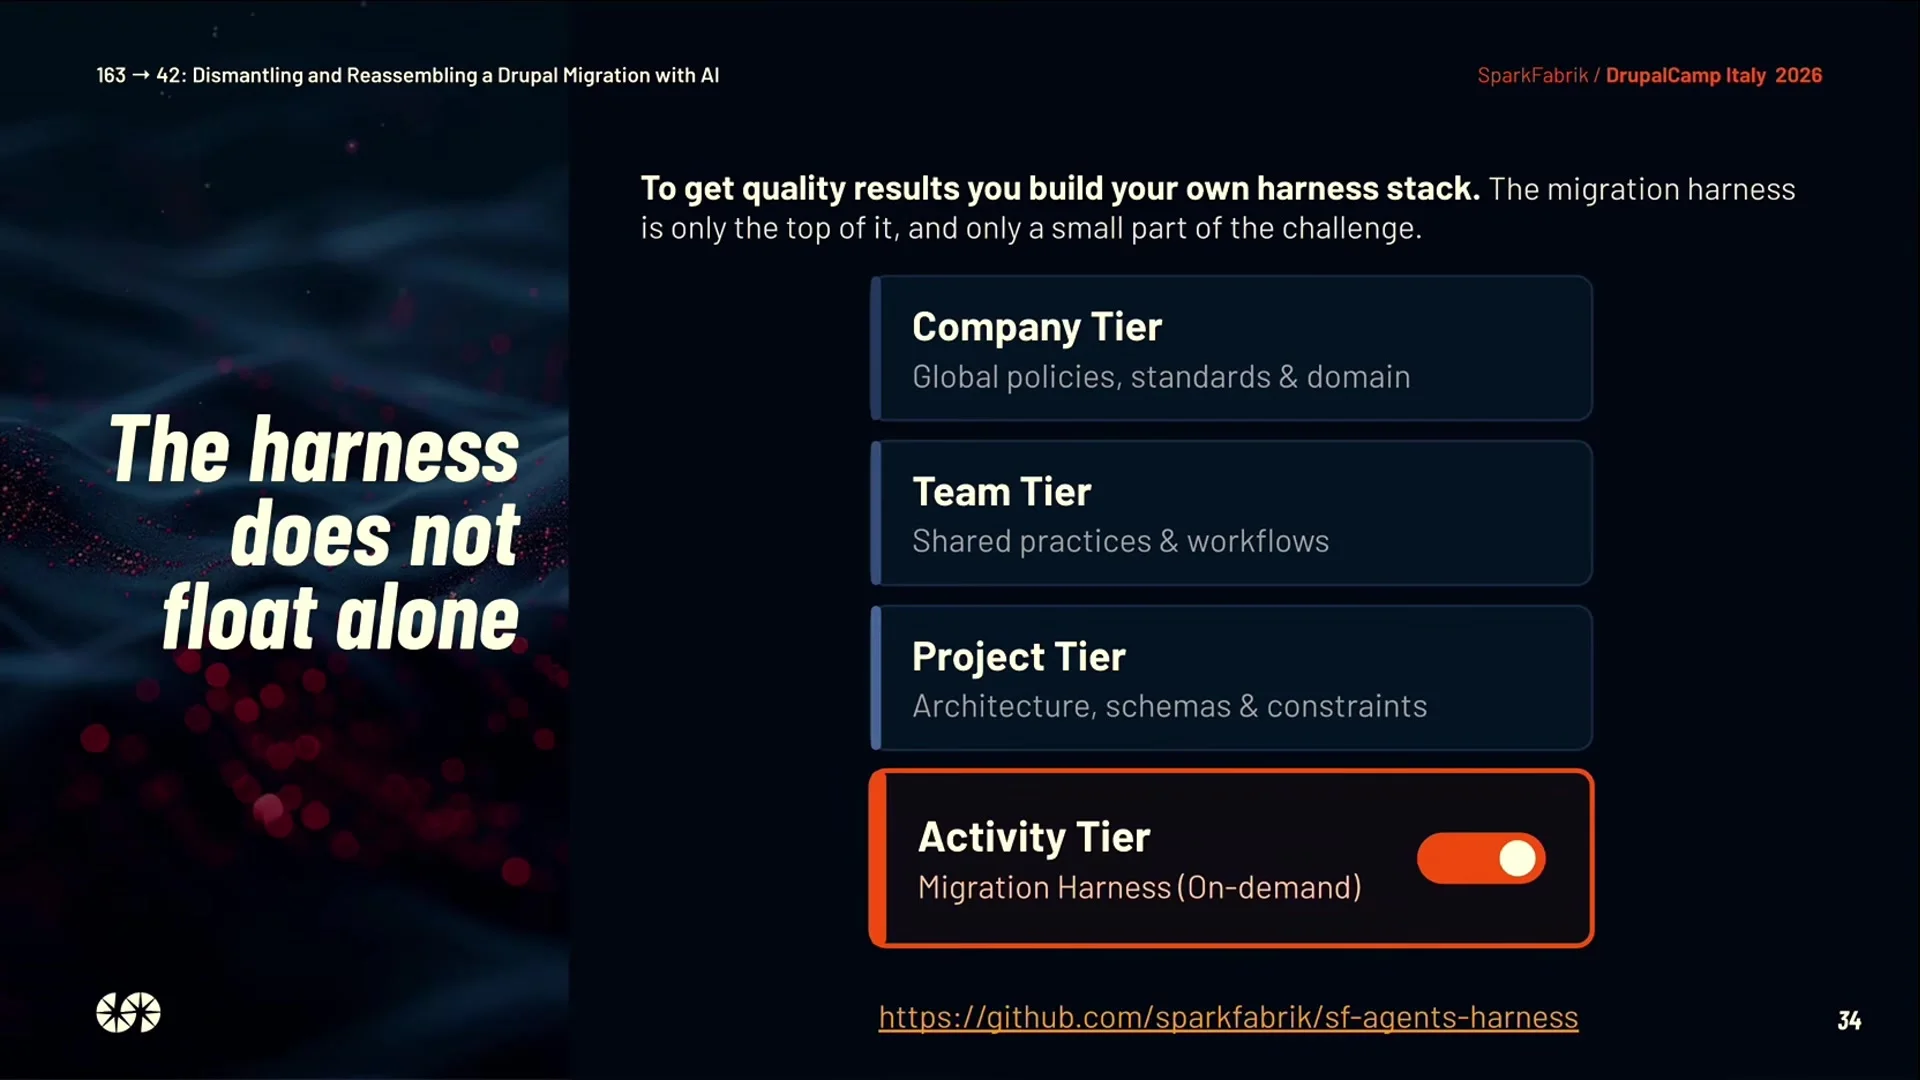
L’orchestratore decide quale skill applicare a quale contenuto, in che ordine e con quale politica in caso di errore, ed è il terzo elemento del framework proposto da Peruzzo. Nei sistemi multi-agente la scomposizione più naturale segue le responsabilità: un agente analizza la sorgente e classifica i casi, uno o più agenti applicano le skill di trasformazione, un agente o un passaggio dedicato valida il risultato contro il content model. Le skill e l’agente usati nel progetto sono pubblici nel plugin drupal-migrate del repository sf-agents-harness di SparkFabrik.
Due pattern si prestano a questa organizzazione. Nel pattern orchestratore-worker un agente centrale riceve il contenuto, attiva i worker necessari e ne raccoglie i risultati: gestisce bene contenuti eterogenei e instrada un caso anomalo verso una skill specifica, ma concentra logica e consumo di token nel coordinatore. La pipeline sequenziale fa passare ogni contenuto per stadi fissi, dalla classificazione, alla trasformazione, alla validazione. In questo modo è più prevedibile, più facile da osservare e da rieseguire stadio per stadio, ma si adatta peggio quando i casi della sorgente richiedono percorsi diversi. Le due forme possono convivere, con una pipeline per i casi noti e un orchestratore per quelli che sfuggono alla classificazione.
Qualunque sia il pattern, l’orchestrazione deve gestire stato e idempotenza: rieseguire una skill non deve duplicare contenuti né sovrascrivere correzioni manuali. Il tracciamento tra ID sorgente e ID destinazione della Migrate API è il riferimento naturale, perché registra cosa è già stato importato e con quale esito. Come buona pratica generale, i casi incerti vanno indirizzati a una persona, con la classificazione proposta e la sua motivazione, invece di essere forzati in una struttura plausibile.
Anche l’interfaccia tra agenti e sistemi merita una scelta esplicita. MCP (Model Context Protocol) è un protocollo aperto che standardizza il modo in cui agenti e modelli AI si collegano a strumenti e fonti dati esterne (Roberto è anche maintainer proprio del modulo MCP Client di Drupal5). In un’architettura di questo tipo è un’opzione concreta per esporre agli agenti la lettura della sorgente e la scrittura verso Drupal come strumenti con permessi definiti, per esempio accesso in sola lettura al database legacy e scrittura limitata alle operazioni di import.
I costi vanno messi nel conto fin dall’inizio. Crescono i componenti da progettare, versionare e osservare, ciascuno con modalità di errore proprie, e anche l’orchestratore consuma chiamate al modello, per cui parte del beneficio ottenuto riducendo il contesto delle skill si sposta sul coordinamento. I contratti delle skill presuppongono un’analisi iniziale della sorgente che richiede tempo di persone esperte, e una frammentazione eccessiva sposta la complessità dal prompt alla rete di dipendenze. Non ogni migrazione giustifica questa architettura; una sorgente regolare resta un lavoro per la Migrate API classica, dove l’AI aggiungerebbe costo e incertezza.
Il talk di Roberto è basato su un progetto reale oggi in produzione, ma non si prefigge di fornire un benchmark, quindi un esperimento simile va valutato con metriche proprie: la quota di output di ciascuna skill che supera la validazione, il numero di riesecuzioni per skill, la distribuzione del consumo di token tra skill e orchestratore, la quota di casi che finisce in revisione umana. Sono misure di osservabilità tipiche dei workflow agentici, come abbiamo raccontato parlando di AgentOps, e indicano dove intervenire: una skill che fallisce spesso va scomposta o resa deterministica, un orchestratore che consuma troppo va semplificato.
Infine, va evidenziato come i modelli e gli strumenti disponibili cambino più in fretta di quanto duri un progetto di migrazione enterprise. Responsabilità separate, contratti espliciti e verifica in isolamento restano invece validi quando il modello sottostante viene sostituito, una sostituzione che la dependency inversion rende possibile.
Da dove partire per ingegnerizzare la migrazione
Un esperimento di questo tipo si imposta prima ancora di collegarsi a un modello. La sequenza rispecchia l’ordine logico del framework, dall’analisi della sorgente alla validazione del risultato:
- Inventariare le trasformazioni che la sorgente richiede, formalizzando la procedura manuale prima di scrivere qualunque prompt.
- Separare le trasformazioni deterministiche, che restano regole e process plugin della migrazione, da quelle interpretative che giustificano un LLM.
- Dare a ogni skill un contratto di input e output e un set di casi reali della sorgente su cui testarla.
- Assegnare gli agenti per responsabilità e definire in modo esplicito quando un caso passa a una persona.
- Validare ogni output contro il content model dichiarato nella configurazione Drupal, prima di qualunque import definitivo.
Il primo passo produce valore anche se l’esperimento si ferma lì, perché un inventario delle trasformazioni rende stimabile la migrazione e mostra quali parti richiedono davvero l’AI. Il talk di Roberto Peruzzo sulla migrazione Drupal con AI va letto come un invito a trattare i prompt con la stessa disciplina che si riserva al codice: contratti, test, responsabilità separate e una persona che decide sui casi incerti.
Se state pianificando un replatforming o una migrazione verso Drupal, il nostro team Drupal parte dall’analisi della sorgente e dall’inventario delle trasformazioni. Così stimiamo il lavoro e decidiamo dove bastano le regole della Migrate API e dove serve l’AI.
Se invece volete applicare lo stesso metodo anche oltre la migrazione, con skill dai contratti espliciti, agenti divisi per responsabilità e revisione umana sui casi incerti, l’AI Native Journey di SparkFabrik è il percorso con cui accompagniamo i team nell’adozione dell’AI nei processi di sviluppo.
Note e fonti
Registrazione del talk di Roberto Peruzzo a DrupalCamp Italy 2026. (fonte: www.youtube.com/watch?v=JMwC9HRYcGo) ↩︎
Registrazione del talk di Roberto Peruzzo a DrupalCon Rotterdam 2026. (fonte: www.youtube.com/watch?v=kPHC6m8FB2o) ↩︎
«Projects maintained Ai dev recipe Google Shopping Feed Imagecache Cron Flush Iubenda Integration Lara Translate Provider MCP Client Panther Search API Typesense Typesense RAG recipe» (fonte: www.drupal.org/u/robertoperuzzo) ↩︎
Secondo Len Swaneveld, alla DrupalCon Europe 2026, codice e architettura puliti sono una forma di context engineering e una salvaguardia contro gli LLM che vanno fuori strada, perché un LLM ragiona solo su ciò che vede e indovina il resto. Tre fonti di feedback per mantenere il codice pulito: review umana, analisi statica con PHPStan e PHPCS, test con code coverage e CRAP score. (fonte: Guardrail, migrazioni AI, MCP: cosa abbiamo portato a Rotterdam) ↩︎
Pagina del modulo MCP Client su drupal.org, di cui Roberto Peruzzo è maintainer. (fonte: www.drupal.org/project/mcp_client) ↩︎
Fonte video
Questo articolo è basato sul video “163 → 42: smantellare e riassemblare una migrazione Drupal con l’IA | Roberto Peruzzo”.