Chiedi a un coding agent di aggiungere un’alterazione di form a un modulo Drupal e ricevi spesso una funzione procedurale nel file .module, con il nome del modulo come prefisso. Chiedigli un plugin di blocco e la classe arriva con un’annotazione nel docblock. Sono convenzioni che il Drupal attuale ha sostituito con gli attributi PHP: il codice generato in molti casi funziona ancora, ma va riscritto prima della review. Chi lavora con un approccio agentic-first allo sviluppo Drupal conosce questa correzione ripetuta, perché ricompare a ogni task e consuma parte del tempo che l’agent avrebbe dovuto liberare.
Luca Lusso1, Lead Developer in SparkFabrik, ha affrontato il problema a DrupalCamp Italy 2026, evento di cui SparkFabrik è tra gli organizzatori, presentando DRI (Drupal RAG Intelligence). Luca ha descritto il talk come un esperimento che mescola Drupal, AI e PHP in generale. DRI è uno strumento progettato per guidare i coding agent nella generazione di codice Drupal moderno; è uno strumento interno, usato dal team sui propri progetti e non disponibile pubblicamente.
Il difetto che DRI corregge ha origine nell’addestramento dei modelli. Il modo in cui un LLM ha imparato Drupal, leggendo codice pubblico accumulato nel tempo, determina quali convenzioni propone quando nessuno gli mostra un’alternativa.
Perché un coding agent scrive Drupal superato
I coding agent scrivono Drupal superato perché lo hanno imparato così. Secondo Luca, i modelli sono stati addestrati su una grande quantità di PHP scritto male e ripropongono convenzioni Drupal che il core ha già superato. Il motivo risiede nella composizione dei dati di addestramento dei modelli: moduli contrib, risposte sui forum, tutorial e snippet descrivono per lo più il modo precedente di fare le cose, mentre il codice che usa le API attuali sarebbe una porzione recente e minoritaria del corpus.
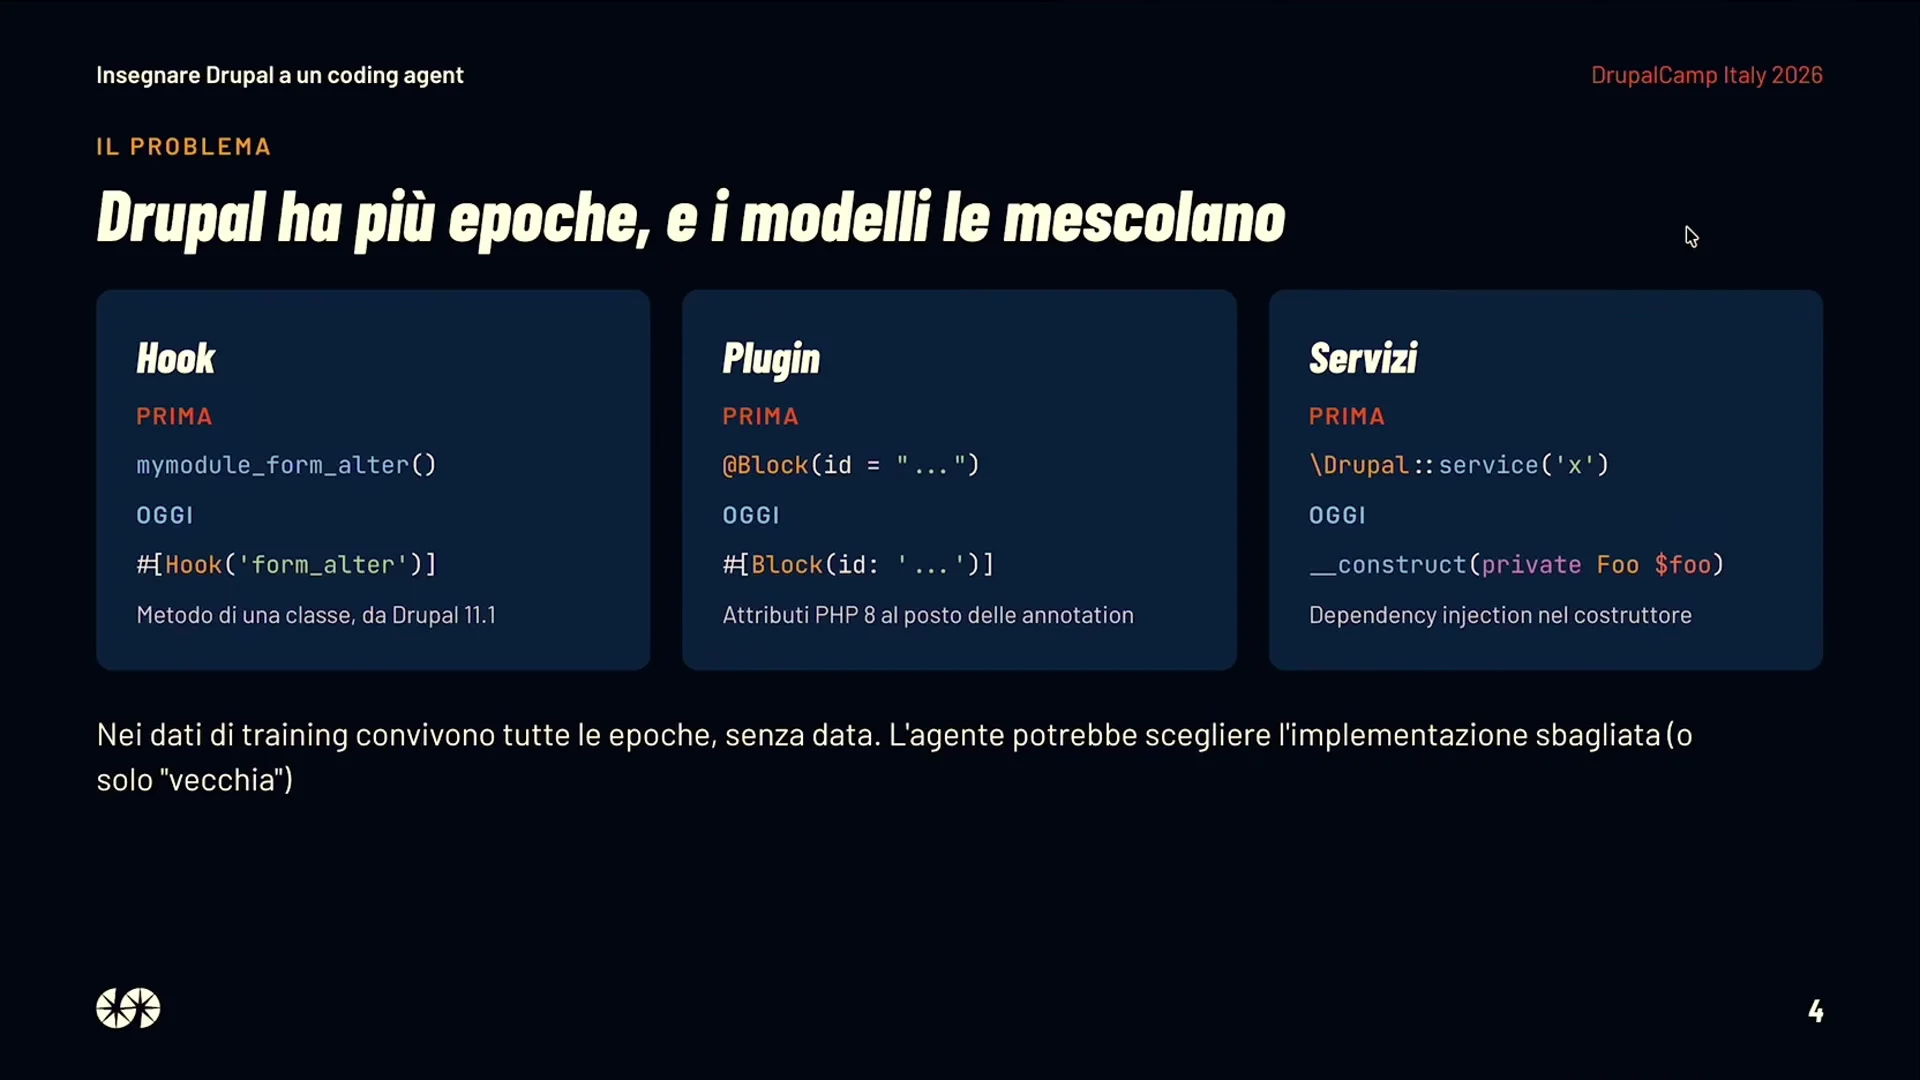
Due esempi tornano più di altri nel talk. Il primo sono gli hook procedurali nel file .module, al posto dei metodi di classe marcati con l’attributo Hook; il secondo sono le annotazioni nei docblock dei plugin, al posto degli attributi PHP. Da Drupal 10.2 il core usa gli attributi PHP per la discovery dei plugin, e da Drupal 11.1 gli hook possono essere implementati come metodi di classe, con l’attributo Hook che dichiara quale hook il metodo implementa2. Lo stesso slittamento riguarda i servizi, che il codice più vecchio recupera con chiamate statiche al container invece di riceverli tramite dependency injection.
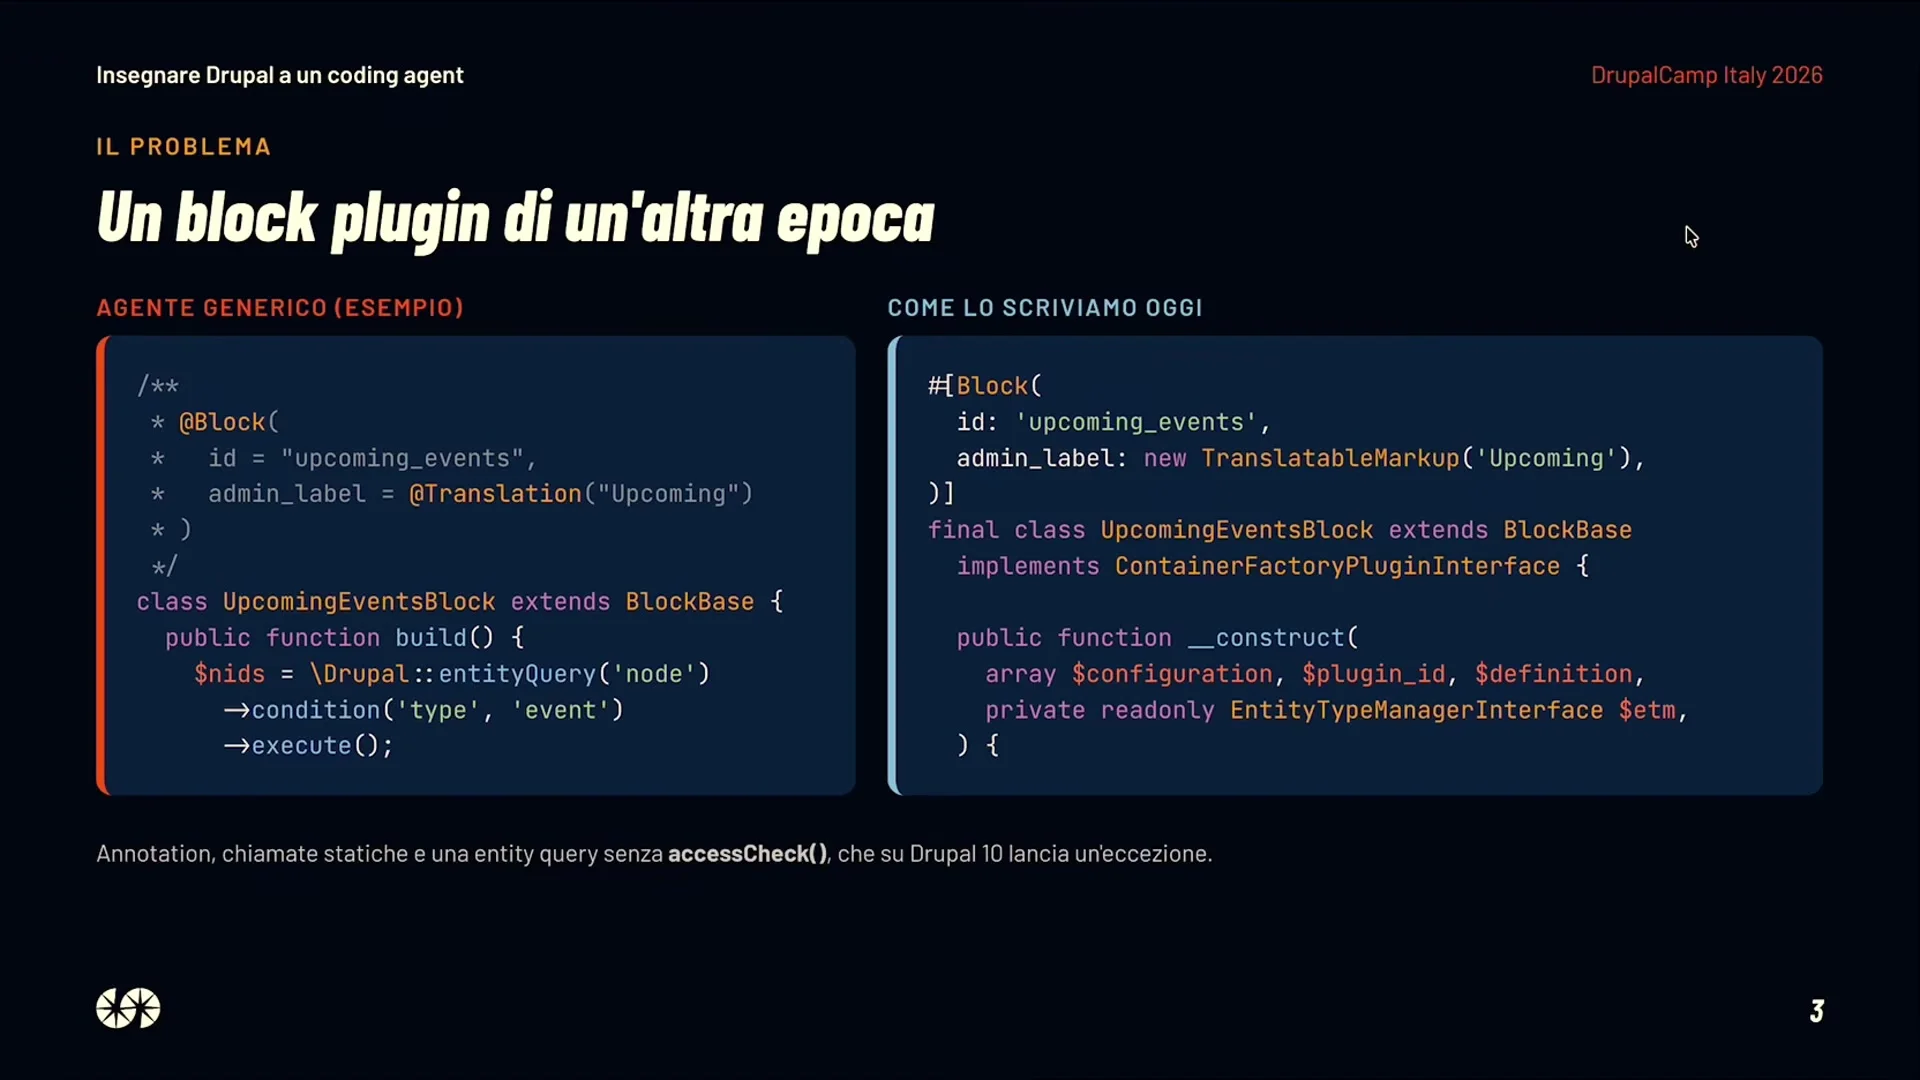
Il risultato è un modello che mescola le epoche. Può produrre un plugin con l’attributo corretto e, nello stesso modulo, un hook in stile procedurale, perché per lui entrambi sono Drupal valido. Il core mantiene la compatibilità con le convenzioni precedenti, quindi il codice spesso gira senza errori, ma introduce debito tecnico in un progetto che ha scelto gli standard attuali e costringe chi fa review a riscriverlo.
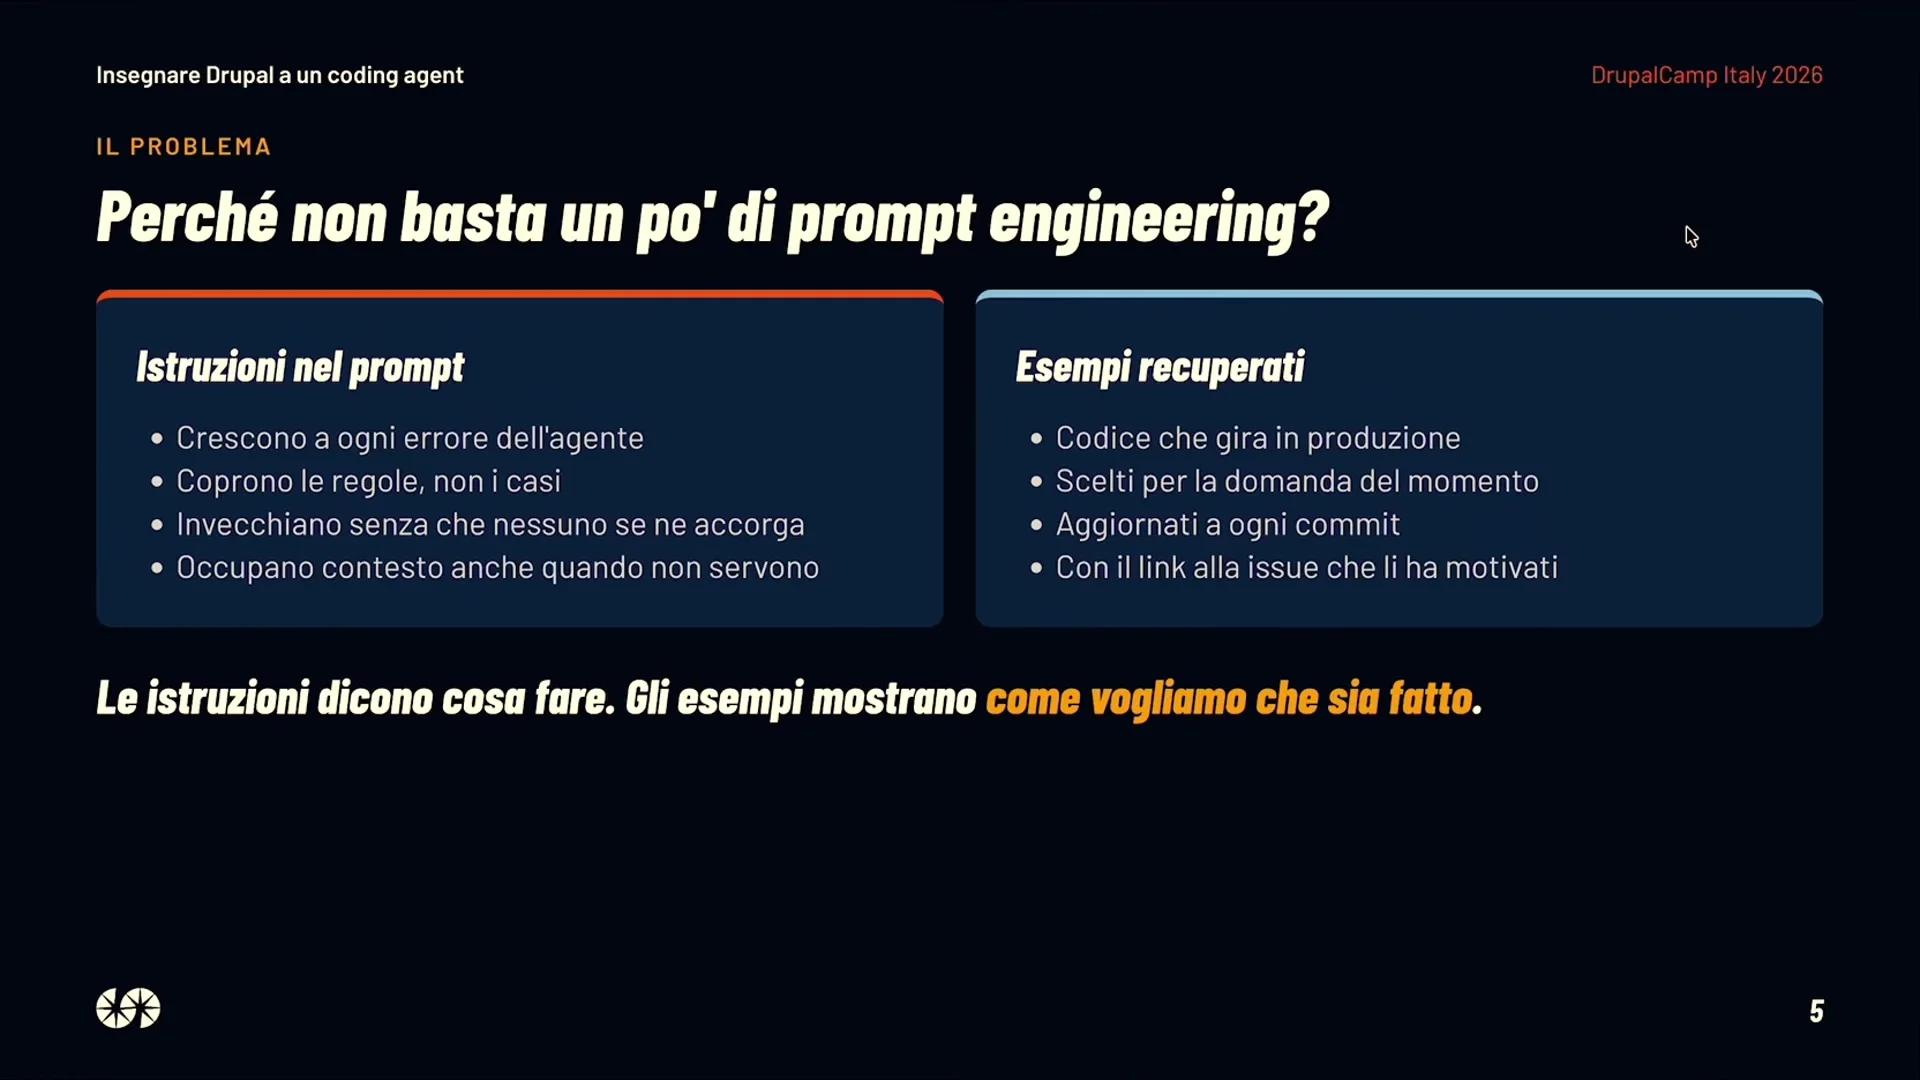
La risposta più immediata sarebbe un prompt più lungo, con istruzioni come «usa gli attributi, non le annotazioni». Un’istruzione generica però compete con la frequenza dei pattern appresi in addestramento, occupa finestra di contesto e descrive il risultato atteso senza mostrare come si scrive. Ogni convenzione nuova richiede una regola in più, e una lista di divieti cresce più in fretta di quanto un team riesca a mantenerla aggiornata.
DRI segue un’altra strada. Invece di prompt più lunghi, dà all’agent esempi presi dal codice dei progetti del team. Quando deve scrivere un hook, l’agent recupera hook già scritti e revisionati nei progetti, con le convenzioni che il team ha adottato. Da qui il senso di “memoria” nel titolo: la memoria RAG dell’agent è l’indice del codice del team, e l’agent impara le convenzioni attuali leggendo codice reale anziché regole astratte.
A Talks On My Machine Drupal 2026, l’evento che organizziamo, un talk era dedicato all’uso di un coding agent in Drupal che vada oltre il vibe coding. DRI lavora su una parte specifica dello stesso tema, cioè quale codice l’agent prende come esempio quando scrive Drupal.
Come DRI costruisce la memoria del codice
Se la soluzione sono gli esempi, la qualità dell’output dipende da cosa entra nell’indice e da come viene spezzato. DRI indicizza la codebase interna combinando tre tecniche: RAG semantico, analisi dell’Abstract Syntax Tree e metadati strutturali con riferimenti Git. Ciascuna risolve un problema diverso del recupero di codice.
La retrieval-augmented generation (RAG) è il meccanismo per cui il modello, prima di generare, riceve nel contesto frammenti recuperati da un indice. Il materiale viene diviso in chunk, ogni chunk viene trasformato in un embedding, cioè un vettore numerico che ne rappresenta il significato, e la ricerca semantica restituisce i chunk più vicini alla richiesta. L’albero sintattico astratto (AST) è invece la struttura del codice come la legge il parser. Classi, metodi, funzioni e attributi diventano nodi con relazioni esplicite, non righe di testo.
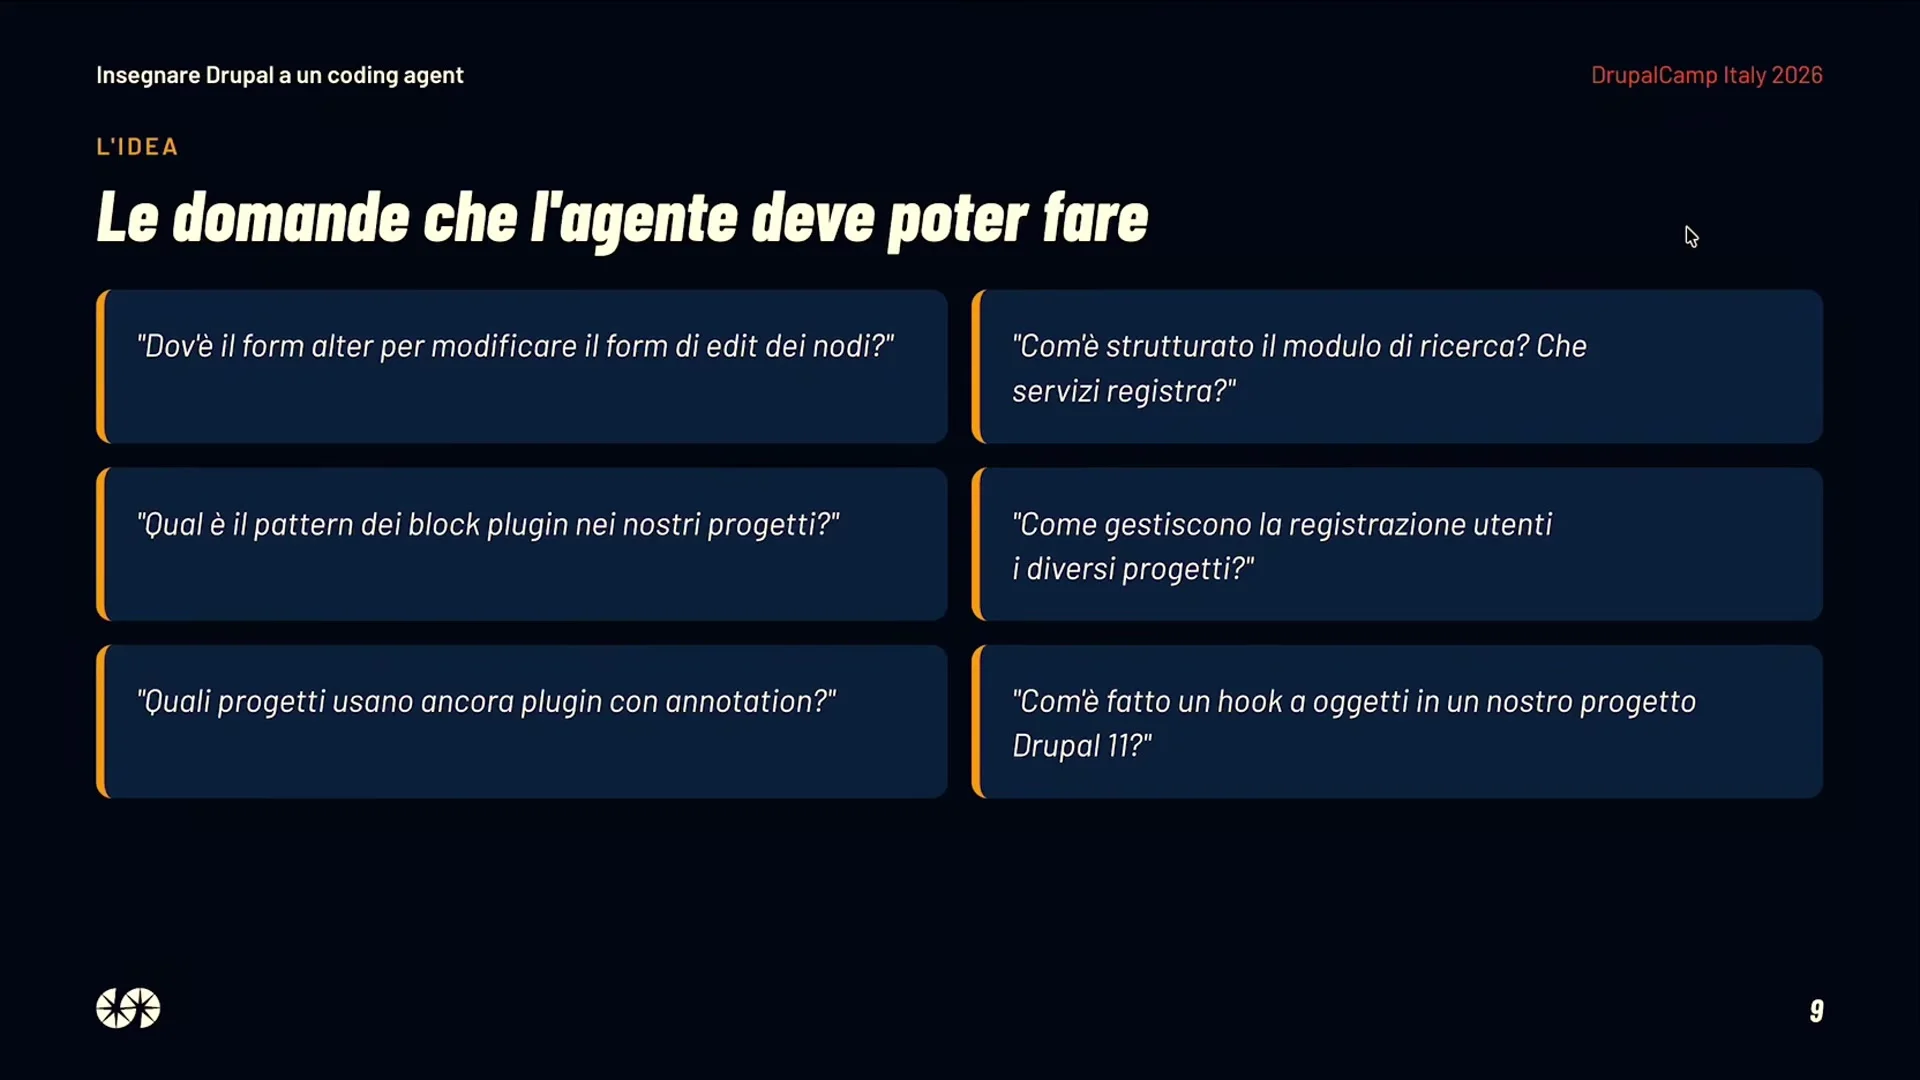
Il lavoro di DRI si divide in due percorsi. L’indicizzazione legge le codebase, le spezza e popola l’indice; l’interrogazione risponde alle richieste dell’agent recuperando i frammenti pertinenti.
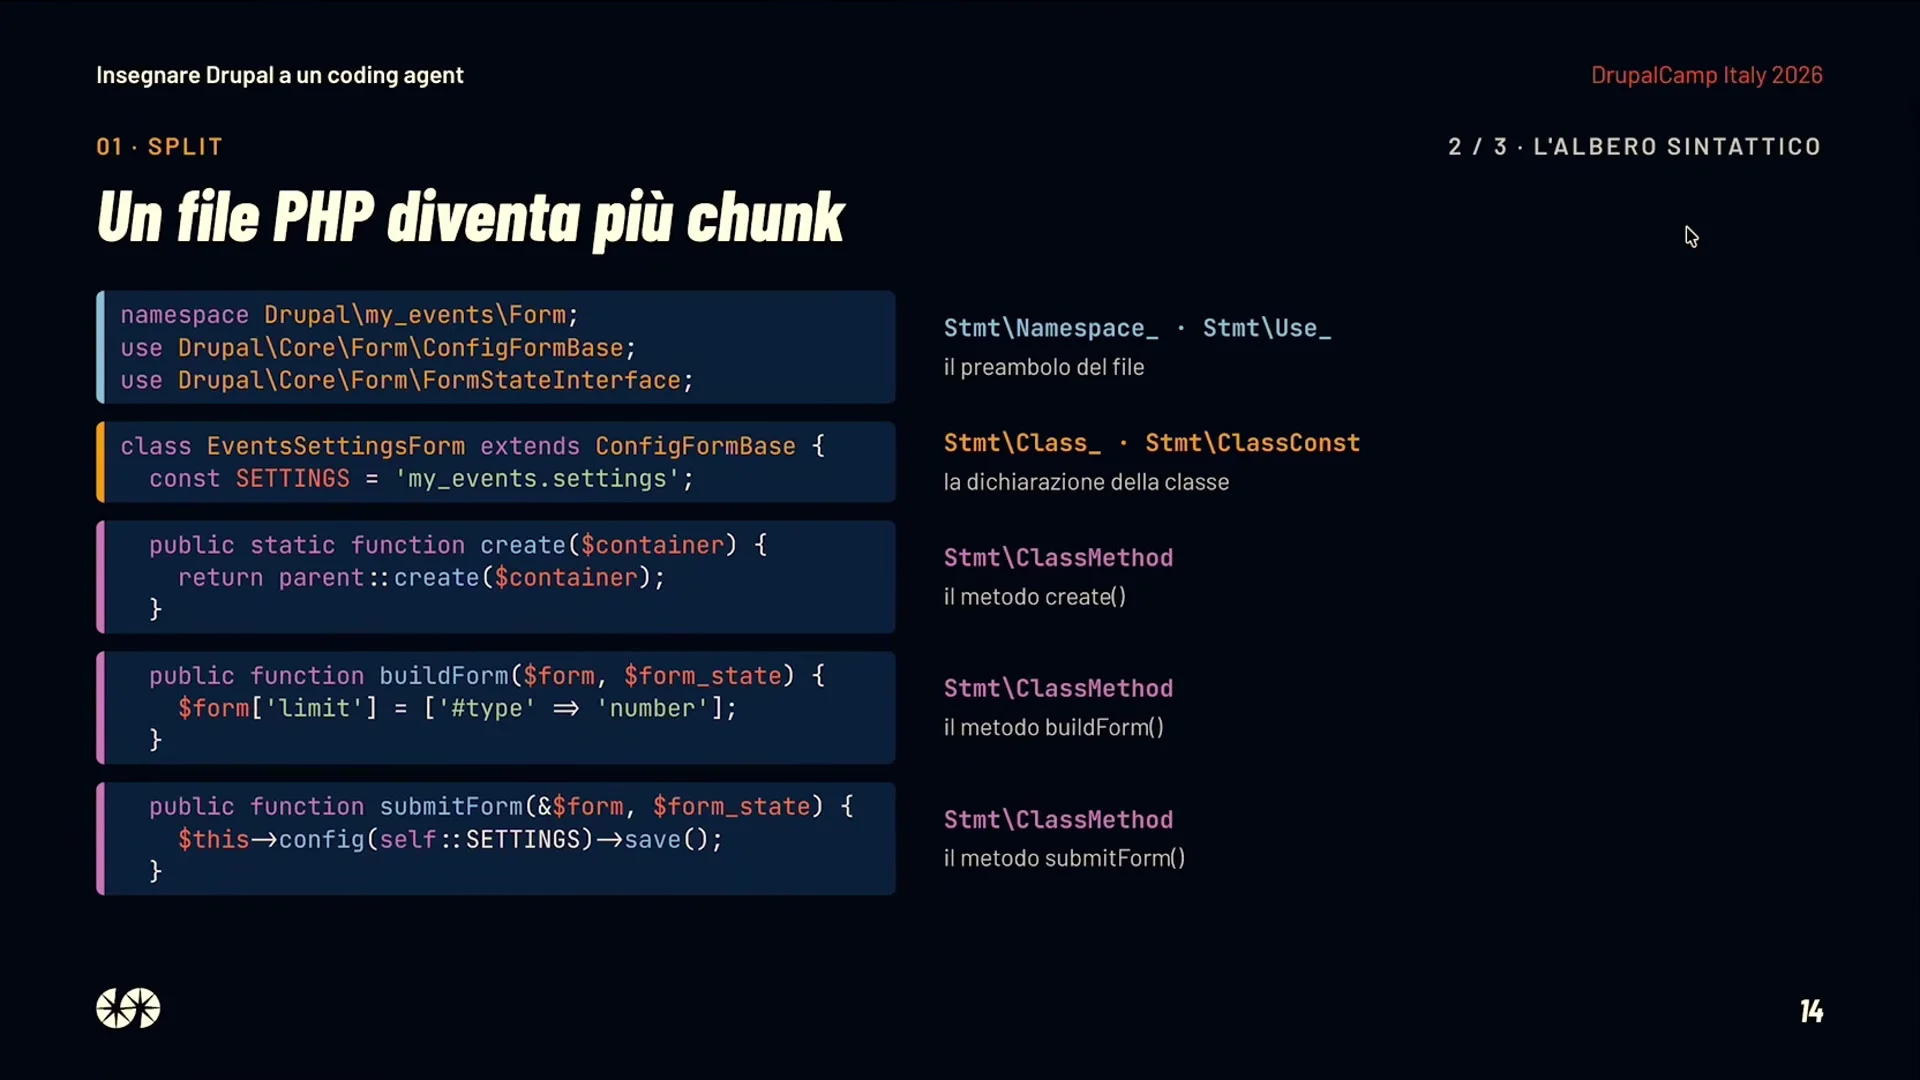
Il primo problema è dove tagliare. Uno splitter a finestre di testo divide un file in blocchi di lunghezza fissa e può spezzare un metodo a metà, oppure unire la coda di una classe con l’inizio di un template Twig. DRI usa l’AST per un chunking semantico. Il codice viene diviso per unità di senso, cioè classi, metodi, hook e template, così che ogni chunk corrisponda a un’unità che uno sviluppatore riconoscerebbe come tale.
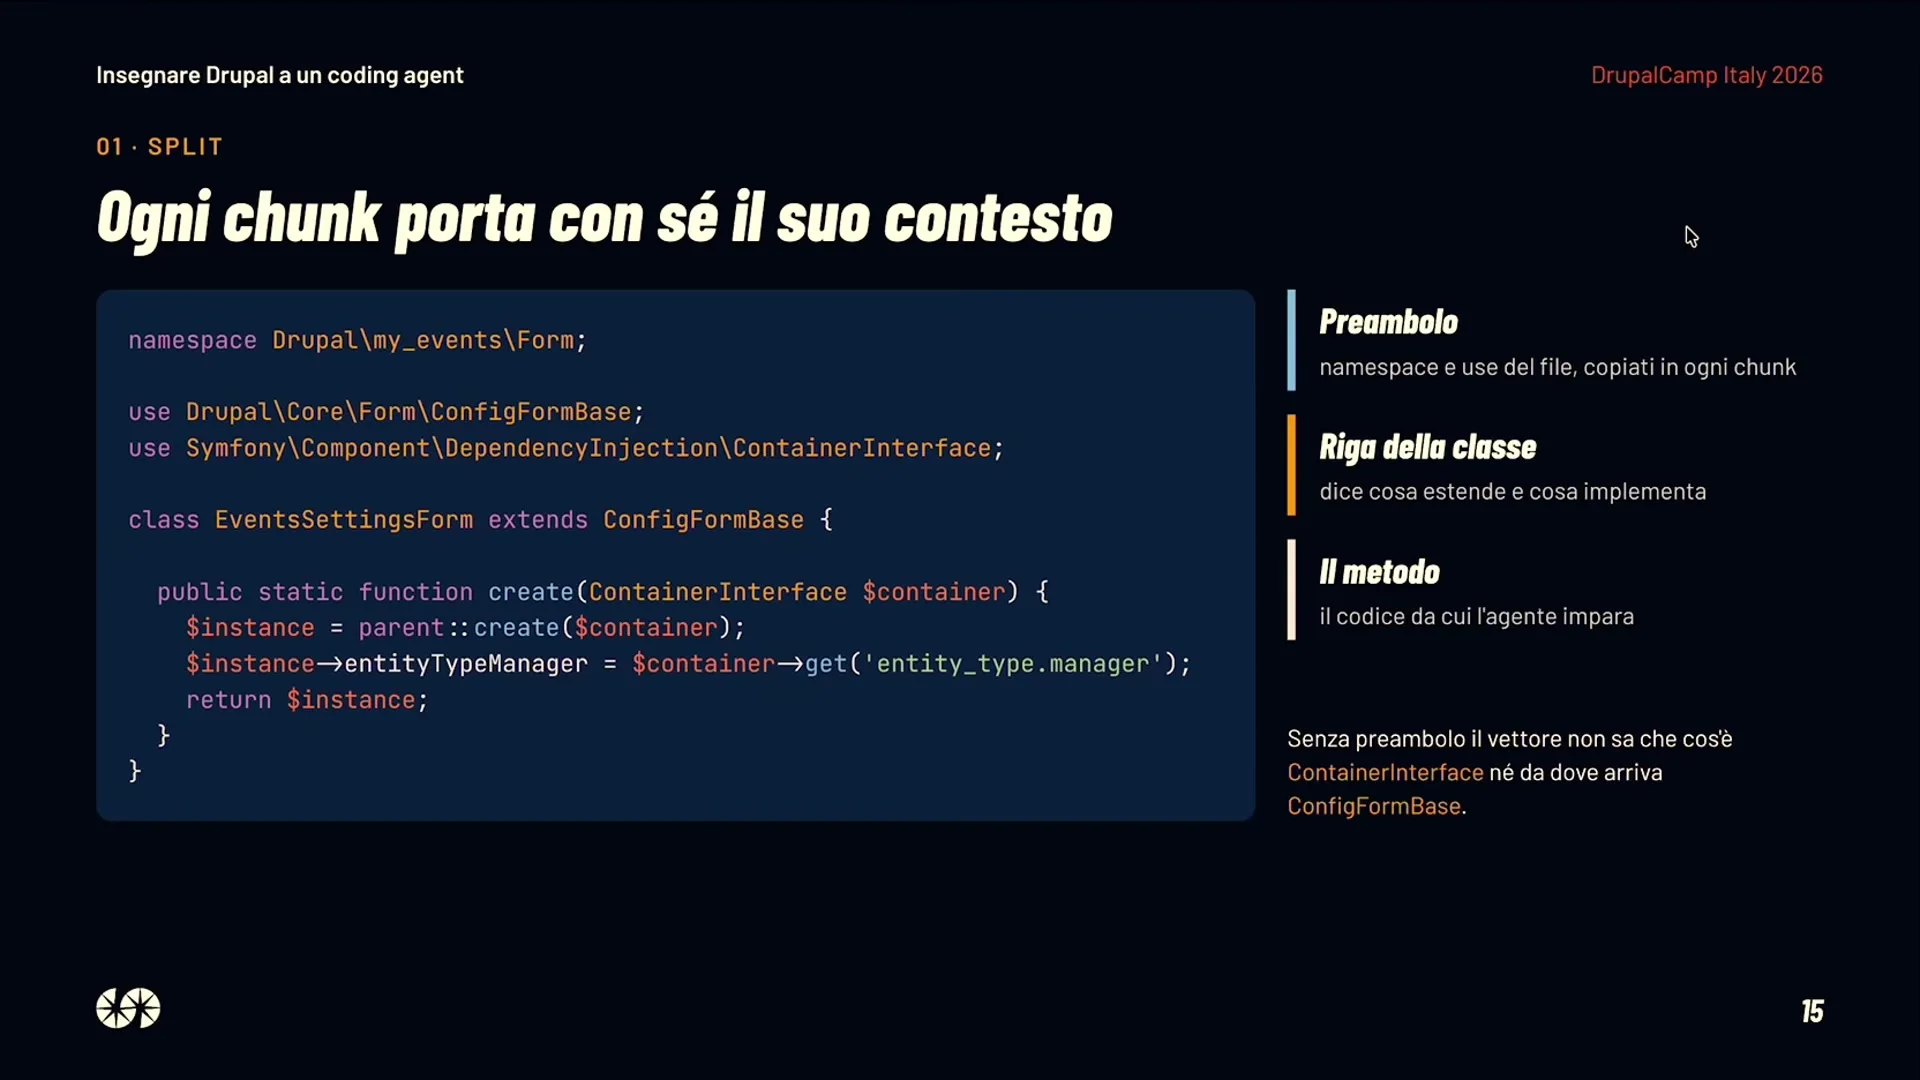
Il secondo problema è il contesto perso. Un metodo estratto dalla sua classe non dice più in quale namespace vive né quali classi importa, e senza queste informazioni l’agent non può sapere se quel metodo usa il servizio del core o una classe omonima di un altro modulo. Per questo DRI copia namespace e istruzioni use in ogni chunk: ogni frammento resta leggibile e utilizzabile anche isolato, e l’embedding che ne deriva rappresenta il metodo insieme alle sue dipendenze.
L’AST serve anche a riconoscere i pattern Drupal. DRI distingue, per esempio, un hook vecchio stile dichiarato come funzione nel file .module da un hook dichiarato come metodo con l’attributo Hook, e registra la differenza tra i metadati del chunk. Questo collega direttamente l’indicizzazione al difetto di partenza, perché l’indice sa quale convenzione segue ciascun frammento e il recupero dispone di un’informazione che la sola similarità non fornisce.
I metadati strutturali arrivano da Git e GitLab, inclusi i messaggi di commit. Il codice dice cosa fa un metodo, mentre il commit che lo ha introdotto spesso dice perché: che una certa implementazione sostituisce un hook deprecato, o che corregge un comportamento in un caso limite. Associare questi riferimenti a ogni chunk aggiunge provenienza e intenzione, due informazioni che il sorgente da solo non porta.
L’indice di DRI vive su Firestore, usato come database vettoriale. La codebase indicizzata è controllata con PHPStan, PHPCS e Rector, cioè analisi statica, rispetto degli standard di codice e verifica delle regole di modernizzazione. Senza questi controlli l’indice riproporrebbe gli stessi difetti dei dati di addestramento, e l’agent li riceverebbe come esempi approvati dal team.
CLI, skill e cosa ha mostrato il test alla cieca
L’indice si interroga tramite una CLI in linguaggio naturale. Chi la usa descrive cosa cerca, per esempio un’implementazione di un hook di alterazione dei form o un plugin di campo con validazione, e riceve i chunk più pertinenti con i relativi metadati. Dal talk emerge un punto che vale per qualunque strumento messo a disposizione di un agent: la CLI da sola non basta. Serve una skill, cioè un insieme di istruzioni che spiega all’agent come usare la CLI, quando consultare l’indice e come sfruttare i risultati.
Un agent che ha accesso a un comando della CLI senza conoscerne lo scopo tende a ignorarlo e a scrivere il codice dalla propria memoria parametrica, cioè proprio dai dati di addestramento che DRI cerca di correggere. Oppure, lo interroga con query troppo generiche, che restituiscono frammenti poco utili per il task. La skill trasforma l’accesso in una pratica ripetibile, perchè prima di scrivere codice Drupal l’agent cerca come il team lo ha già scritto. (A DrupalCamp Italy 2026 e DrupalCon Rotterdam 2026 abbiamo anche raccontato un altro uso delle skill in un progetto Drupal, con skill atomiche e agenti AI applicati a una migrazione.)
Il principio è coerente con il modo in cui intendiamo l’ingegneria del software AI native: l’agent lavora meglio quando le regole d’uso degli strumenti sono scritte in modo esplicito e non lasciate all’iniziativa del modello. Nel caso di DRI quella regola riguarda un solo strumento, ma ne determina l’utilità e l’efficacia.
Per valutare l’effetto, Luca ha presentato un test comparativo alla cieca con 4 sviluppatori e 8 task, in cui le soluzioni prodotte con DRI sono state confrontate con quelle prodotte senza. Per ogni task gli sviluppatori hanno indicato quale soluzione preferivano, e i voti si sono distribuiti così.
| Con DRI | Senza DRI | Parità |
|---|---|---|
| 21 | 9 | 2 |
Il campione è piccolo, quindi il risultato non dimostra che il codice prodotto con DRI sia migliore in generale. La preferenza resta però netta: le soluzioni con DRI hanno raccolto più del doppio dei voti di quelle senza.
Il talk riporta anche il prezzo di questo risultato. Con DRI ogni task è costato di più, e le soluzioni hanno richiesto circa il doppio dei token e il doppio del tempo di esecuzione. Ogni recupero dall’indice aggiunge passaggi al lavoro dell’agent: la query alla CLI, la lettura dei chunk restituiti, il confronto con il codice da scrivere. Ogni frammento entra nella finestra di contesto e si paga in token, e ogni consultazione allunga l’esecuzione.
Per un team il bilancio si misura sul tempo complessivo. Il costo aggiuntivo in token va confrontato con il tempo che uno sviluppatore spenderebbe a riscrivere in review un hook procedurale o un plugin con annotazioni, e il test non misura questo secondo termine. La valutazione resta quindi caso per caso, legata al volume di codice Drupal che l’agent produce e a quanto pesano oggi le correzioni.
Limiti della ricerca vettoriale e lezioni su chunking e contesto
Il talk si chiude con un’analisi critica dei limiti attuali della ricerca vettoriale e con le lezioni apprese durante lo sviluppo di DRI su chunking semantico e gestione del contesto. Questi limiti riguardano qualunque sistema RAG costruito su codice sorgente.
Il primo riguarda la distanza tra vicinanza e correttezza. La similarità tra embedding misura quanto due frammenti trattano la stessa cosa e non dice nulla su quale dei due sia scritto secondo le convenzioni attuali: un hook procedurale che altera un form e lo stesso hook dichiarato con l’attributo Hook occupano posizioni molto vicine nello spazio vettoriale, perché fanno la stessa cosa con nomi e logica quasi identici.
Il secondo riguarda gli identificatori esatti. Nomi di classi, ID di servizi, nomi di funzioni e di hook sono stringhe precise, che la ricerca vettoriale tratta come significato approssimato, mentre una ricerca lessicale o ibrida li trova in modo più affidabile.
Una risposta diffusa, presente anche nel talk, è il recupero a due stadi. Un primo stadio KNN recupera i candidati più vicini all’embedding della richiesta, poi un reranker li riordina valutando richiesta e candidato insieme. L’ordine dei risultati migliora, ma il secondo stadio lavora solo sui candidati che il primo ha già trovato.
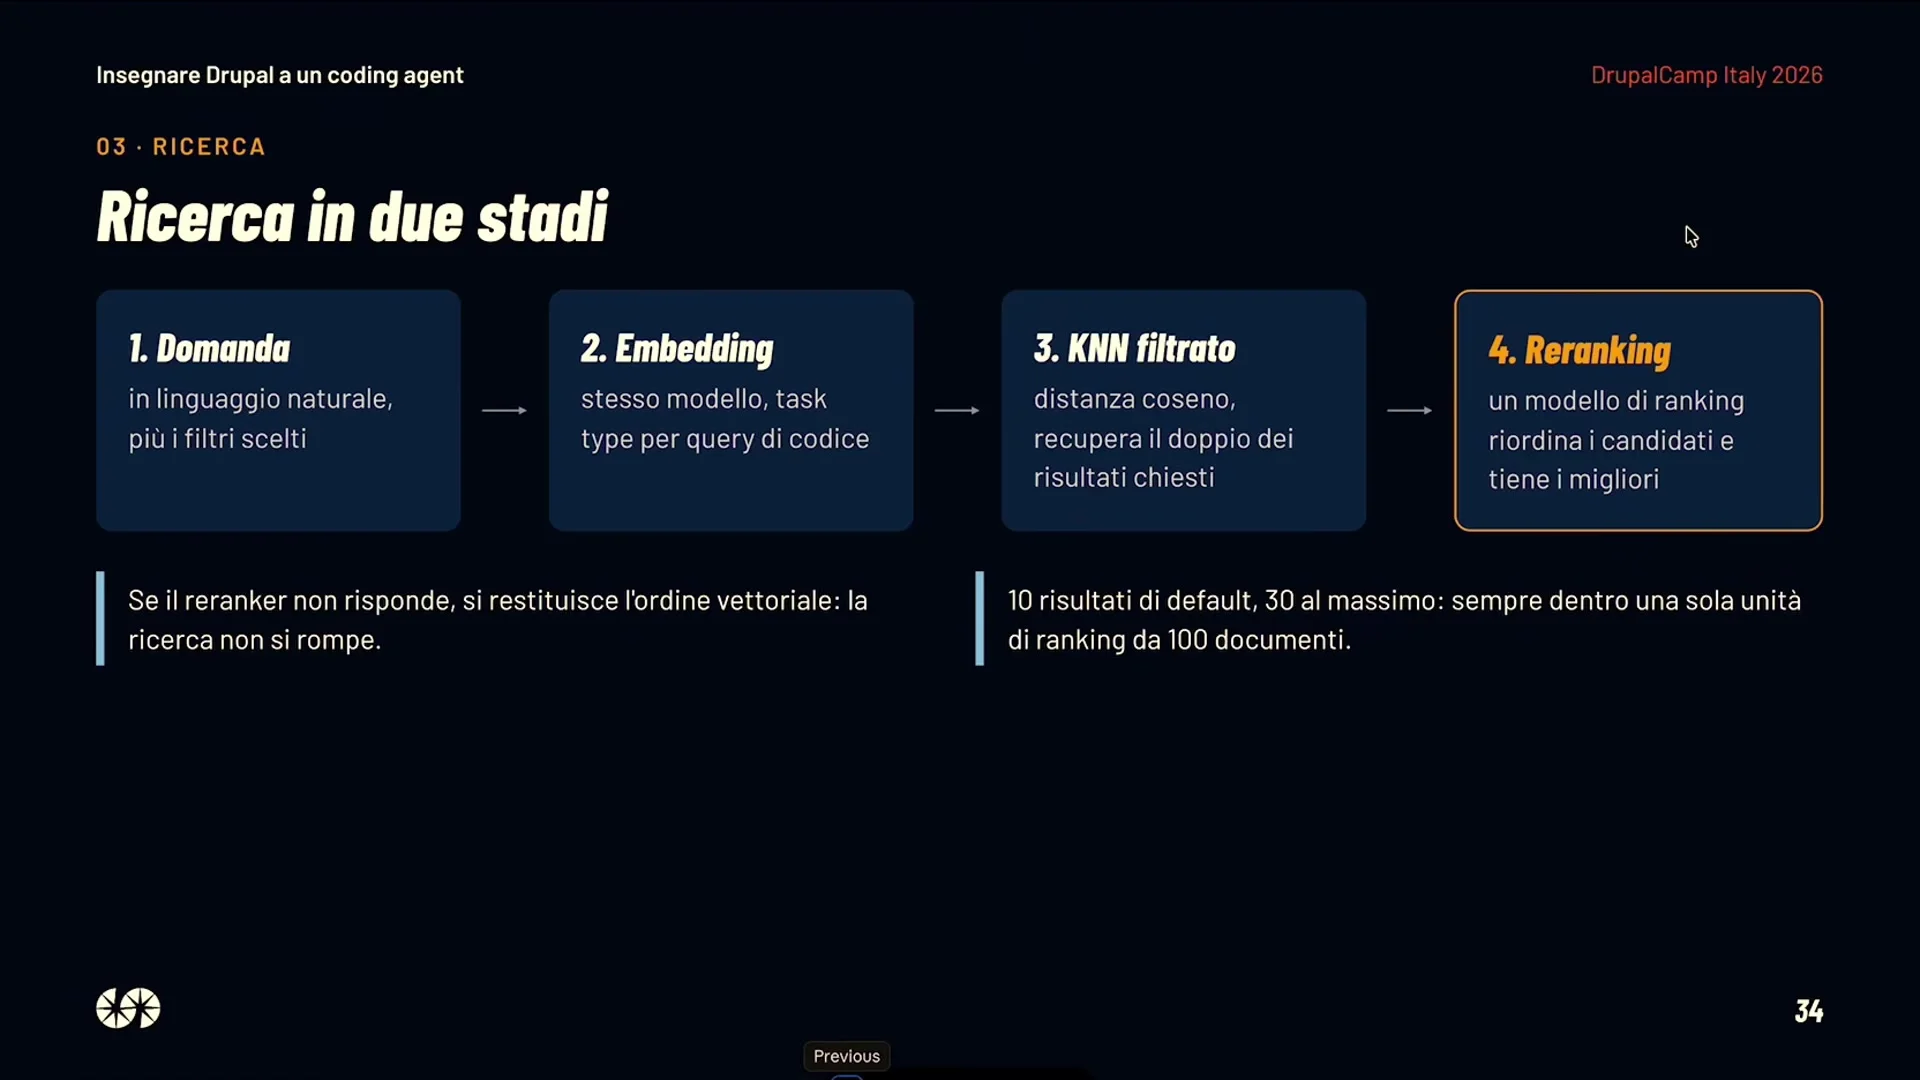
Il modo in cui DRI effettua il chunking del codice ha una ragione precisa. Quando un chunk coincide con un’unità di senso, per esempio un solo metodo, il suo embedding rappresenta una cosa sola e la ricerca lo trova per le richieste che riguardano quella cosa. Un chunk tagliato a righe fisse può invece contenere la fine di un metodo e l’inizio di un altro. Il vettore mescola due significati e non risulta vicino a nessuno dei due, quindi la ricerca non lo restituisce bene per nessuna delle due richieste.
L’analisi AST compensa in parte il limite della pura similarità. Dove l’embedding vede due hook quasi uguali, i metadati strutturali distinguono quello vecchio stile da quello con attributo.
Sulla gestione del contesto le lezioni convergono su tre scelte già presenti nell’architettura:
- Esempi mirati invece di prompt lunghi: pochi frammenti pertinenti mostrano la convenzione attuale meglio di una lista di regole, e occupano contesto solo quando servono al task.
- Una skill per lo strumento: l’accesso all’indice ha valore solo se l’agent sa quando interrogarlo e come usare ciò che riceve.
- Il costo come conseguenza diretta: il raddoppio in token e tempi deriva dal contesto aggiuntivo che ogni recupero porta con sé.
Per chi progetta un sistema simile il trade-off operativo è proprio questo, perché ogni frammento recuperato occupa finestra di contesto e ha un costo. Recuperare meno chunk ma più pertinenti, autosufficienti e annotati con la convenzione che seguono riduce il contesto sprecato senza rinunciare all’effetto degli esempi.
La RAG sul codice ha esigenze diverse dalla RAG sui contenuti di un sito. SparkFabrik ha contribuito all’integrazione di Search API Typesense come database vettoriale per Drupal, che abilita RAG e ricerca semantica su contenuti Drupal indicizzati.3 Il modulo Drupal AI supporta diversi database vettoriali per estendere la conoscenza degli LLM ai dati proprietari, un tema che trattiamo nella panoramica sull’ecosistema Drupal AI. Lì i chunk sono testi editoriali; nel caso di DRI sono unità di codice, con namespace, dipendenze e convenzioni che un parser sa leggere e un embedding da solo coglie solo in parte.
Cosa serve per dare a un agent la memoria del codice
Il principio di DRI si applica a qualunque stack in cui i modelli conoscono le convenzioni vecchie meglio di quelle adottate dal team, e nell’ecosistema PHP i casi sono molti. Dai risultati e dai limiti emersi nel talk si ricavano alcuni criteri pratici per chi vuole provarci:
- Indicizzare solo codice controllato: far passare la codebase da PHPStan, PHPCS e Rector prima che entri nell’indice, perché ogni chunk diventa un esempio per l’agent.
- Spezzare per unità di senso: classi, metodi, hook e template, con namespace e use ripetuti in ogni chunk.
- Insegnare l’uso dello strumento: affiancare alla CLI una skill che dica all’agent quando e come interrogare l’indice.
- Mettere a budget più token e più tempo: il costo per task aumenta, e va confrontato con il tempo risparmiato in review.
- Non affidarsi alla sola similarità: usare l’analisi strutturale per distinguere il codice attuale da quello superato.
Nel nostro team DRI resta uno strumento interno, usato sui progetti per capire dove la memoria del codice ripaga il suo costo. La presentazione completa di Luca, con il dettaglio dell’architettura e la discussione sui limiti della ricerca vettoriale, è nel video del talk a DrupalCamp Italy 2026.
Se volete applicare lo stesso principio ai vostri progetti Drupal, con agent che lavorano su esempi del vostro codice, regole d’uso degli strumenti scritte in modo esplicito e controlli statici sulla codebase, l’AI Native Journey è il percorso con cui accompagniamo i team nell’adozione dell’AI nei processi di sviluppo. Lo affianca il nostro team Drupal, che lavora sulla codebase e sulle convenzioni del progetto.
Domande frequenti
Cos’è DRI?
DRI (Drupal RAG Intelligence) è uno strumento interno di SparkFabrik. Indicizza il codice dei progetti del nostro team e lo rende consultabile da un coding agent. Lo scopo è guidare l’agent verso Drupal moderno, usando come riferimento esempi del nostro codice invece delle convenzioni superate che il modello ha visto in addestramento.
Perché i coding agent scrivono codice Drupal superato?
I modelli sono addestrati su una grande quantità di PHP scritto male e su convenzioni Drupal ormai superate. Il risultato è codice che non segue le pratiche attuali, come gli hook nel file .module o le annotazioni al posto degli attributi. Senza esempi aggiornati, l’agent tende a riprodurre i pattern che ha visto più spesso.
Cosa ha mostrato il test alla cieca?
Quattro sviluppatori hanno valutato alla cieca le soluzioni di 8 task, prodotte con e senza DRI. Il risultato: 21 voti per le soluzioni con DRI, 9 per quelle senza e 2 pareggi. Il campione è troppo piccolo per essere statisticamente significativo, ma la preferenza per le soluzioni con DRI è netta.
Quanto costa usare DRI?
Ogni task svolto con DRI è costato di più rispetto alla versione senza, perché l’agent fa più chiamate all’indice e ogni risposta aggiunge contesto da elaborare. È un costo da mettere in conto: in cambio si ottiene codice più vicino a Drupal moderno, che nel test alla cieca gli sviluppatori hanno preferito.
DRI è disponibile?
No. DRI è uno strumento interno di SparkFabrik e non è disponibile pubblicamente. Il principio su cui si basa, però, si può applicare anche ad altri progetti Drupal: dare all’agent esempi del proprio codice, regole d’uso degli strumenti scritte in modo esplicito e controlli statici sulla codebase.
Note e fonti
Luca Lusso, profilo su Drupal.org: https://www.drupal.org/u/lussoluca ↩︎
«Introduced in version: 11.1.0» (fonte: www.drupal.org/node/3442349) ↩︎
Search API Typesense, pagina del progetto su Drupal.org: https://www.drupal.org/project/search_api_typesense ↩︎
Fonte video
Questo articolo è basato sul video “Incorporare un decennio di esperienza Drupal nella memoria di un coding agent | Luca Lusso”.