Un parco software fatto di applicazioni monolitiche, rilasci manuali e server dimensionati sul picco di traffico rallenta ogni modifica e fa crescere i costi di manutenzione. Riprogettarlo secondo i principi Cloud Native, cioè container, servizi disaccoppiati e pipeline di rilascio automatizzate, riduce entrambi i problemi. Vediamo quando l’application modernization conviene e con quali strategie affrontarla.
Drupal 7 è arrivato a fine vita il 5 gennaio 2025, CentOS 7 il 30 giugno 2024, PHP 7.4 già a novembre 2022. Chi ha ancora applicazioni su questi stack ha due opzioni: pagare un supporto esteso a terzi oppure restare esposto a vulnerabilità che nessuno correggerà più. Spostarle così come sono su una VM in cloud non risolve il problema, lo sposta soltanto su un’altra fattura. Per ottenere dal Cloud l’elasticità e i tempi di rilascio per cui lo si adotta, è molto spesso necessario procedere all’application modernization. Con questo termine si intende l’intervento sul parco applicativo aziendale che rende le applicazioni performanti, funzionali e sicure sulle infrastrutture cloud, invece di limitarsi a ospitarle lì.
In questo articolo approfondiamo il tema della modernizzazione applicativa, analizzandone i benefici e le possibili modalità di attuazione.
Cosa si intende con application modernization
Per application modernization (chiamata anche legacy modernization) si intende un aggiornamento del software esistente predisponendolo agli approcci di sviluppo più recenti in termini di linguaggi, framework e infrastruttura. Le modifiche al codice, indipendentemente dalla loro profondità, sono volte all’ottimizzazione delle prestazioni e delle funzionalità all’interno della nuova architettura ormai quasi inderogabilmente in Cloud (le applicazioni moderne che restano on-premise o in ambienti edge, per requisiti di data residency, scelte di sovereign cloud o architetture Hybrid e Private Cloud, adottano comunque pattern Cloud Native, in genere su Kubernetes).
Si tratta comunque di un percorso che va affrontato caso per caso, in base alla tipologia di applicazioni, e in modo graduale. Per girare correttamente sulle infrastrutture Cloud, con risultati apprezzabili, non tutte le applicazioni tradizionali devono subire interventi massicci: in alcuni casi bastano poche modifiche mirate. Inoltre, il passaggio sul Cloud deve avvenire in modalità seamless, senza interferire con l’operatività e la continuità di servizio: meglio quindi procedere passo a passo, effettuando prima la migrazione e successivamente gli interventi di ottimizzazione.
Qualunque sia il settore, rimandare la modernizzazione delle applicazioni legacy ha costi che si possono misurare. Un framework fuori supporto, come AngularJS dopo dicembre 2021 o PHP 7.4 dopo novembre 2022, non riceve più patch di sicurezza. Ogni intervento di manutenzione richiede competenze sempre più rare e costose, e una modifica banale resta bloccata nel ciclo di rilascio del monolite per mesi. Scomporre l’applicazione in servizi che scalano, si aggiornano e si mettono in sicurezza in modo indipendente permette di passare da rilasci trimestrali a rilasci settimanali o giornalieri per singolo servizio.
Perché modernizzare le applicazioni legacy
Progettate per girare in ambienti tipicamente client-server, le applicazioni di tipo tradizionale vengono sviluppate ed eseguite secondo un approccio monolitico , come una singola unità che racchiude tutte le funzioni e interconnette strettamente i processi afferenti. Qualsiasi errore o modifica del codice influisce direttamente sul comportamento dell’intera applicazione, quindi ogni intervento richiede test approfonditi, aggiornamento completo del software, nuovo deployment; il risultato è, in molti casi, l’interruzione del servizio per un periodo più o meno prolungato.
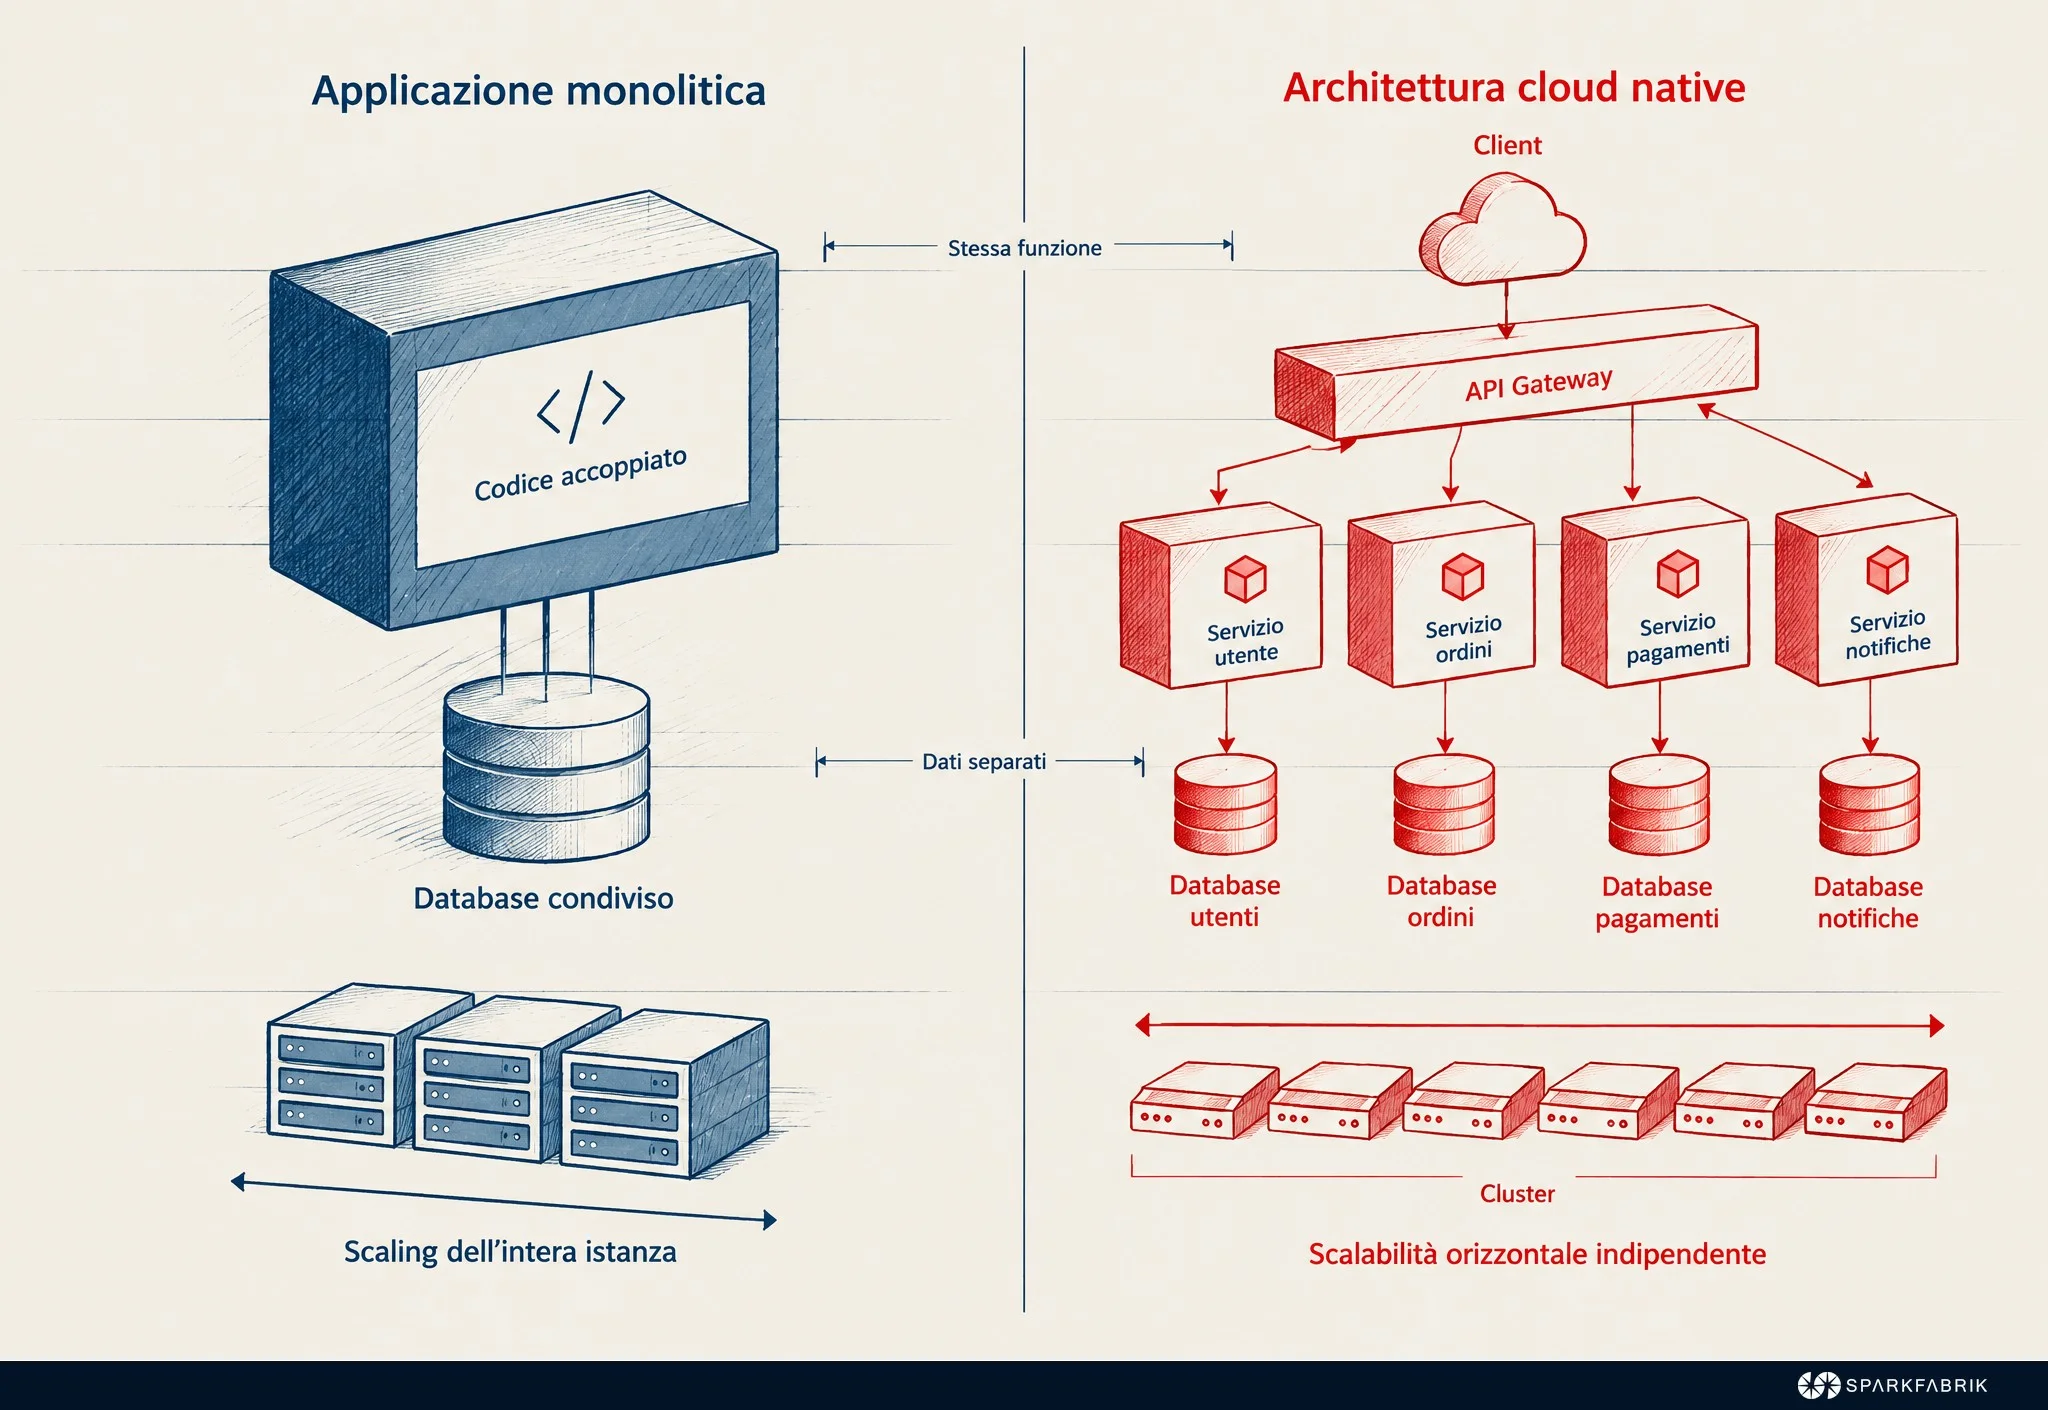
In un’applicazione monolitica cambiare framework, database o runtime è possibile, ma di solito richiede di intervenire sull’intero codice e di rilasciarlo in blocco, quindi viene rimandato. Il monolite ha anche una scalabilità ridotta: per reggere un picco su una sola funzione si replica tutta l’applicazione. Ogni nuova funzionalità tocca lo stesso codebase e allunga i tempi di test e rilascio. Lo sviluppo, infine, resta spesso concentrato in un unico fornitore o team.
Sul fronte dei costi il confronto con un’architettura moderna non è scontato. Le voci legate al monolite on-premise (licenze, hardware, manutenzione, personale dedicato al patching) possono scendere dopo la migrazione. Il risparmio però si concretizza solo se il consumo Cloud viene governato con rightsizing delle risorse e allocazione della spesa per servizio. Senza questa disciplina la bolletta può salire, come spieghiamo nella sezione dedicata ai costi Cloud e al FinOps.
Un’applicazione che richiede una finestra di fermo a ogni rilascio accumula le modifiche in pacchetti trimestrali: anche una correzione di sicurezza aspetta il prossimo slot di manutenzione insieme a tutto il resto. Quando lo stack sottostante esce dal supporto, come CentOS 7 a giugno 2024 o Drupal 7 a gennaio 2025, quell’attesa diventa esposizione. Restano due alternative: pagare a terzi un supporto esteso, un canone ricorrente che mantiene in vita l’applicazione senza renderla più rapida da modificare, oppure restare senza patch. Quanto costa, allora, lasciare il monolite com’è?
Portare il parco applicativo esistente verso un modello Cloud Native serve a rimuovere vincoli tecnici precisi. Un monolite che richiede una finestra di manutenzione a ogni rilascio, o che scala solo aggiungendo hardware, rende lento e costoso ogni nuovo requisito che il business mette sul tavolo.
L’application modernization permette invece di generare innovazione a vantaggio del business , riducendo al minimo i rischi: sostituire o ricostruire totalmente un’applicazione funzionante, che supporta una pluralità di processi, potrebbe rivelarsi pericoloso o comunque particolarmente oneroso. La modernizzazione invece procede per gradi, permettendo di tenere sotto controllo eventuali errori e di affrontare i costi di intervento in modo dilazionato.
L’application modernization consente infine il pieno passaggio al Cloud : in molti casi, se le soluzioni legacy possono girare sul Cloud, le infrastrutture on-premise sottostanti vengono migrate, con vantaggi in termini di ottimizzazione dei costi e aumento della flessibilità. Questo particolare approccio è chiamato rehosting e rappresenta il primo step di modernizzazione, come vedremo tra qualche paragrafo.
Perché la bolletta Cloud può salire dopo la modernizzazione
Il risparmio arriva solo se qualcuno governa il consumo. Un rehosting che copia 1:1 le macchine virtuali del data center porta in Cloud server dimensionati sul picco annuale e accesi 24 ore su 24, pagati a consumo invece che ammortizzati. Il passaggio ai microservizi aggiunge un secondo effetto: una sola applicazione diventa decine di servizi, ognuno con repliche, database, bilanciatori e ambienti di test propri. Le singole voci sono piccole, ma la somma sorprende chi aveva costruito il business case sul costo delle VM.
| Voce di costo | Perché cresce dopo la modernizzazione | Pratica FinOps |
|---|---|---|
| Compute | VM migrate con il sizing on-premise, requests Kubernetes (la CPU e la memoria che ogni pod si riserva sul nodo) gonfiate “per sicurezza” che bloccano nodi quasi vuoti | Rightsizing sulle metriche reali, Horizontal Pod Autoscaler (aggiunge o toglie repliche in base al carico), cluster autoscaler o Karpenter (provisioning automatico dei nodi) |
| Ambienti non produttivi | Dev, staging e preview per ogni servizio restano accesi di notte e nel weekend | Spegnimento programmato, ambienti effimeri con scadenza automatica |
| Traffico di rete | Chiamate tra servizi su availability zone diverse, egress verso Internet o altri provider | Topology-aware routing (instrada le chiamate verso istanze nella stessa zona), monitoraggio dell’egress per servizio |
| Servizi gestiti | Un database per microservizio moltiplica le istanze minime a pagamento | Istanze condivise negli ambienti non produttivi, tier serverless dove il carico è discontinuo |
| Observability | Log verbosi, metriche ad alta cardinalità (troppe combinazioni di etichette), tracing sul 100% delle richieste | Retention differenziata, sampling delle tracce, filtri in ingestione |
| Impegni di spesa | Reserved instance o savings plan (sconti in cambio di un impegno di spesa pluriennale) acquistati prima che il carico si stabilizzi | Acquisto solo dopo alcuni mesi di baseline misurata |
Il problema di fondo è l’allocazione: senza sapere quale team e quale servizio generano ogni euro, nessuno ha motivo di ottimizzare. Per questo applichiamo fin dalla prima migrazione una convenzione di tag e label obbligatoria (team, servizio, ambiente, centro di costo), verificata in CI. Nei cluster Kubernetes usiamo strumenti come OpenCost o Kubecost per ripartire il costo dei nodi condivisi sui singoli namespace. Su questa base si costruisce lo showback verso i team e, quando l’organizzazione è matura, il chargeback.
Il ciclo proposto dalla FinOps Foundation (Inform, Optimize, Operate)1 funziona se l’indicatore non è la spesa totale ma il costo unitario. Il costo per ordine, per utente attivo o per pagina servita può legittimamente crescere in valore assoluto quando il business cresce. Se però cresce anche il costo per transazione, qualcosa nell’architettura o nel dimensionamento va rivisto. Budget alert per servizio e una revisione mensile con sviluppatori e Operations chiudono il cerchio: chi scrive il codice vede l’effetto economico delle proprie scelte, per esempio un retry senza backoff o una query che scarica gigabyte fuori dalla region.

Come si modernizzano le applicazioni legacy, dai microservizi al DevOps?
Se i vantaggi della application modernization sono evidenti, non così scontate sono le tematiche correlate, le conoscenze necessarie e le metodologie per procedere correttamente.
Andando ad approfondire l’aspetto architetturale , le applicazioni moderne si contraddistinguono rispetto alle soluzioni monolitiche per la struttura a microservizi : ogni applicazione è concepita e sviluppata come un insieme di unità funzionali indipendenti, che possono essere aggiunte, eliminate o modificate singolarmente, senza influenzare il comportamento complessivo del sistema. I microservizi sono in carico a team specializzati, che possono intervenire autonomamente per effettuare le variazioni di competenza senza creare interruzioni o disservizi.
Nell’ambito delle architetture modulari, l’utilizzo delle API si rende necessario per favorire l’integrazione e l’interoperabilità dei diversi servizi, accelerando i tempi di sviluppo per l’aggiunta di ulteriori funzioni.
Sul piano dell’infrastruttura, le applicazioni moderne sfruttano i vantaggi della containerizzazione : sostanzialmente, le applicazioni o i microservizi girano all’interno di ambienti di runtime completi (container), assicurando il funzionamento indipendentemente dall’hardware sottostante e garantendo così la piena portabilità del software in ambienti ibridi e Multi Cloud. Grazie ad apposite piattaforme di orchestrazione (come Kubernetes, per citare la più nota soluzione open-source), i container possono essere gestiti in modo dinamico e automatizzato, ovviando all’inevitabile crescita della complessità.
Dal punto di vista dei processi, per cogliere tutte le opportunità delle applicazioni Cloud Native, il ricorso a metodologie Agile e pratiche DevOps risulta fondamentale. Le metodologie Agile suddividono il processo di sviluppo in sprint (blocchi di attività), secondo un approccio iterativo e incrementale. Ogni ciclo è finalizzato alla realizzazione di un incremento (una miglioria al software come la correzione di un bug o l’aggiunta di una funzionalità), che viene rilasciato e immediatamente testato dagli utenti per la raccolta dei feedback. Si procede così step-by-step fino alla release finale, con la possibilità di correggere il tiro in corso d’opera, garantendo l’allineamento con i desiderata del business.
Le pratiche DevOps invece favoriscono la collaborazione tra i team di sviluppo e le Operations, riducendo i tempi di deployment applicativo e automatizzando la gestione del ciclo di vita del software.
Chiariti i pilastri dell’approccio Cloud Native, il passaggio successivo è decidere cosa fare di ogni applicazione legacy. Il quadro di riferimento che adottiamo è il modello a 7 R, che prevede sette strategie. Retire dismette le applicazioni che non producono più valore. Retain lascia temporaneamente il sistema dov’è, perché la migrazione non conviene o non è ancora possibile. Relocate sposta i workload su un’altra infrastruttura senza toccare applicazione e sistema operativo, per esempio da VMware on-premise a VMware Cloud. Repurchase sostituisce il software con un prodotto SaaS equivalente. Rehost migra l’applicazione così com’è, con un approccio lift-and-shift. Replatform introduce modifiche mirate per sfruttare servizi gestiti. Refactor riprogetta l’applicazione in chiave Cloud Native.
In un portafoglio reale le sette strategie convivono: la stessa azienda può dismettere un gestionale obsoleto, trattenere un mainframe e riscrivere il frontend e-commerce. Retire, Retain, Relocate e Repurchase non richiedono di mettere mano al codice. Le tre R che comportano un intervento tecnico sull’applicazione sono invece queste, e vanno scelte in base al caso specifico, al budget e agli obiettivi:
il rehosting (spesso indicato come Lift & Shift) sposta l’applicazione in Cloud con modifiche nulle o minime al codice. Insieme al Relocate è l’opzione meno costosa nel breve periodo, ma l’applicazione resta monolitica e non sfrutta i servizi gestiti del provider;
il replatforming adatta l’applicazione al Cloud con interventi mirati che introducono tecniche di sviluppo moderne, senza toccarne l’architettura di fondo;
il refactoring riscrive l’applicazione, in parte o del tutto, secondo i framework Cloud Native, spesso scomponendola in microservizi: è l’intervento più oneroso ed è l’unico che permette di sfruttare pienamente il Cloud.
Il quadro completo, con sforzo, impatto sul codice, rischi e ritorno atteso per ciascuna delle sette strategie, è questo:
| Strategia | Sforzo | Impatto sul codice | Rischi principali | ROI |
|---|---|---|---|---|
| Relocate | Basso: spostamento a livello di hypervisor, per esempio con VMware Cloud on AWS | Nullo: le VM vengono spostate senza modifiche al sistema operativo o all’applicazione | Dipendenza dallo stack VMware e dai suoi costi di licenza, nessun accesso ai servizi Cloud nativi | Rapido: uscita dal data center in tempi brevi, ma il modello operativo resta quello on-premise |
| Rehost | Basso: settimane per applicazione | Nullo o minimo, l’applicazione resta monolitica | Bolletta Cloud superiore all’on-premise senza rightsizing, debito tecnico invariato | Rapido ma limitato: uscita dal data center e chiusura dei contratti hardware |
| Replatform | Medio | Interventi mirati: containerizzazione, configurazioni esternalizzate, database e code sostituiti da servizi gestiti | Incompatibilità di versione su database e driver, regressioni non coperte dai test | Medio: meno lavoro operativo su patching, backup e scaling |
| Refactor | Alto: mesi per modulo, anni per un monolite intero | Riscrittura parziale o completa verso microservizi | Durata del progetto, separazione del database condiviso, blocco delle nuove funzionalità se si procede “big bang” | Il più alto nel lungo periodo: rilasci indipendenti e scalabilità per singolo servizio |
| Repurchase | Basso sullo sviluppo, alto su migrazione dati e processi | Il codice viene sostituito da un prodotto SaaS | Lock-in sul fornitore, perdita delle personalizzazioni, migrazione dei dati storici | Elimina la manutenzione del software, ma introduce canoni ricorrenti |
| Retire | Basso | L’applicazione viene dismessa | Dipendenze nascoste (job batch, integrazioni punto a punto), obblighi di conservazione dei dati | Immediato: licenze e infrastruttura liberate |
| Retain | Nullo nell’immediato | Nessuno: l’applicazione resta on-premise per vincoli normativi o perché vicina a fine ciclo di vita | Costi del data center che restano in carico, decisione che diventa permanente senza una revisione periodica | Nessun beneficio diretto: la scelta va rivalutata a intervalli regolari, per esempio a ogni rinnovo hardware o contrattuale |
Le tre vie non sono alternative rigide: nella pratica la stessa applicazione le attraversa in sequenza. Si parte con un rehosting per uscire dal data center, si passa al replatforming quando si sostituiscono database e code di messaggi con i servizi gestiti del provider, e si arriva al refactoring solo per i moduli che cambiano spesso e che il monolite penalizza di più. Quel che va evitato è il “big bang”: riscrivere tutto in parallelo e commutare in un solo weekend. Nei progetti che abbiamo seguito, le riscritture integrali hanno una durata che si misura in anni, congelano le nuove funzionalità per tutto il periodo e arrivano in produzione quando i requisiti sono già cambiati.
Il refactoring incrementale ruota attorno allo Strangler Fig, il pattern descritto da Martin Fowler nel 2004. Il nome viene dal fico strangolatore, che cresce attorno all’albero ospite fino a prenderne il posto. Nel software lo schema è questo: davanti al monolite si mette una facade, di solito un reverse proxy o un API gateway, che riceve tutto il traffico. All’inizio la facade inoltra ogni richiesta al monolite. Quando una funzionalità viene riscritta come servizio autonomo, la facade sposta sul nuovo componente solo le rotte che la riguardano. Il monolite perde funzionalità una alla volta e si spegne quando non riceve più traffico. Il sistema resta sempre in produzione, e ogni passo si annulla riportando la rotta al vecchio codice.
Da solo, però, il pattern non basta. Il punto critico raramente è il codice: è il database condiviso, che nel diagramma resta collegato sia al monolite sia ai nuovi servizi. Attorno alla facade si combinano quindi altre tecniche, ognuna con un compito preciso.
| Tecnica | Problema che risolve | Quando usarla |
|---|---|---|
| Anti-corruption layer | Impedisce che il modello dati del legacy contamini i nuovi servizi | Quando il nuovo servizio deve leggere o scrivere sul monolite durante la transizione |
| Branch by abstraction | Sostituire un componente interno senza feature branch di lunga durata | Quando la funzionalità da estrarre non è raggiungibile dalla facade ma solo da chiamate interne |
| Parallel run | Verificare che il nuovo servizio produca gli stessi risultati del vecchio | Per logiche di calcolo critiche (pricing, fatturazione), confrontando gli output prima di commutare |
| Feature flag e canary release | Spostare il traffico per percentuali o per segmenti di utenti, con rollback immediato | Ad ogni commutazione di routing sulla facade |
| Change data capture | Tenere sincronizzato il database legacy con il datastore del nuovo servizio | Quando si separa una tabella dal database monolitico senza fermare le scritture |
Vale la pena sottolineare un vincolo pratico: ogni passo deve poter essere annullato entro pochi minuti, altrimenti l’incrementalità è solo apparente. Se estrarre un servizio richiede una migrazione dati irreversibile, l’ordine corretto è prima sincronizzare il datastore con change data capture, poi commutare le letture, infine le scritture, e solo alla fine rimuovere la tabella dal monolite.
Dove l’AI accelera il refactoring e dove no
In un refactoring legacy la parte lenta è capire il codice vecchio, non scrivere quello nuovo. Le regole di business stanno sepolte in migliaia di righe COBOL o in classi Java da cinquemila righe, senza documentazione e con gli autori originali ormai altrove. Su questa fase i modelli generativi e gli strumenti di code intelligence danno il contributo più concreto. Un LLM con accesso all’intero repository spiega cosa fa un job batch, ricostruisce il grafo delle chiamate tra moduli e indica quali tabelle tocca una transazione. Prima servivano settimane di lettura manuale e di interviste alle poche persone rimaste.
| Attività | Cosa fa bene l’AI | Dove serve verifica umana | Strumenti di esempio |
|---|---|---|---|
| Comprensione del codice | Riassume programmi e moduli, estrae regole di business, documenta dipendenze implicite | Le regole estratte vanno confermate da chi conosce il dominio: il modello descrive il codice, non l’intento | Assistenti LLM con contesto sull’intero repository, IBM watsonx Code Assistant for Z per COBOL |
| Test di caratterizzazione | Genera test unitari che fotografano il comportamento attuale, inclusi i casi limite | Verificare che i test controllino gli output reali e non si limitino a ripetere l’implementazione | GitHub Copilot, Amazon Q Developer |
| Upgrade tecnologici | Aggiorna versioni di Java e framework, sostituisce API deprecate | Revisione delle diff e build completa in CI | OpenRewrite (ricette deterministiche), Amazon Q Developer transformation |
| Individuazione dei confini dei servizi | Propone bounded context analizzando accoppiamento statico e tracce di esecuzione | La scelta finale dipende da team, dati condivisi e frequenza di cambiamento, non solo dal grafo delle classi | vFunction, analisi statica combinata con tracing |
| Conversione di linguaggio | Traduce COBOL o PL/I in Java mantenendo la logica | Semantica numerica, gestione degli errori, performance | Traduttori assistiti da LLM, sempre seguiti da parallel run |
La conversione di linguaggio è il caso che richiede più cautela. Una traduzione COBOL-Java riga per riga produce codice che compila ma resta procedurale, con la stessa struttura del monolite di partenza. È il cosiddetto “JOBOL”: il linguaggio cambia, l’architettura no. C’è poi un rischio meno visibile. COBOL lavora in aritmetica decimale a virgola fissa (i campi COMP-3), mentre una traduzione che usa double al posto di BigDecimal introduce errori di arrotondamento sugli importi. Questi errori emergono solo sui volumi di produzione. Per questo la tecnica del parallel run descritta sopra resta obbligatoria anche quando il codice è stato generato da un modello.
Quale strumento usare, e per cosa? Per le modifiche meccaniche su larga scala, come il passaggio da Java 8 a 17 o da Spring Boot 2 a 3, preferiamo ricette deterministiche tipo OpenRewrite. Producono lo stesso risultato a ogni esecuzione e generano diff revisionabili. Il modello generativo interviene sui casi che le ricette non coprono e sulla comprensione del codice, dove la variabilità dell’output non è un problema. L’ordine operativo segue la stessa logica dello Strangler Fig. Prima si generano e si rivedono i test di caratterizzazione, poi si refattorizza. In questo modo ogni modifica, umana o automatica, ha una rete di sicurezza misurabile.
C’è infine un vincolo di governance da chiarire prima di iniziare. Il codice legacy contiene logica di business proprietaria e, spesso, credenziali o dati di test reali. Prima di collegare un assistente AI al repository bisogna sapere dove viene inviato il codice. Bisogna anche sapere se il fornitore lo conserva o lo usa per l’addestramento, e se il contratto prevede la non retention oppure serve un modello ospitato in un ambiente proprio.
12Factor, le buone pratiche per sviluppare le modern application
Per semplificare il processo di application modernization e più in generale per guidare lo sviluppo di software Cloud Native, la 12Factor Methodology suggerisce una serie di buone pratiche che permettono di ottimizzare il comportamento delle applicazioni sul Cloud.
Il documento ufficiale chiarisce gli obiettivi principali della metodologia, orientata alla progettazione di applicazioni che:
sono replicabili sui diversi ambienti perché dichiarano e isolano esplicitamente tutte le dipendenze (fattore II, Dependencies) e mantengono sviluppo, staging e produzione il più simili possibile (fattore X, Dev/prod parity). È l’antidoto al classico “in test funzionava”. La metodologia, pubblicata nel 2011 da Adam Wiggins, allora in Heroku, precede la diffusione dei container, ma chi applica questi principi si ritrova con un’applicazione che si containerizza senza forzature;
separano nettamente la base di codice dalle configurazioni (fattore III, Config): credenziali, endpoint e parametri specifici di ogni ambiente stanno in variabili d’ambiente, non in file di properties versionati o valori hardcoded. Nel legacy capita spesso il contrario, e cambiare database significa ricompilare e rilasciare;
scalano orizzontalmente, aggiungendo processi identici, perché adottano un modello stateless (fattore VI, Processes): nessun processo conta su memoria o file-system locali tra una richiesta e l’altra, e sessioni e file caricati finiscono in servizi di supporto come Redis o un object storage. Nel monolite tipico sono proprio le sessioni sticky e gli upload su disco locale a impedire l’aggiunta di un secondo nodo;
si avviano e si arrestano in pochi secondi (fattore IX, Disposability): gestiscono lo shutdown in modo pulito e ripartono senza procedure manuali. Deploy frequenti e autoscaling lo richiedono, e un application server che può impiegare minuti a partire non lo garantisce;
trattano i log come flussi di eventi scritti su stdout (fattore XI, Logs) e lasciano all’infrastruttura la raccolta e l’instradamento verso gli strumenti di osservabilità, al posto di file ruotati sul server da leggere via SSH. Insieme agli altri fattori, questo avvicina team di Development e Operations e rende sostenibili pipeline di Continuous Integration e Continuous Delivery.
Seguire i 12 principi per la progettazione delle modern application significa partire con il piede giusto per innovare il parco applicativo aziendale, tagliando sui costi di gestione IT e restituendo al business i vantaggi attesi, tra cui flessibilità strategica, continuità operativa, velocità nella delivery dei servizi.
Organizzare la modernizzazione e le competenze necessarie
Per modernizzare le applicazioni servono cinque competenze: sviluppo Cloud Native (microservizi, container, API), gestione di Kubernetes in produzione, pratiche DevOps con pipeline CI/CD automatizzate, change management per accompagnare i team nel nuovo modello operativo e FinOps per tenere sotto controllo i costi cloud. Vanno organizzate in team cross-funzionali; quelle che mancano in casa si integrano con un partner esterno.
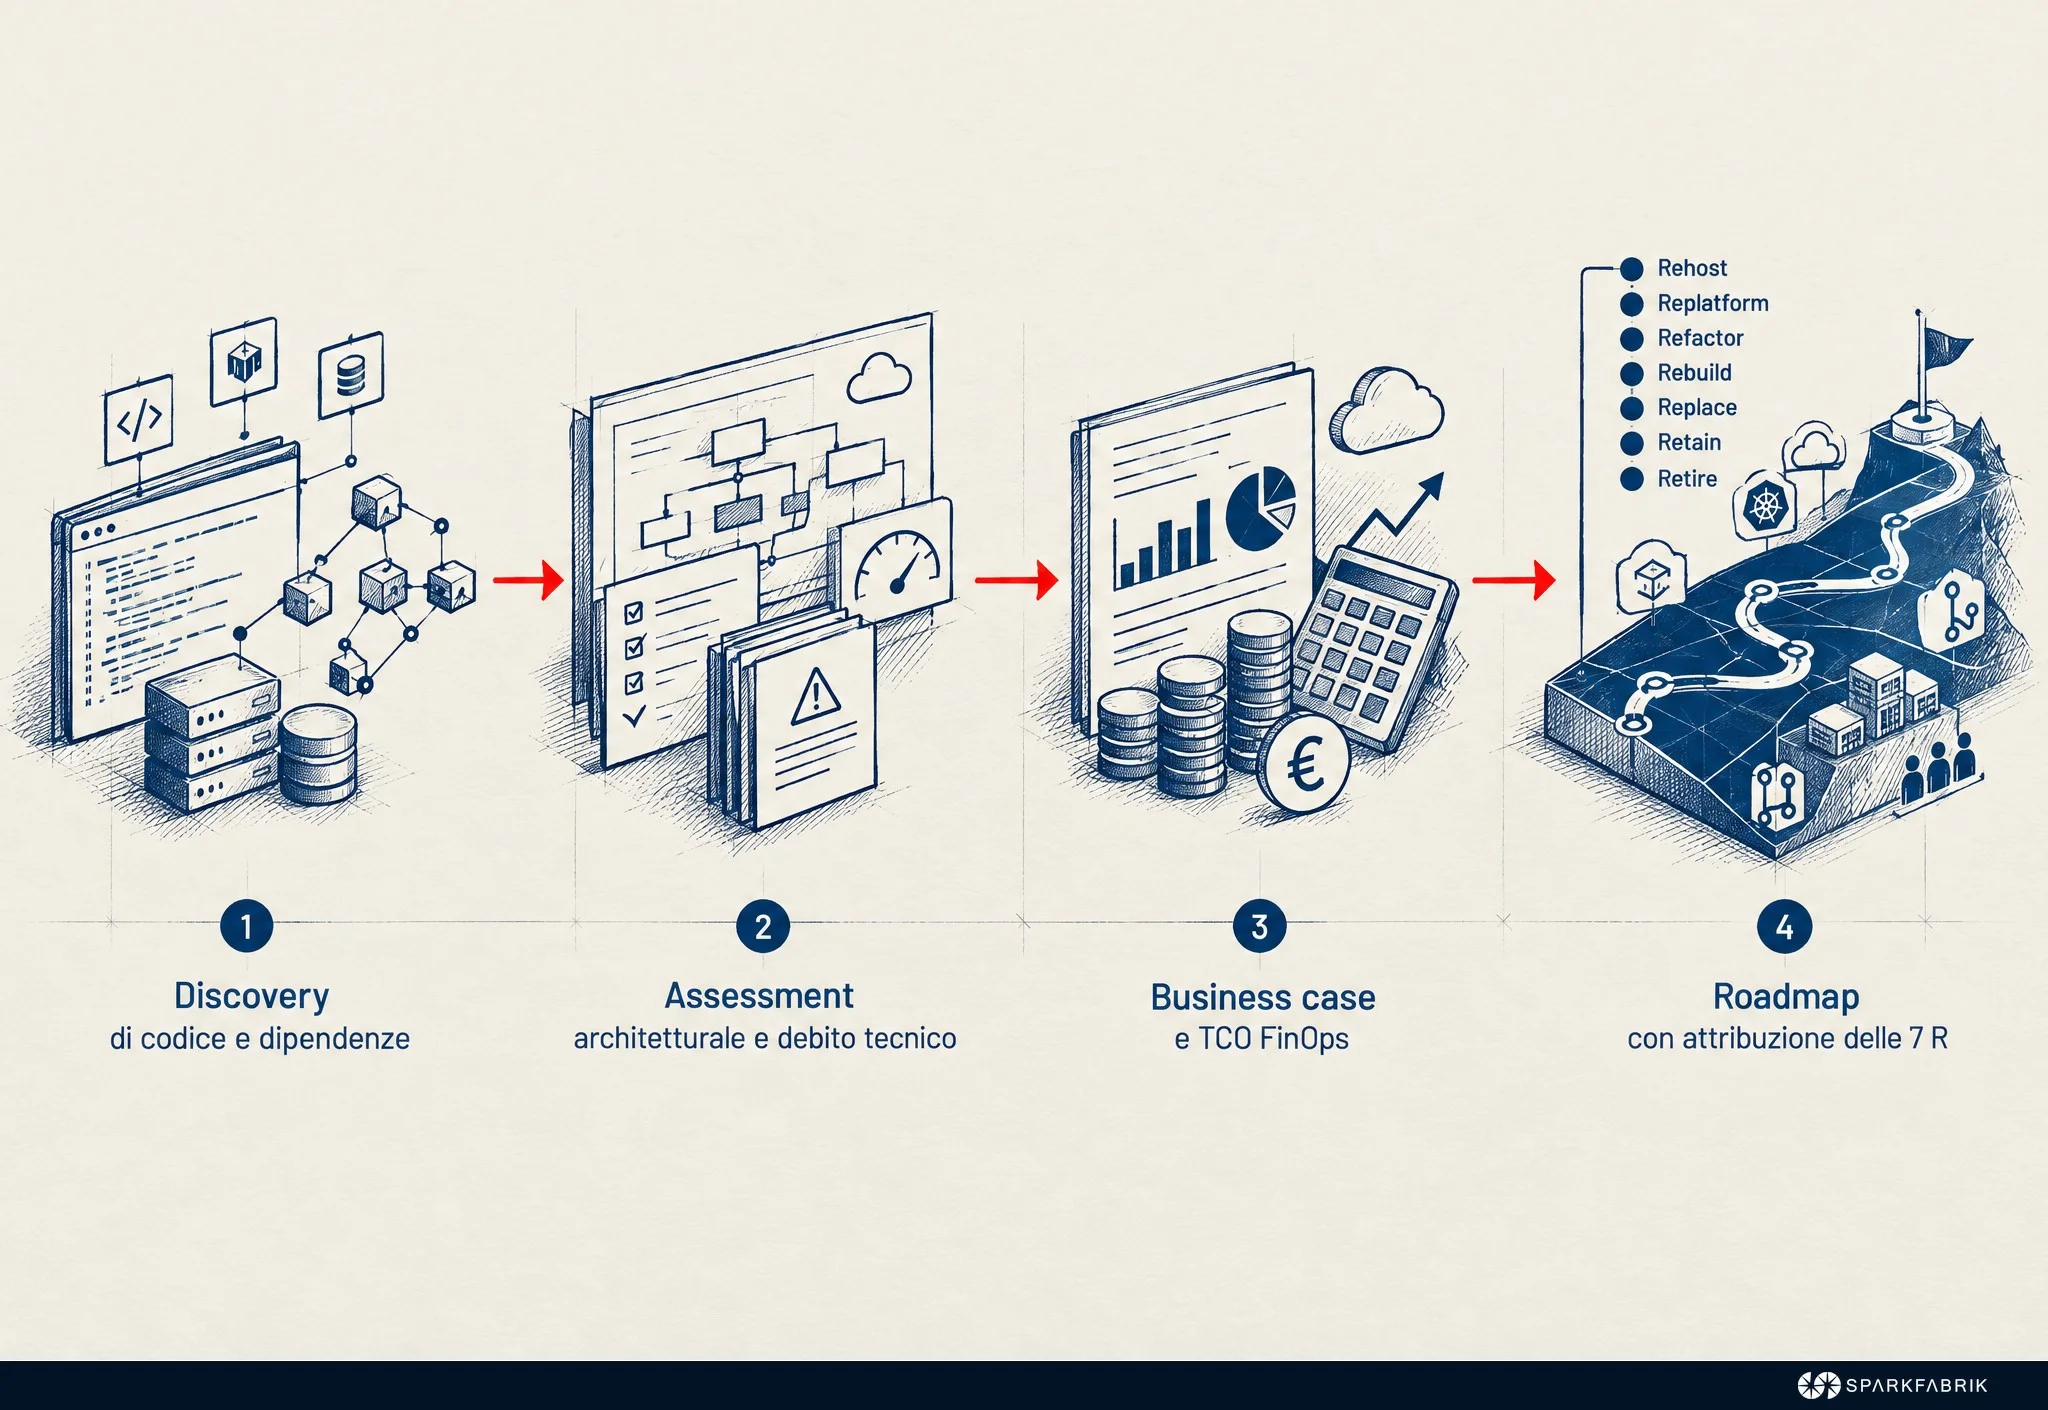
Rispetto a una riscrittura integrale “big bang”, una modernizzazione incrementale riduce il rischio perché l’applicazione resta in produzione e ogni passo si può annullare, come nel pattern Strangler Fig. Richiede però conoscenze tecnologiche e metodologiche precise, dal disegno dei confini tra i moduli a una pipeline di rilascio abbastanza solida da passare da rilasci trimestrali a settimanali.
Innanzitutto, bisogna avere un’ottima padronanza delle tecniche di sviluppo Cloud Native , con un focus particolare su architetture a microservizi, utilizzo delle API, container e piattaforme di orchestrazione. Inoltre, servono solide competenze in materia di metodologie Agili e pratiche DevOps, quindi occorrono opportune capacità di change management.
Adottando i nuovi framework per la gestione del ciclo di vita del software, infatti, l’organizzazione del lavoro cambia in modo misurabile: si passa da rilasci trimestrali a rilasci settimanali o giornalieri per singolo servizio, gestiti da team multidisciplinari che lavorano in parallelo su obiettivi comuni. Per sostenere questo ritmo, i Developers raccolgono i feedback direttamente dagli utenti finali e si coordinano con chi gestisce le Operations, così che ogni rilascio alimenti il successivo.
L’expertise in progetti analoghi di application modernization decide l’esito dell’iniziativa. Dall’analisi del parco applicativo esistente bisogna saper assegnare a ciascuna applicazione una delle 7 R (retire, retain, rehost, relocate, replatform, repurchase, refactor) e stabilire l’ordine degli interventi in base a dipendenze, valore di business e rischio. Il risultato deve essere una roadmap che fa evolvere il portfolio per ondate successive: prima le applicazioni che liberano risorse o sbloccano le altre, poi quelle che richiedono un refactoring profondo per sfruttare servizi Cloud nativi.
Il successo di un progetto di application modernization richiede competenze tecniche, visione strategica ed esperienza pregressa, ma oggi passa anche da un ingaggio strutturato in fasi. Si parte dalla discovery del parco software, sempre più automatizzata. Segue l’assessment del codice legacy, delle dipendenze e del debito tecnico, le cui fasi sono dettagliate più sotto nella tabella “Come si struttura un assessment”. Su questa base si arriva alla definizione del business case con pratiche FinOps per governare i costi Cloud fin dalla prima migrazione, mentre il refactoring assistito da AI supporta l’analisi e la riscrittura del codice legacy. Affidarsi a partner referenziati che hanno già portato workload legacy su Kubernetes evita al team interno la curva di apprendimento sulla prima migrazione e permette di costruire in parallelo test di caratterizzazione e piattaforma.
Chi porta avanti il progetto pesa quanto la strategia scelta: la stessa migrazione ha rischi e tempi diversi se la esegue un team che conosce già il codice legacy oppure un gruppo che deve prima ricostruirne la logica. Il diagramma seguente riporta i criteri con cui decidiamo, caso per caso, quando conviene coinvolgere servizi esterni di legacy application modernization e quando il team interno ha competenze e disponibilità sufficienti per procedere da solo.
Come si struttura un assessment di modernizzazione
Un assessment serio non parte dalla tecnologia di destinazione, ma dall’inventario di ciò che esiste. Nei progetti che seguiamo, il perimetro reale è quasi sempre più ampio di quanto il cliente stimi: applicazioni dimenticate, job batch schedulati su server che nessuno presidia, integrazioni punto a punto mai documentate. Per questo la prima fase si affida a strumenti di discovery automatica che analizzano codice, dipendenze e traffico di rete, prima di qualsiasi intervista ai team.
| Fase | Attività principali | Output |
|---|---|---|
| Discovery | Scansione automatica del codice, mappa delle dipendenze, inventario di database e integrazioni | Catalogo applicativo con dati di utilizzo reali |
| Assessment architetturale | Analisi del monolite, individuazione dei bounded context, misura del debito tecnico (copertura dei test, framework fuori supporto, grado di accoppiamento) | Punteggio di complessità e rischio per ogni applicazione |
| Business case e TCO | Confronto tra costi correnti (licenze, hardware, manutenzione) e costi Cloud stimati, con pratiche FinOps per governare il consumo | Stima del TCO a 3-5 anni e ordine di priorità |
| Roadmap | Assegnazione di una delle 7 R a ciascuna applicazione e sequenza dei rilasci | Piano graduale con milestone verificabili |
Per le applicazioni destinate al refactoring, la roadmap raramente prevede una riscrittura totale in un unico rilascio. Il percorso è quello incrementale dello Strangler Fig visto sopra, e il compito dell’assessment è stabilire l’ordine di estrazione. Da dove cominciare? Dal modulo con meno dipendenze e la frequenza di rilascio più alta, perché è lì che il monolite costa di più in downtime e test. Un primo servizio con pochi legami verso il resto del codice permette inoltre di collaudare facade, pipeline e monitoraggio senza toccare il nucleo dell’applicazione.
Esempi virtuosi di application modernization
Mettendo sul piatto della bilancia opportunità e sfide dell’application modernization, non stupisce che molte aziende abbiano già intrapreso percorsi virtuosi per innovare il portafoglio software.
Molte aziende nate su Internet hanno smontato i propri monoliti prima che i principi Cloud Native avessero un nome. Twitter, oggi X, ha avviato nel 2009 il passaggio da Ruby a un nuovo stack e lo ha completato nell’aprile 2011, annunciando di operare su Blender, un server Java2. Netflix ha seguito un percorso analogo sul fronte infrastrutturale: nel gennaio 2016 ha completato la migrazione dei propri servizi dai data center proprietari ad AWS. La modernizzazione però non riguarda solo le aziende nate con il web. Anche in Italia ci sono casi riusciti che coinvolgono aziende storiche di settori tradizionali.
Ad esempio, la società farmaceutica Zambon ha finalizzato un progetto per il replatforming e il redesigning dei siti aziendali (Corporate, versioni internazionali, di prodotto), arrivando a costruire un’infrastruttura Multi Cloud.
Un esempio di migrazione che va oltre il semplice rehost è ilGiornale.it: la testata ha affidato a SparkFabrik la governance del proprio Cloud e l’evoluzione della piattaforma CMS in ottica Cloud Native. Rientra nelle strategie di refactor e re-architect: il CMS viene ripensato per sfruttare i servizi cloud, invece di essere spostato così com’è su nuove macchine.
Da dove si comincia a modernizzare le applicazioni legacy?
Il primo passo concreto è un assessment del parco applicativo. Fate un inventario con discovery automatica delle dipendenze, assegnate a ogni applicazione una delle 7 R e stabilite le priorità in base a tre criteri misurabili: costo di manutenzione, esposizione a vulnerabilità e tempo di rilascio.
Un framework uscito dalla manutenzione, per esempio, vi obbliga a scegliere tra il supporto esteso a pagamento e patch di sicurezza che non arriveranno più.
Quel costo, messo accanto allo sforzo di migrazione, dice subito quale applicazione affrontare per prima.
Se volete impostare questo lavoro con noi, il servizio di Application Modernization di SparkFabrik parte proprio dall’assessment. Per portare le stesse scelte al livello della strategia IT potete consultare la guida per CIO al cloud native.
Domande Frequenti
Cos’è l’application modernization e perché è necessaria?
L’application modernization è l’aggiornamento del software legacy per adattarlo agli approcci di sviluppo Cloud Native. È necessaria perché le applicazioni monolitiche hanno scalabilità limitata, causano interruzioni di servizio e non soddisfano le esigenze di flessibilità e velocità del business digitale.
Quali sono i tre approcci per modernizzare le applicazioni legacy?
Il modello a 7 R nasce dalle 5 R proposte da Gartner nel 2010 (Rehost, Refactor, Revise, Rebuild, Replace). AWS lo ha poi rielaborato in 6 R e infine esteso a 7 aggiungendo Relocate; oggi è formalizzato nella AWS Prescriptive Guidance. Le sette strategie sono Rehost, Relocate, Replatform, Refactor, Repurchase, Retain e Retire. Se l’applicazione va spostata e anche modificata, i percorsi tecnici sono tre:
rehosting (Lift & Shift): porta l’applicazione in Cloud con modifiche minime;
replatforming: interviene su componenti mirati per sfruttare i servizi Cloud;
refactoring (o rearchitect): riscrive l’applicazione in parte o del tutto secondo i principi Cloud Native.
Le altre quattro R rispondono a esigenze diverse. Relocate sposta interi ambienti virtualizzati senza toccare le applicazioni. Repurchase sostituisce il software con un prodotto SaaS. Retain lascia il sistema on-premise, mentre Retire lo dismette.
Cosa sono i microservizi e perché sono importanti nella modernizzazione applicativa?
I microservizi sono unità funzionali indipendenti che compongono un’applicazione. Ciascuno ha il proprio codice, il proprio ciclo di rilascio e spesso il proprio datastore, e comunica con gli altri tramite API. Grazie a questo disaccoppiamento, un team autonomo può sviluppare, testare e portare in produzione un singolo servizio senza ridistribuire né fermare l’intera applicazione, cosa impossibile con un monolite.
Cos’è la metodologia 12Factor e a cosa serve?
La 12Factor Methodology è un insieme di buone pratiche per sviluppare applicazioni Cloud Native. Guida la progettazione di applicazioni replicabili tra ambienti diversi, con separazione tra codice e configurazioni, capacità di scalare orizzontalmente aggiungendo processi identici, approccio stateless e collaborazione DevOps.
Cosa includono i servizi professionali di application modernization e quando servono?
Coprono l’assessment del portfolio applicativo, l’assegnazione a ogni applicazione di una delle 7 R (rehost, relocate, replatform, refactor, repurchase, retain, retire), la migrazione incrementale, le pipeline CI/CD e l’osservabilità. Servono quando il team interno non ha esperienza con container, Kubernetes e architetture cloud native, oppure quando il sistema legacy rallenta i rilasci e blocca la roadmap di prodotto.
Quali competenze servono per fare application modernization?
Servono competenze in sviluppo Cloud Native (microservizi, API, container, Kubernetes), metodologie Agili e pratiche DevOps, e capacità di change management. L’esperienza in progetti analoghi è fondamentale per scegliere il metodo corretto tra rehosting, replatforming e refactoring.
Note e fonti
Il ciclo proposto dalla FinOps Foundation (Inform, Optimize, Operate): «FinOps is performed by working iteratively on the Framework Capabilities through three phases: Inform, Optimize and Operate.» (fonte: https://www.finops.org/framework/phases/) ↩︎
(Twitter, oggi X, ha iniziato a scomporre il suo monolite Ruby on Rails in servizi JVM a partire dal 2010), f…: «In 2009, they began the complex process of switching from Ruby to JavaScript. This switch was finally completed in April 2011, when the company announced they were now operating from a Java server called Blender.» (fonte: https://www.bairesdev.com/blog/twitter-tech-stack/) ↩︎